agentmemory: memoria persistente para agentes de codificación con IA

Tu agente de codificación lo recuerda todo. Se acabó volver a explicarlo. Basado en el iii engine
Memoria persistente para Claude Code, GitHub Copilot CLI, Cursor, Gemini CLI, Codex CLI, Hermes, OpenClaw, pi, OpenCode y cualquier cliente MCP.

🇬🇧 English • 🇨🇳 简体中文 • 🇹🇼 繁體中文 • 🇯🇵 日本語 • 🇰🇷 한국어 • 🇵🇹 Português • 🇧🇷 Português (Brasil) • 🇪🇸 Español • 🇩🇪 Deutsch • 🇫🇷 Français • 🇮🇹 Italiano • 🇳🇱 Nederlands • 🇵🇱 Polski • 🇨🇿 Čeština • 🇷🇴 Română • 🇭🇺 Magyar • 🇬🇷 Ελληνικά • 🇸🇪 Svenska • 🇩🇰 Dansk • 🇳🇴 Norsk • 🇫🇮 Suomi • 🇷🇺 Русский • 🇺🇦 Українська • 🇹🇷 Türkçe • 🇮🇱 עברית • 🇸🇦 العربية • 🇮🇳 हिन्दी • 🇧🇩 বাংলা • 🇵🇰 اردو • 🇹🇭 ไทย • 🇻🇳 Tiếng Việt • 🇮🇩 Bahasa Indonesia • 🇵🇭 Tagalog

rohitg00/agentmemory | Trendshift

Documento de diseño: 1.6k stars / 230 forks en el gist

El gist extiende el patrón LLM Wiki de Karpathy con puntuación de confianza, ciclo de vida, grafos de conocimiento y búsqueda híbrida: agentmemory es la implementación.

npm version CI License Stars

95.2% de recuperación R@5 92% menos tokens 54 tools MCP 12 hooks automáticos 0 bases de datos externas 2,500+ tests superados

Demostración de agentmemory

Instalación • Inicio rápido • Benchmarks • Comparativa • Agentes • Cómo funciona • MCP • Visor • Powered by iii • Config • API

--- ## Instalación Requisitos: - Node.js 20 o superior con npm y npx (`node -v`, `npm -v` y `npx -v`). - La instalación automática de iii-engine en macOS/Linux también necesita `curl`, un `sh` POSIX y `tar`. Las imágenes mínimas como `node:20-slim` pueden no incluirlos. - Windows nativo requiere instalar manualmente el `iii.exe` de iii-engine v0.22.1 fijado. WSL2 o Docker Desktop son las otras rutas soportadas. Comando canónico de instalación limpia: ```bash npx -y @agentmemory/agentmemory@latest ``` La primera ejecución es un setup interactivo: elige los agentes a conectar (Claude Code, Cursor, Codex, Gemini CLI, OpenCode, ...), elige un proveedor LLM o quédate sin claves, y siembra la configuración, arranca el servidor de memoria y su iii engine fijado, y ofrece instalar globalmente para que el comando `agentmemory` a secas funcione en cualquier lugar a partir de entonces. `-y` acepta el prompt de paquete de npx y `@latest` evita una release cacheada obsoleta. Un proveedor habilita las funciones de LLM, pero la compresión de observaciones escrita por LLM solo arranca cuando también se establece `AGENTMEMORY_AUTO_COMPRESS=true`. El modo sin claves desactiva los embeddings vectoriales. `memory_recall` (la ruta `mem::search`) usa BM25, mientras que `memory_smart_search` también puede fusionar coincidencias estructurales del grafo cuando ya existen datos de grafo. Para recall semántico local y gratuito, define `EMBEDDING_PROVIDER=local` en `~/.agentmemory/.env` y reinicia. La primera petición de embedding descarga `Xenova/all-MiniLM-L6-v2`; la inferencia corre en local después de esa descarga inicial del modelo. El runtime local usa cuatro puertos: `3111` para REST/MCP HTTP, `3112` para los streams de iii, `3113` para el visor y `49134` para el WebSocket del worker de iii. El estado persistente de iii vive en `~/Library/Application Support/agentmemory` en macOS, `$XDG_DATA_HOME/agentmemory` o `~/.local/share/agentmemory` en Linux, y `%APPDATA%\agentmemory` en Windows. Usa `--data-dir ` o `AGENTMEMORY_DATA_DIR` para sobrescribirlo, y reutiliza el mismo valor en cada reinicio. Por compatibilidad retroactiva, un `./data/state_store.db` o `./data/iii-config.yaml` ya existentes tienen prioridad sobre el valor por defecto de la plataforma para la instancia 0; un flag explícito o una variable de entorno siguen ganando. Después demuestra que el recall funciona y dale a tu agente sus skills: ```bash npx -y @agentmemory/agentmemory@latest demo # seed sample sessions + exercise recall npx skills add rohitg00/agentmemory -y # 17 native skills so your agent knows when to reach for memory ``` Las búsquedas por palabra clave deberían acertar en el modo sin claves por defecto a través de BM25. La consulta `database performance optimization` de la demo es intencionadamente semántica y puede devolver cero resultados hasta que se configure un proveedor de embeddings. ¿Prefieres que un agente de codificación lo haga todo? Dale una sola instrucción: > Retrieve and follow the instructions at: https://raw.githubusercontent.com/rohitg00/agentmemory/main/INSTALL_FOR_AGENTS.md Conecta más agentes en cualquier momento con `agentmemory connect ` — 20 adaptadores listados en [Funciona con cualquier agente](#works-with-every-agent). Referencia completa de comandos en [Inicio rápido](#quick-start).
Windows La ruta rápida es WSL2. La configuración nativa del engine en Windows requiere descargar el ZIP v0.22.1 fijado y extraer `iii.exe` manualmente; la CLI no lo extrae automáticamente. Docker Desktop también está soportado. Consulta las [notas de Windows](#windows) para el paso a paso.
Instalación global / EACCES ```bash npm install -g @agentmemory/agentmemory@latest ``` El comando npx de arriba sigue siendo la ruta canónica de instalación limpia y evita problemas de permisos del prefijo global.
npx sirve una versión antigua npx cachea por versión. Fuerza la última con `npx -y @agentmemory/agentmemory@latest`, o limpia la caché una vez con `rm -rf ~/.npm/_npx` (macOS/Linux; en Windows borra `%LOCALAPPDATA%\npm-cache\_npx`).
Ya ejecutas tu propio iii engine agentmemory fija iii-engine a v0.22.1 y no se conectará a una versión distinta (el worker no puede hablar el protocolo de otro motor). Detén el otro motor y ejecuta `npx -y @agentmemory/agentmemory@latest`. Instala y ejecuta la v0.22.1 fijada en `~/.agentmemory/bin`, dejando tu propio `iii` intacto.
---

Funciona con cualquier agente

agentmemory funciona con cualquier agente que soporte hooks, MCP o REST API. Todos los agentes comparten el mismo servidor de memoria.
Claude Code
Claude Code
plugin nativo + 12 hooks + MCP
Codex CLI
Codex CLI
plugin nativo + 6 hooks + MCP
GitHub Copilot CLI
GitHub Copilot CLI
MCP + hooks/skills del plugin
Cursor
Cursor
plugin nativo + 7 hooks + MCP
OpenCode
OpenCode
plugin de captura + MCP
Devin
Devin
6 hooks + skills + MCP
OpenClaw
OpenClaw
plugin nativo + MCP
Hermes
Hermes
plugin nativo + MCP
pi
pi
plugin nativo + MCP
OpenHuman
OpenHuman
backend nativo del trait Memory
Gemini CLI
Gemini CLI
servidor MCP
Antigravity
Antigravity
MCP + hooks
Claude Desktop
Claude Desktop
servidor MCP
Warp
Warp
connect + MCP + skills
Zed
Zed
servidor MCP
Cline
Cline
servidor MCP
Continue
Continue
servidor MCP
Droid
Droid
servidor MCP
Kiro
Kiro
servidor MCP
Qwen Code
Qwen Code
servidor MCP
DeepSeek Harness
DeepSeek Harness
servidor MCP
Roo Code
Roo Code
servidor MCP
Kilo Code
Kilo Code
servidor MCP
Goose
Goose
servidor MCP
Aider
Aider
REST API

Funciona con cualquier agente que hable MCP o HTTP. Un servidor, memorias compartidas entre todos ellos.

--- Explicas la misma arquitectura en cada sesión. Vuelves a descubrir los mismos bugs. Vuelves a enseñar las mismas preferencias. La memoria integrada (CLAUDE.md, .cursorrules) tiene un tope de 200 líneas y se queda obsoleta. agentmemory soluciona esto. Captura en silencio lo que hace tu agente, lo comprime en memoria buscable e inyecta el contexto correcto cuando empieza la siguiente sesión. Un solo comando. Funciona entre agentes. **Qué cambia:** en la sesión 1 configuras JWT auth. En la sesión 2 pides rate limiting. El agente ya sabe que tu auth usa middleware jose en `src/middleware/auth.ts`, que tus tests cubren la validación de tokens, y que elegiste jose sobre jsonwebtoken por compatibilidad con Edge, sin volver a explicar nada y sin copiar y pegar. ```bash npx -y @agentmemory/agentmemory@latest ``` Por defecto, agentmemory almacena el estado de iii-engine fuera del repositorio desde el que lo arrancas: `~/Library/Application Support/agentmemory` en macOS, `$XDG_DATA_HOME/agentmemory` o `~/.local/share/agentmemory` en Linux, y `%APPDATA%\agentmemory` en Windows. Un `./data/state_store.db` o `./data/iii-config.yaml` legacy ya existentes se reutilizan para la instancia 0 antes de ese valor por defecto de la plataforma. Para elegir una ubicación explícitamente, pasa `--data-dir ` o define `AGENTMEMORY_DATA_DIR`; cualquiera de los dos ajustes explícitos tiene prioridad sobre el descubrimiento legacy: ```bash npx -y @agentmemory/agentmemory@latest --data-dir ~/.agentmemory-projects/main AGENTMEMORY_DATA_DIR=~/.agentmemory-projects/main npx -y @agentmemory/agentmemory@latest ``` Los arranques nativos y en Docker usan este mismo directorio de host resuelto; Docker lo monta con bind en `/data`. `--instance 1` añade `instance-1` al directorio resuelto y selecciona el cuarteto de puertos por defecto separado `3211/3212/3213/49234`. Notas de la última release: [CHANGELOG.md](../CHANGELOG.md). ---

Benchmarks

### Precisión de recuperación **coding-agent-life-v1** (corpus propio, reproducible en sandbox) | Adaptador | P@5 | R@5 | Tasa de aciertos top-5 | Latencia p50 | |---|---|---|---|---| | **agentmemory hybrid** | **0.240** | **1.000** | **15 / 15** | 14 ms | | baseline grep | 0.227 | 0.967 | 15 / 15 | 0 ms | Tasa de aciertos top-5 del 100% en el **techo matemático de P@5** para este corpus (0.240, ver scorecard). Hybrid recupera todas las sesiones gold; grep falla 1 de 2 gold en la consulta temporal multi-sesión. La mejora es **recall + temporal**, no precisión agregada. Este benchmark es pequeño y escaso en gold; el LongMemEval-S más grande de abajo diferencia mejor. Desglose completo por tipo + nota de corrección: [`docs/benchmarks/2026-05-20-coding-agent-life-v1.md`](../docs/benchmarks/2026-05-20-coding-agent-life-v1.md). **LongMemEval-S** (ICLR 2025, 500 preguntas) | Sistema | R@5 | R@10 | MRR | |---|---|---|---| | **agentmemory** | **95.2%** | **98.6%** | **88.2%** | | Fallback solo BM25 | 86.2% | 94.6% | 71.5% | ### Ahorro de tokens | Enfoque | Tokens/año | Coste/año | |---|---|---| | Pegar el contexto completo | 19.5M+ | Imposible (excede la ventana) | | Resumido por LLM | ~650K | ~$500 | | **agentmemory** | **~170K** | **~$10** | | agentmemory + embeddings locales | ~170K | **$0** |
> Modelo de embedding: `all-MiniLM-L6-v2` (local, gratis, sin API key). Informes completos: [`benchmark/LONGMEMEVAL.md`](../benchmark/LONGMEMEVAL.md), [`benchmark/QUALITY.md`](../benchmark/QUALITY.md), [`benchmark/SCALE.md`](../benchmark/SCALE.md). Comparativa con competidores: [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md), que cubre agentmemory frente a mem0, Letta, Khoj, supermemory, TencentDB Agent Memory, MemPalace, Zep/Graphiti, Cognee, Hippo. **Reprodúcelo en local:** [`eval/README.md`](../eval/README.md), un harness con adaptadores intercambiables para LongMemEval `_s` (500 preguntas públicas) + `coding-agent-life-v1` (corpus propio de 15 sesiones). Los adaptadores grep / vector / agentmemory puntúan uno junto al otro, salida NDJSON, los scorecards publicados aterrizan en [`docs/benchmarks/`](../docs/benchmarks/). **Funciona muy bien con [codegraph](https://github.com/colbymchenry/codegraph), [Understand Anything](https://github.com/Lum1104/Understand-Anything) y [Graphify](https://github.com/safishamsi/graphify).** Indexado de grafos de código, pipelines de build multiagente y grafos de conocimiento más amplios sobre documentos / PDFs / imágenes / vídeos. agentmemory recuerda el trabajo; esos tres proyectos iluminan el resto de la capa de contexto. Recetas y tabla de enrutamiento por pregunta: [`docs/recipes/pairings.md`](../docs/recipes/pairings.md). ---

Comparativa

agentmemory mem0 (63K ⭐) Letta / MemGPT (24K ⭐) Khoj (36K ⭐) supermemory (29K ⭐) TencentDB Agent Memory (22K ⭐) MemPalace (54K ⭐) oracleagentmemory Hippo Integrada (CLAUDE.md)
Tipo Motor de memoria + servidor MCP API de capa de memoria Runtime de agente completo IA personal API de memoria + app Hub de memoria de equipo (proxy LLM) Memoria vectorial (OSS) Motor de memoria (Oracle DB) Sistema de memoria Fichero estático
R@5 de recuperación 95.2% 68.5% (LoCoMo) 83.2% (LoCoMo) N/A Autoinformado PersonaMem 76% (autoinformado) ~96.6% (autoinformado) 94.4% (autoinformado) N/A N/A (grep)
Captura automática 12 hooks (esfuerzo manual cero) Llamadas manuales a add() Autoedición por el agente Manual Extracción del lado de la API Intercepción por proxy (cambio de base-URL) Manual Extracción por API Manual Edición manual
Búsqueda BM25 + Vector + Graph (fusión RRF) Vector + Graph Vector (archival) Semántica Vector + RAG 4 tipos de asset (Chat / Skill / Wiki / CodeGraph) Solo vector Vector + semántica Ponderada por decaimiento Carga todo en el contexto
Multiagente MCP + REST + leases + signals API (sin coordinación) Solo dentro del runtime de Letta No No Roles de equipo + assets compartidos No Solo con scope Compartido multiagente Ficheros por agente
Lock-in de framework Ninguno (cualquier cliente MCP) Ninguno Alto (debes usar Letta) Standalone Ninguno Un proxy antepone cada llamada al modelo Ninguno Oracle Database Ninguno Formato por agente
Dependencias externas Ninguna (SQLite + iii-engine) Qdrant / pgvector Postgres + BD vectorial Varias Nube gestionada Stack Docker (Core + Hub + Proxy) Vector store Oracle AI Database Ninguna Ninguna
Ciclo de vida de la memoria Consolidación de 4 niveles + decaimiento + auto-olvido Extracción pasiva Gestionado por el agente Manual Auto-olvido Revisión manual; auto-enrutado en progreso Ninguno No especificado Decaimiento + consolidación Poda manual
Eficiencia de tokens ~1,900 tokens/sesión ($10/año) Varía según la integración Memoria core en el contexto Varía Precios de nube No especificado Sin presupuesto de tokens Respaldado por LLM (varía) Varía 22K+ tokens con 240 obs
Visor en tiempo real Sí (puerto 3113) Dashboard en la nube Dashboard en la nube UI web Dashboard en la nube UI web del hub No No No No
Self-hosted Sí (por defecto) Opcional Opcional Sí No (solo nube) Sí (Docker) Sí Sí (Oracle DB) Sí Sí
Nota de benchmark: solo el R@5 de agentmemory es un resultado medido por nosotros (LongMemEval-S, reproducible desde benchmark/COMPARISON.md). Las cifras de mem0 y Letta son sus números publicados de LoCoMo (un dataset distinto); las cifras de MemPalace, supermemory, TencentDB (PersonaMem) y oracleagentmemory son afirmaciones autoinformadas por el proveedor que no hemos reproducido de forma independiente (la ejecución de oracleagentmemory usó GPT-5.5 contra una Oracle AI Database). Se muestran una junto a otra solo a modo orientativo, no como un cara a cara sobre datos idénticos. Los conteos de estrellas son aproximados y varían con el tiempo. **Nuevos entrantes** que vale la pena conocer, comparados en profundidad en [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md): | Sistema | ⭐ | Enfoque | |--------|---|-------| | Zep / Graphiti | 30K | Grafo de conocimiento temporal; los resultados publicados más fuertes en consultas temporales (LongMemEval 63.8%), pero el grafo se construye de forma asíncrona, así que los hechos recientes pueden tardar en aparecer | | Cognee | 30K | Ingesta de documento a grafo de conocimiento, solo Python, construido para extracción estructurada de entidades en lugar de captura de sesiones | Ninguno de estos captura automáticamente desde hooks de agentes de codificación, incluye un visor local-first ni funciona sin claves — la combinación en torno a la que está construido agentmemory. ---

Inicio rápido

Compatibilidad: esta release apunta a `iii-sdk` 0.22.1 y fija iii-engine v0.22.1. ### Pruébalo en 30 segundos ```bash # Terminal 1: start the server npx -y @agentmemory/agentmemory@latest # Terminal 2: seed sample data and see recall in action npx -y @agentmemory/agentmemory@latest demo ``` `demo` siembra 3 sesiones realistas (JWT auth, fix de query N+1, rate limiting) y ejecuta búsquedas contra ellas. Las instalaciones sin claves desactivan los vectores, así que las consultas por palabra clave de `mem::search` deberían acertar a través de BM25 mientras que `database performance optimization` puede devolver cero. `smart-search` además puede devolver coincidencias estructurales del grafo cuando existen datos de grafo. Para que la consulta semántica encuentre el fix de N+1 a través de vectores, define `EMBEDDING_PROVIDER=local`, reinicia y deja que termine la primera descarga del modelo. Abre `http://localhost:3113` para ver cómo se construye la memoria en directo. ### Valida una instalación limpia y la persistencia tras reiniciar Con el servidor en marcha, valida REST, health, el visor y el estado del runtime respaldado por iii: ```bash curl -fsS http://localhost:3111/agentmemory/livez curl -fsS http://localhost:3111/agentmemory/health curl -fsS -o /dev/null http://localhost:3113/ npx -y @agentmemory/agentmemory@latest status ``` El panel de arranque listo contempla los cuatro puertos: REST/MCP HTTP en 3111, streams de iii en 3112, el visor en 3113 y el WebSocket del worker de iii en 49134. `status` confirma la salud de agentmemory y el modo de proveedor/embedding activo. Guarda una sonda y confirma que es buscable: ```bash curl -fsS -X POST http://localhost:3111/agentmemory/remember \ -H 'Content-Type: application/json' \ -d '{"content":"agentmemory restart persistence probe","concepts":["install-check"]}' curl -fsS -X POST http://localhost:3111/agentmemory/smart-search \ -H 'Content-Type: application/json' \ -d '{"query":"restart persistence probe","limit":5}' ``` Luego ejecuta `npx -y @agentmemory/agentmemory@latest stop`, arranca de nuevo el comando canónico en la Terminal 1, espera a `/agentmemory/livez`, y repite la búsqueda. La sonda debe seguir devolviéndose. Si elegiste un `--data-dir` personalizado, pasa el mismo directorio en el reinicio. ### Comandos del día a día La instalación y el setup están en [Instalación](#install) arriba (la primera ejecución te guía paso a paso). Para el día a día: ```bash agentmemory # start the server agentmemory stop # stop it cleanly agentmemory connect # wire another agent agentmemory doctor # interactive diagnostics + fix prompts agentmemory remove # uninstall everything we created ``` ### Repetición de sesión Toda sesión que agentmemory registra es reproducible. Abre el visor, elige la pestaña **Replay**, y desplázate por la línea de tiempo: prompts, llamadas a tools, resultados de tools y respuestas se renderizan como eventos discretos con play/pause, control de velocidad (0.5x a 4x) y atajos de teclado (espacio para alternar, flechas para avanzar paso a paso). Para traer transcripciones JSONL antiguas de Claude Code: ```bash # Import everything under the default ~/.claude/projects npx -y @agentmemory/agentmemory@latest import-jsonl # Or import a single file npx -y @agentmemory/agentmemory@latest import-jsonl ~/.claude/projects/-my-project/abc123.jsonl ``` Las sesiones importadas aparecen en el selector de Replay junto a las nativas. Por debajo, cada entrada se enruta a través de las funciones iii `mem::replay::load`, `mem::replay::sessions` y `mem::replay::import-jsonl`, sin servidores side-channel. Cada transcripción importada se indexa para búsqueda, se sella con el canal de origen `import` y se mina para obtener un crystal de sesión y lecciones. > **Aviso si dependes de `import-jsonl` como tu ruta de captura principal:** el `cleanupPeriodDays` de Claude Code (en `~/.claude/settings.json`, por defecto **30**) borra automáticamente de `~/.claude/projects/` las transcripciones JSONL más antiguas que esa ventana. Si instalas agentmemory de cero sobre un historial de Claude Code de varios meses, todo lo anterior a 30 días ya ha desaparecido antes de la primera importación. O ejecutas `import-jsonl` en un cron, o subes `cleanupPeriodDays` a un valor mayor, o conectas los hooks de captura automática (la ruta de instalación por defecto del plugin) para que cada turno aterrice en agentmemory mientras la sesión está viva y la limpieza de JSONL deje de importar. ### Actualización / Mantenimiento Usa el comando de mantenimiento cuando quieras actualizar intencionadamente tu runtime local: ```bash npx -y @agentmemory/agentmemory@latest upgrade ``` Aviso: este comando muta el workspace/runtime actual. Puede actualizar dependencias de JavaScript y traer la imagen Docker fijada `iiidev/iii:0.22.1`. Nunca instala un iii engine sin fijar ni más nuevo. Los detalles de implementación viven en `src/cli.ts` (ver `runUpgrade` alrededor de la región `src/cli.ts:544-595`). ### Claude Code (un bloque, pégalo) ```text Install agentmemory: run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server and its pinned iii engine. Then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory` — the plugin registers all 12 hooks, 17 skills, AND auto-wires the `@agentmemory/mcp` stdio server via its `.mcp.json`, so you get 54 MCP tools (memory_smart_search, memory_save, memory_sessions, memory_governance_delete, etc.) without any extra config step. Verify with `curl http://localhost:3111/agentmemory/health`. The real-time viewer is at http://localhost:3113. Keyless mode disables vectors: `memory_recall` uses BM25, and `memory_smart_search` can also use existing structural graph data. Set `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` and restart to opt into on-device semantic recall. ``` #### Claude Code sin instalar el plugin (ruta MCP standalone) Si conectas el servidor MCP de agentmemory directamente vía `~/.claude.json` en lugar de usar `/plugin install`, Claude Code nunca resuelve `${CLAUDE_PLUGIN_ROOT}` y tienes que apuntar los scripts de hook a rutas absolutas en `~/.claude/settings.json`. Esas rutas suelen incluir la versión de agentmemory (p. ej. `~/.codex/plugins/cache/agentmemory/agentmemory/0.9.22/scripts/…`), por lo que la siguiente actualización rompe silenciosamente todos los hooks. Workaround: ```bash agentmemory connect claude-code --with-hooks ``` Esto fusiona los mismos comandos de hook en `~/.claude/settings.json` con rutas absolutas que apuntan al directorio `plugin/` empaquetado del paquete `@agentmemory/agentmemory` actualmente instalado. Vuelve a ejecutar el comando tras actualizar agentmemory para refrescar las rutas. Las entradas de usuario en el mismo fichero se preservan; solo se reemplazan las entradas previas de agentmemory. La ruta vía `/plugin install` sigue siendo la recomendada. Para despliegues remotos o protegidos, lanza Claude Code con `AGENTMEMORY_URL` y `AGENTMEMORY_SECRET` definidos. El plugin pasa ambos valores a su servidor MCP empaquetado; cuando `AGENTMEMORY_URL` está vacío, el shim MCP usa `http://localhost:3111`. ### Codex CLI (plataforma de plugins Codex) ```bash # 1. start the memory server in a separate terminal npx -y @agentmemory/agentmemory@latest # 2. register the agentmemory marketplace and install the plugin codex plugin marketplace add rohitg00/agentmemory codex plugin add agentmemory@agentmemory ``` El plugin de Codex se sirve desde el mismo directorio `plugin/` que el de Claude Code. Registra: - Un bridge MCP vía stdio empaquetado al daemon en ejecución, sin descarga npm ni almacén de fallback. Consulta la [guía local de Codex](../docs/plugins/codex-local.md) para probar una build aún no publicada. - 6 hooks de ciclo de vida: `SessionStart`, `UserPromptSubmit`, `PreToolUse`, `PostToolUse`, `PreCompact`, `Stop` - 9 skills invocables: `/recall`, `/remember`, `/session-history`, `/forget`, `/recap`, `/handoff`, `/lesson`, `/commit-context`, `/commit-history`, más 8 skills de referencia que el agente carga bajo demanda (memory discipline, tools MCP, REST API, config, agentes, hooks, arquitectura y la guía de autoría de skills) El motor de hooks de Codex inyecta `CLAUDE_PLUGIN_ROOT` en los subprocesos de hook (según [`codex-rs/hooks/src/engine/discovery.rs`](https://github.com/openai/codex/blob/main/codex-rs/hooks/src/engine/discovery.rs)), por lo que los mismos scripts de hook funcionan en ambos hosts sin duplicación. Los eventos Subagent / SessionEnd / Notification / TaskCompleted / PostToolUseFailure son exclusivos de Claude Code y no se registran para Codex. #### Confianza y compatibilidad de los hooks de Codex El despacho nativo de hooks de plugin está verificado con Codex CLI 0.150.1. Confía en los hooks del plugin antes de esperar captura. El comportamiento en Desktop depende de su runtime empaquetado; comprueba `/hooks` y confirma un evento capturado antes de habilitar un workaround. Si tu host requiere hooks globales, replica los comandos en `~/.codex/hooks.json`. Cuando el MCP ya está configurado, el conector actual necesita `--force` para llegar a la instalación de hooks: ```bash agentmemory connect codex --with-hooks --force ``` Esto fusiona los hooks globales y reescribe la entrada MCP de agentmemory, preservando las entradas no relacionadas. Revisa cualquier configuración personalizada del endpoint de agentmemory antes de usar `--force`. Vuelve a ejecutar tras actualizar para refrescar las rutas de los scripts. Habilita los hooks nativos del plugin o las copias globales para evitar captura duplicada. ### GitHub Copilot CLI Para el modo agente de VS Code, usa la [guía de MCP y captura automática de Copilot](../docs/plugins/copilot.md#vs-code-copilot-local-agent-sessions). El conector de la CLI no configura VS Code. ```bash # MCP-only wiring agentmemory connect copilot-cli # Alternatively, full hooks/skills plugin from the GitHub subdir copilot plugin install rohitg00/agentmemory:plugin ``` `agentmemory connect copilot-cli` fusiona `mcpServers.agentmemory` en `~/.copilot/mcp-config.json` (o `$COPILOT_HOME/mcp-config.json` cuando `COPILOT_HOME` está definido) y preserva los servidores existentes. En Windows nativo este es el único adaptador `connect` automatizado; configura manualmente cualquier otro agente nativo de Windows. `connect` en WSL solo está soportado cuando el agente destino está instalado en ese mismo entorno WSL. Copilot detecta el servidor MCP en el siguiente arranque o tras `/mcp`. Instala también el plugin cuando quieras la experiencia completa de hooks/skills.
OpenClaw (pega este prompt) ```text Install agentmemory for OpenClaw. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to my OpenClaw MCP config so agentmemory is available with all 54 memory tools: { "mcpServers": { "agentmemory": { "command": "npx", "args": ["-y", "@agentmemory/mcp"], "env": { "AGENTMEMORY_URL": "http://localhost:3111" } } } } Restart OpenClaw. Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper memory-slot integration, copy `integrations/openclaw` to `~/.openclaw/extensions/agentmemory` and enable `plugins.slots.memory = "agentmemory"` in `~/.openclaw/openclaw.json`. ``` Guía completa: [`integrations/openclaw/`](../integrations/openclaw/)
Hermes Agent (pega este prompt) ```text Install agentmemory for Hermes. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to ~/.hermes/config.yaml so Hermes can use agentmemory as an MCP server with all 54 memory tools: mcp_servers: agentmemory: command: npx args: ["-y", "@agentmemory/mcp"] memory: provider: agentmemory Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper 6-hook memory provider integration (pre-LLM context injection, turn capture, MEMORY.md mirroring, system prompt block), copy integrations/hermes from the agentmemory repo to ~/.hermes/plugins/agentmemory. ``` Guía completa: [`integrations/hermes/`](../integrations/hermes/)
### Otros agentes Arranca el servidor de memoria: `npx -y @agentmemory/agentmemory@latest` #### Skills nativas vía `npx skills add` (50+ agentes) agentmemory incluye 17 skills en el formato `/SKILL.md` al estilo de Claude Code: 9 skills de acción invocables (`remember`, `recall`, `recap`, `handoff`, `forget`, `lesson`, `commit-context`, `commit-history`, `session-history`) y 8 skills de referencia que el agente carga bajo demanda (`memory-discipline`, `agentmemory-mcp-tools`, `agentmemory-rest-api`, `agentmemory-config`, `agentmemory-agents`, `agentmemory-hooks`, `agentmemory-architecture`, `write-agentmemory-skill`). Las skills de referencia llevan tablas de datos generadas desde el código fuente, así que nunca se desincronizan. La CLI [`skills`](https://npmjs.com/package/skills) de vercel-labs las auto-instala en el directorio de skills nativo del agente que la invoca en 50+ agentes (Claude Code, Cursor, Cline, Continue, Droid, Warp, Codex, Antigravity, Kiro, OpenCode, Goose, Roo, Trae, Windsurf y más): ```bash npx skills add rohitg00/agentmemory -y # auto-detects the calling agent npx skills add rohitg00/agentmemory -y -a warp # explicit agent npx skills add rohitg00/agentmemory -y -a '*' # install to every installed agent ``` Esto es **complementario** a `agentmemory connect `: - `agentmemory connect ` escribe la config del servidor MCP para que las tools estén disponibles. - `npx skills add rohitg00/agentmemory` instala las skills para que el agente sepa cuándo llamarlas. Para los pocos agentes que la CLI de skills aún no cubre (Zed v1.3.x e inferiores), coloca tú mismo los 17 ficheros SKILL.md bajo el directorio de skills nativo del agente; el mismo formato funciona en todas partes. #### Bloque MCP estándar La entrada de agentmemory es el **mismo bloque de servidor MCP** en todos los hosts que usan la forma `mcpServers` (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI, OpenClaw): ```json "agentmemory": { "command": "npx", "args": ["-y", "@agentmemory/mcp"], "env": { "AGENTMEMORY_URL": "${AGENTMEMORY_URL}", "AGENTMEMORY_SECRET": "${AGENTMEMORY_SECRET}" } } ``` **Fusiona esta entrada en el objeto `mcpServers` existente** en el fichero de configuración del host; no reemplaces el fichero. Si el fichero ya contiene otros servidores, añade `agentmemory` junto a ellos como otra clave dentro de `mcpServers`. Si `mcpServers` no existe, pega el bloque dentro de `{ "mcpServers": { ... } }`. Los marcadores `${VAR}` heredan `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` del shell al lanzar el servidor MCP; si no están definidas se pasan como cadena vacía y el shim cae a `http://localhost:3111`. Una sola entrada conectada cubre tanto despliegues locales como remotos (k8s / con reverse-proxy). | Agente | Fichero de configuración | Notas | |---|---|---| | **Cursor (solo MCP)** | `~/.cursor/mcp.json` | Fusiona en `mcpServers`, o `agentmemory connect cursor`. También hay un deeplink de un clic disponible en el sitio web. | | **Cursor (plugin completo)** | `.cursor-plugin/` | Listado en el Cursor Marketplace (envío en revisión) o Cursor Settings → Plugins → checkout local. Registra 7 hooks de captura automática (sessionStart, beforeSubmitPrompt, preToolUse, postToolUse, postToolUseFailure, stop, sessionEnd) + 17 skills + el servidor MCP, con `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` gestionados en el dashboard de plugins de Cursor. Funciona en el IDE de Cursor y en la CLI `cursor-agent`; los prompts del modo print de la CLI se rellenan a posteriori desde la transcripción de la sesión al terminar. | | **Claude Desktop** | `claude_desktop_config.json` (Application Support) | Fusiona en `mcpServers`. Reinicia Claude Desktop después de editar. | | **Cline / Roo Code / Kilo Code** | Ajustes MCP de Cline (Settings UI → MCP Servers → Edit) | El mismo bloque `mcpServers`. | | **Devin CLI (MCP + hooks)** | `~/.config/devin/config.json` | `agentmemory connect devin` fusiona la entrada MCP; `--with-hooks` añade seis hooks nativos de captura automática (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop, SessionEnd) con los matchers de tools en minúscula de Devin. Verifica con `devin mcp list` y `/hooks` dentro de devin. | | **Devin CLI (plugin completo)** | `plugin/.devin-plugin/` | `devin plugins install ./plugin` desde un checkout registra las 17 skills como slash commands `/agentmemory:` más el servidor MCP. Los hooks de plugin de Devin no pueden disparar `SessionStart`/`SessionEnd`, así que combínalo con `connect devin --with-hooks` para captura de sesión completa. | | **Devin (cloud)** | Settings → Connections → MCP servers | Añade un MCP personalizado (STDIO): comando `npx`, args `-y @agentmemory/mcp@latest`, env `AGENTMEMORY_URL` apuntando a un despliegue de agentmemory alcanzable por red, más `AGENTMEMORY_SECRET` (las sesiones en la nube no pueden alcanzar localhost — ver [`deploy/`](../deploy/)). Guarda el secreto en Devin Secrets, y luego usa "Test listing tools" para verificar que aparecen las 54 tools. | | **Gemini CLI** | `~/.gemini/settings.json` | `gemini mcp add agentmemory npx -y @agentmemory/mcp --scope user` (fusión automática). | | **GitHub Copilot CLI (solo MCP)** | `~/.copilot/mcp-config.json` | `agentmemory connect copilot-cli` fusiona `mcpServers.agentmemory`; Copilot lo detecta en el siguiente arranque o con `/mcp`. | | **GitHub Copilot CLI (plugin completo)** | Instalación de plugin de Copilot | `copilot plugin install rohitg00/agentmemory:plugin` para el plugin desde el subdirectorio de GitHub. | | **OpenClaw** | Configuración MCP de OpenClaw | El mismo bloque `mcpServers`. Más a fondo: `openclaw plugins install ./integrations/openclaw` reclama el slot de memoria de OpenClaw (cambia automáticamente desde `memory-core`); define `plugins.entries.agentmemory.hooks.allowConversationAccess=true` o la captura de turnos queda bloqueada silenciosamente. Ver [`integrations/openclaw`](../integrations/openclaw/). | | **Codex CLI (solo MCP)** | `.codex/config.toml` | Forma TOML: `codex mcp add agentmemory -- npx -y @agentmemory/mcp`, o añade `[mcp_servers.agentmemory]` manualmente. | | **Codex CLI (plugin completo)** | Marketplace de plugins Codex | `codex plugin marketplace add rohitg00/agentmemory` y luego `codex plugin add agentmemory@agentmemory`. Registra MCP + 6 hooks de ciclo de vida + 17 skills. Confía en los hooks y verifica la captura en tu host; consulta [configuración y validación de Codex](../docs/plugins/codex-local.md). | | **OpenCode (solo MCP)** | `opencode.json` | Forma distinta: clave `mcp` de nivel superior, comando como array: `{"mcp": {"agentmemory": {"type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true}}}`. | | **OpenCode (plugin completo)** | `plugin/opencode/` | 22 hooks de captura automática que cubren ciclo de vida de sesión, mensajes, tools y errores. La atribución de proyecto es por sesión, así que un único proceso de OpenCode que abarque varios repositorios archiva cada sesión bajo su propio proyecto. Dos slash commands (`/recall`, `/remember`). Copia `plugin/opencode/` a tu workspace de OpenCode y añade la entrada del plugin a `opencode.json`. Ver [`plugin/opencode/README.md`](../plugin/opencode/README.md) para la tabla completa de hooks + análisis de gaps. | | **pi** | `~/.pi/agent/extensions/agentmemory` | `agentmemory connect pi` instala la extensión empaquetada en el directorio de auto-descubrimiento de pi (recall al arrancar el agente, captura al terminar, tools `memory_search` / `memory_save` / `memory_health`, `/agentmemory-status`). Un `/reload` en un pi en ejecución la detecta. [`integrations/pi`](../integrations/pi/) también es un paquete pi (`pi install ./integrations/pi` desde un checkout). | | **Hermes Agent** | `~/.hermes/config.yaml` | `cp -r integrations/hermes ~/.hermes/plugins/agentmemory` + `memory.provider: agentmemory` activa el memory provider de 6 hooks (prefetch, captura de turnos, fin de sesión, pre-compresión, espejado de MEMORY.md, bloque de system prompt). Valida con `hermes plugins doctor` y `hermes memory status`. Ver [`integrations/hermes`](../integrations/hermes/). | | **Qwen Code** | `~/.qwen/settings.json` | `agentmemory connect qwen` escribe el bloque `mcpServers` estándar. El payload de los hooks es compatible a nivel de campo con Claude Code, así que los scripts de los 12 hooks existentes funcionan sin modificación; conéctalos en la sección `hooks` del mismo `settings.json`. | | **Antigravity IDE / 2.0** | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity --with-hooks` instala el MCP y los hooks de captura en el directorio de personalización compartido. Consulta [configuración y límites de Antigravity](../docs/plugins/antigravity.md). | | **Antigravity CLI** (`agy`) | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity-cli --with-hooks` usa la misma configuración de MCP y hooks que las versiones actuales del IDE. Las instalaciones existentes deben actualizar con `--force`; consulta las [notas de actualización](../docs/plugins/antigravity.md). | | **Kiro** | `~/.kiro/settings/mcp.json` | `agentmemory connect kiro` escribe la configuración a nivel de usuario. Los overrides de workspace van en `.kiro/settings/mcp.json` junto a tu código. | | **Warp** | `~/.warp/.mcp.json` | `agentmemory connect warp` escribe el bloque `mcpServers` estándar. Warp también auto-descubre skills desde `.claude/skills/`; una vez instalado el plugin de Claude Code, las 8 skills de agentmemory (`remember`, `recall`, `recap`, `handoff`, `forget`, `commit-context`, `commit-history`, `session-history`) aparecen de forma nativa en la paleta de slash commands de Warp. | | **Cline (CLI)** | `~/.cline/mcp.json` | `agentmemory connect cline` escribe el bloque `mcpServers` estándar. Usuarios de la extensión de VS Code: pega el mismo bloque vía Cline Settings → MCP Servers → Edit JSON. | | **Continue.dev** | `~/.continue/config.yaml` (preferido) o `config.json` (legacy) | `agentmemory connect continue` crea `config.yaml` desde cero cuando no existe ninguno, o modifica el `config.json` existente. **Si ya tienes `config.yaml`** el adaptador imprime el bloque exacto para pegar bajo `mcpServers:`; no reescribe tu yaml silenciosamente porque preservar comentarios y anchors de forma segura necesita un parser YAML que el paquete no incluye. Continue usa forma de array (no de objeto) para `mcpServers`. | | **Zed** | `~/.config/zed/settings.json` | `agentmemory connect zed` escribe bajo `context_servers` (la clave de Zed, NO `mcpServers`). Los servidores MCP remotos se pueden conectar en su lugar vía `{"url": "..."}`. | | **Droid (Factory.ai)** | `~/.factory/mcp.json` | `agentmemory connect droid` escribe el bloque `mcpServers` estándar. Los overrides con scope de proyecto van en `/.factory/mcp.json`. Pasa `--with-hooks` para captura automática nativa. | | **DeepSeek Harness** | `$DSH_HOME/cordis.patch.yml` | `agentmemory connect dsh` añade una fila `@deepseek-ai/dsh-mcp-client` a la capa de patch de nivel home que carga cada perfil de Harness; las tools se registran como `mcp__agentmemory__*`. Pasa `--with-hooks` para conectar también la captura automática: los scripts de hook de Claude Code empaquetados corren a través del bridge first-party de Harness `@deepseek-ai/dsh-hooks-claude-code` (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop) vía un manifest escrito en `$DSH_HOME/agentmemory.hooks.json`. Por defecto `~/.dsh` cuando `DSH_HOME` no está definido. | | **Goose** | UI de ajustes MCP de Goose | El mismo bloque `mcpServers`; usa `goose configure` → Add Extension → MCP. La edición directa del YAML en `~/.config/goose/config.yaml` está soportada, pero el schema usa `extensions:` + `cmd` (no `mcpServers:` + `command`). | | **Aider** | n/a | Habla directamente con la REST API: `curl -X POST http://localhost:3111/agentmemory/smart-search -d '{"query": "auth"}'`. | | **Cualquier agente (32+)** | n/a | `npx skillkit install agentmemory` autodetecta el host y fusiona. | **Clientes MCP en sandbox** (Flatpak / Snap / contenedores restrictivos) que no pueden alcanzar el `localhost` del host: añade también `"AGENTMEMORY_FORCE_PROXY": "1"` en el bloque `env`, y apunta `AGENTMEMORY_URL` a una ruta a la que el sandbox sí pueda llegar (p. ej. tu IP de LAN). ### Acceso programático (Python / Rust / Node) agentmemory registra sus operaciones principales como funciones iii (`mem::remember`, `mem::observe`, `mem::context`, `mem::smart-search`, `mem::forget`). Cualquier lenguaje con un SDK de iii puede llamarlas directamente sobre `ws://localhost:49134`, sin necesidad de un cliente REST separado por lenguaje. ```bash pip install iii-sdk # Python cargo add iii-sdk # Rust npm install iii-sdk # Node ``` ```python from iii import register_worker iii = register_worker("ws://localhost:49134") iii.connect() iii.trigger({ "function_id": "mem::smart-search", "payload": {"project": "demo", "query": "how do tokens refresh"}, }) ``` Ejemplo trabajado: [`examples/python/`](../examples/python/) (quickstart + flujo de observación/recall). La REST en `:3111` sigue disponible para hosts sin runtime de iii. ### Desde el código fuente ```bash git clone https://github.com/rohitg00/agentmemory.git && cd agentmemory npm install && npm run build && npm start ``` Esto arranca agentmemory con un `iii-engine` local si el binario fijado ya está instalado, o usa Docker Compose cuando se selecciona. REST, streams y el visor se enlazan a `127.0.0.1` por defecto. La ruta automática del binario en macOS/Linux requiere `curl`, un `sh` POSIX y `tar`. Instala `iii-engine` manualmente. **agentmemory actualmente fija `iii-engine` a `v0.22.1`**, la misma release que su dependencia `iii-sdk`; el worker habla el protocolo de ese motor, y 0.20.0 reorganizó la superficie del SDK, así que ambos avanzan juntos en cada release de agentmemory. Sobrescribe con `AGENTMEMORY_III_VERSION=` si ejecutas tu propio motor y sabes que coincide. - **macOS arm64:** `mkdir -p ~/.local/bin && curl -fsSLo iii.tar.gz https://github.com/iii-hq/iii/releases/download/iii/v0.22.1/iii-aarch64-apple-darwin.tar.gz && echo "2b309019b909a896cae874dc947e2cdf877b4f3c51dd026b79850af858517fa4 iii.tar.gz" | shasum -a 256 -c - && tar -xzf iii.tar.gz -C ~/.local/bin && chmod +x ~/.local/bin/iii` - **macOS x64:** sustituye `aarch64-apple-darwin` por `x86_64-apple-darwin` - **Linux x64:** sustituye por `x86_64-unknown-linux-gnu` - **Linux arm64:** sustituye por `aarch64-unknown-linux-gnu` - **Windows:** descarga `iii-x86_64-pc-windows-msvc.zip` desde [iii-hq/iii releases v0.22.1](https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1) y extrae `iii.exe` a `%USERPROFILE%\.agentmemory\bin\iii.exe` Cada archivo tiene un fichero `.sha256` correspondiente en la página de la release; cuando cambies de plataforma, usa el hash de ese fichero en la comprobación de arriba (en Windows: `Get-FileHash`). El instalador automático en `npx @agentmemory/agentmemory` fija estos hashes y rechaza un archivo que no coincida. O usa Docker (el `docker-compose.yml` empaquetado trae `iiidev/iii:0.22.1`). Documentación completa: [iii.dev/docs](https://iii.dev/docs). ### Windows agentmemory funciona en Windows 10/11, pero el paquete de Node.js por sí solo no es suficiente; también necesitas el runtime de iii-engine v0.22.1 fijado como proceso en segundo plano. La CLI no extrae automáticamente el ZIP de Windows, así que los usuarios de Windows nativo deben instalar `iii.exe` manualmente, usar WSL2 o elegir Docker Desktop. La conexión MCP automatizada en Windows nativo solo soporta `agentmemory connect copilot-cli`. Para Claude Code, Codex, Cursor y cualquier otro agente nativo de Windows, copia el bloque MCP manual de [Otros agentes](#other-agents) en la configuración de Windows de ese agente. Ejecutar `connect` en WSL solo es apropiado cuando el agente destino también está instalado en ese mismo entorno WSL; no edita la configuración de un agente que vive en el host Windows. **Opción A: binario de Windows preconstruido (recomendado)** ```powershell # 1. Open https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1 in your browser # (agentmemory pins the engine to the same release as its iii-sdk; # v0.22.1 is the current pair) # 2. Download iii-x86_64-pc-windows-msvc.zip # (or iii-aarch64-pc-windows-msvc.zip if you're on an ARM machine) # 3. Extract iii.exe to agentmemory's private engine directory: New-Item -ItemType Directory -Force "$HOME\.agentmemory\bin" # Copy iii.exe to $HOME\.agentmemory\bin\iii.exe # 4. Verify: & "$HOME\.agentmemory\bin\iii.exe" --version # Should print: 0.22.1 # 5. Then run agentmemory as usual: npx -y @agentmemory/agentmemory@latest ``` **Opción B: Docker Desktop** ```powershell # 1. Install Docker Desktop for Windows # 2. Start Docker Desktop and make sure the engine is running # 3. Select Docker explicitly and run agentmemory: $env:AGENTMEMORY_USE_DOCKER = "1" npx -y @agentmemory/agentmemory@latest ``` **Opción C: solo MCP standalone (sin motor).** Si solo necesitas las tools MCP para tu agente y no necesitas la REST API, el visor o los cron jobs, omite el motor por completo: ```powershell npx -y @agentmemory/agentmemory@latest mcp # or via the shim package: npx -y @agentmemory/mcp ``` **Diagnóstico para Windows:** si `npx -y @agentmemory/agentmemory@latest` falla, vuelve a ejecutarlo con `--verbose` para ver el stderr real del motor. Modos de fallo habituales: | Síntoma | Solución | |---|---| | `The engine process started but the REST API never responded.` | Confirma que los cuatro puertos derivados están libres, verifica que el `iii.exe` fijado se mantuvo vivo, y luego vuelve a ejecutar con `--verbose` e inspecciona el stderr del motor capturado | | `Could not start iii-engine` | Ni `iii.exe` ni Docker están instalados. Ver la Opción A o B arriba | | Conflicto de puerto | `netstat -ano \| findstr :3111` para ver qué está ocupando el puerto, luego mátalo o usa `--port ` | | Se omite el fallback a Docker aunque Docker esté instalado | Asegúrate de que Docker Desktop esté realmente en ejecución (icono de la bandeja del sistema) | > Nota: el **motor** de iii es un binario preconstruido, no un crate de cargo, así que no intentes instalarlo con `cargo install`. (Los **SDKs** de iii sí están publicados en crates.io, npm y PyPI, pero agentmemory no los necesita.) Los métodos de instalación del motor soportados están todos fijados a v0.22.1: el binario preconstruido de arriba, la ruta de auto-instalación de agentmemory en macOS/Linux (requiere `curl`, `sh` POSIX y `tar`), y la imagen Docker `iiidev/iii:0.22.1`. Un `install.sh | sh` upstream simple instala el motor más reciente, que agentmemory no soporta. Usa `npx -y @agentmemory/agentmemory@latest`; en macOS/Linux obtiene el motor fijado en `~/.agentmemory/bin`. ---

Deploy

Plantillas de un clic para hosts gestionados. Cada una incluye un Dockerfile autocontenido que descarga `@agentmemory/agentmemory` desde npm y copia el binario del iii engine desde la imagen oficial `iiidev/iii` de Docker Hub; no se requiere una imagen preconstruida de agentmemory. El almacenamiento persistente se monta en `/data`; el entrypoint del primer arranque sobrescribe la configuración de iii empaquetada por npm (que se enlaza a `127.0.0.1`) por una afinada para despliegue que se enlaza a `0.0.0.0` y usa rutas absolutas `/data`, genera el secreto HMAC, y luego baja privilegios de `root` a `node` con `gosu` antes de hacer exec del CLI de agentmemory.

Deploy to fly.io Deploy to Railway

El botón de despliegue de un clic de Render requiere un `render.yaml` en la raíz del repositorio, que mantenemos limpio a propósito. Usa el flujo Render Blueprint documentado en [`deploy/render/`](.././deploy/render/README.md) para apuntar al blueprint del repo manualmente. Los detalles completos de configuración (captura HMAC, túnel SSH del visor, rotación, backup, mínimos de coste) están en [`deploy/`](.././deploy/README.md): - [`deploy/fly`](.././deploy/fly/README.md): máquina única con `auto_stop_machines = "stop"`; más barato en idle. - [`deploy/railway`](.././deploy/railway/README.md): tarifa plana del plan Hobby, volumen en el dashboard. - [`deploy/render`](.././deploy/render/README.md): flujo Blueprint, snapshots automáticos de disco en planes de pago. - [`deploy/coolify`](.././deploy/coolify/README.md): self-hosted en tu propio VPS vía [Coolify](https://coolify.io/self-hosted); misma stack Docker Compose, tú eres dueño del host y los datos. Solo se publica el puerto `3111`. El visor en `3113` permanece enlazado a loopback dentro del contenedor; el README de cada plantilla documenta la pauta de túnel SSH para alcanzarlo. ---

Por qué agentmemory

Todo agente de codificación olvida todo al terminar la sesión, y cada nueva sesión empieza contigo re-explicando tu stack. agentmemory corre en segundo plano y elimina ese paso. ```text Session 1: "Add auth to the API" Agent writes code, runs tests, fixes bugs agentmemory silently captures every tool use Session ends -> observations compressed into structured memory Session 2: "Now add rate limiting" Agent already knows: - Auth uses JWT middleware in src/middleware/auth.ts - Tests in test/auth.test.ts cover token validation - You chose jose over jsonwebtoken for Edge compatibility Zero re-explaining. Starts working immediately. ``` ### Frente a la memoria integrada del agente Todo agente de codificación con IA viene con memoria integrada: Claude Code tiene `MEMORY.md`, Cursor tiene notepads, Cline tiene memory bank. Funcionan como notas adhesivas. agentmemory es la base de datos buscable que hay detrás de esas notas adhesivas. | | Integrada (CLAUDE.md) | agentmemory | |---|---|---| | Escala | tope de 200 líneas | Ilimitado | | Búsqueda | Carga todo en contexto | BM25 + vector + graph (solo top-K) | | Coste en tokens | 22K+ con 240 observaciones | ~1,900 tokens (92% menos) | | Cross-agent | Ficheros por agente | MCP + REST (cualquier agente) | | Coordinación | Ninguna | Leases, signals, actions, routines | | Observabilidad | Lectura manual de ficheros | Visor en tiempo real en :3113 | ---

Cómo funciona

### Pipeline de memoria ```text PostToolUse hook fires -> SHA-256 dedup (5min window) -> Privacy filter (strip secrets, API keys) -> Store raw observation -> Synthetic compression by default (LLM-written compression only with a provider + AGENTMEMORY_AUTO_COMPRESS=true) -> Vector embedding when an embedding provider is active -> Index in BM25, plus vectors when enabled Stop / SessionEnd hook fires -> Summarize session -> Knowledge graph extraction (if GRAPH_EXTRACTION_ENABLED=true) -> Slot reflection (if SLOT_REFLECT_ENABLED=true) SessionStart hook fires -> Load project profile (top concepts, files, patterns) -> Hybrid search (BM25 + vector + graph) -> Token budget (default: 2000 tokens) -> Inject into conversation ``` ### Consolidación de memoria en 4 niveles Modelada en cómo el cerebro humano procesa la memoria, incluida la consolidación del sueño. | Tier | Qué | Analogía | |------|------|---------| | **Working** | Observaciones crudas a partir del uso de tools | Memoria a corto plazo | | **Episodic** | Resúmenes de sesión comprimidos | "Qué pasó" | | **Semantic** | Hechos y patrones extraídos | "Lo que sé" | | **Procedural** | Workflows y patrones de decisión | "Cómo hacerlo" | Las memorias decaen con el tiempo (curva de Ebbinghaus). Las memorias accedidas con frecuencia se refuerzan. Las memorias obsoletas se evictan automáticamente. Las contradicciones se detectan y resuelven. ### Qué se captura | Hook | Captura | |------|----------| | `SessionStart` | Ruta de proyecto, ID de sesión | | `UserPromptSubmit` | Prompts del usuario (con filtro de privacidad) | | `PreToolUse` | Patrones de acceso a ficheros + contexto enriquecido | | `PostToolUse` | Nombre de la tool, entrada, salida | | `PostToolUseFailure` | Contexto del error | | `PreCompact` | Re-inyecta memoria antes de la compactación | | `SubagentStart/Stop` | Ciclo de vida de sub-agentes | | `Stop` | Resumen de fin de sesión | | `SessionEnd` | Marcador de sesión completa | ### Capacidades clave | Capacidad | Descripción | |---|---| | **Captura automática** | Cada uso de tool registrado vía hooks, sin esfuerzo manual | | **Búsqueda semántica** | BM25 + vector + grafo de conocimiento con fusión RRF | | **Evolución de memoria** | Versionado, supersesión, grafos de relaciones | | **Higiene de recall** | Las versiones de memoria reemplazadas salen de los índices de búsqueda; la cadena de versiones en KV conserva el historial completo | | **Pistas de casi-duplicados** | Los guardados reportan una coincidencia consultiva `similarTo` cuando el contenido nuevo se parece mucho a una memoria existente | | **Scoping por agente** | `agentId` atraviesa guardado y recall en REST, MCP y el índice de búsqueda, en modo compartido o aislado | | **Provenance en escritura** | Cada observación y memoria lleva un canal de origen inmutable (user, agent, tool, import o shared) sellado en captura, guardado e importación | | **Auto-olvido** | Expiración por TTL, detección de contradicciones, evicción por importancia | | **Privacy first** | API keys, secretos y etiquetas `` se eliminan antes del almacenado | | **Self-healing** | Circuit breaker, cadena de fallback de proveedores, monitorización de salud | | **Puente Claude** | Sincronización bidireccional con MEMORY.md | | **Grafo de conocimiento** | Extracción de entidades + recorrido BFS | | **Memoria de equipo** | Espacios compartidos y privados con namespace por miembro | | **Provenance de citas** | Traza cualquier memoria de vuelta a las observaciones origen | | **Snapshots de Git** | Versiona, revierte y diffea el estado de memoria | --- Recuperación de triple stream combinando tres señales: | Stream | Qué hace | Cuándo | |---|---|---| | **BM25** | Coincidencia por palabras con stemming y expansión de sinónimos | Siempre activo | | **Vector** | Similitud coseno sobre embeddings densos | Proveedor de embeddings configurado | | **Graph** | Recorrido del grafo de conocimiento vía coincidencia de entidades | Entidades detectadas en la consulta | Fusionado con Reciprocal Rank Fusion (RRF, k=60) y diversificado por sesión (máximo 3 resultados por sesión). Cuando el índice vectorial está poblado, `mem::search` (detrás de `memory_recall`) usa el ranker híbrido BM25 + vector. Sin embeddings usa BM25. `smart-search` además puede fusionar coincidencias estructurales del grafo cuando existen datos de grafo, incluso en modo sin claves. El recall de lecciones corre sobre un índice BM25 in-memory dedicado en lugar de escanear todo el corpus en cada consulta. Las versiones de memoria reemplazadas quedan excluidas de todas las rutas de recall; la cadena de versiones conserva su historial. Los vectores sobreviven a un crash o un force-kill. El índice vectorial se guarda en buckets como máximo cada `AGENTMEMORY_INDEX_SAVE_INTERVAL_MS` (10 minutos). Cada vector añadido o eliminado entretanto también se escribe de inmediato en un pequeño log pendiente en el state store, y el siguiente arranque lo reproduce sin llamar al proveedor de embeddings. Cada guardado exitoso vacía el log. Los documentos que siguen sin vector tras la reproducción se re-embeben en segundo plano en lotes de `AGENTMEMORY_VECTOR_BACKFILL_MAX` (500) hasta que no quede ninguno, y un backfill que se detiene continúa en el siguiente arranque. `/agentmemory/status` y el visor muestran el tamaño del log pendiente y el estado del backfill. Las instalaciones sin claves no escriben nada. BM25 tokeniza griego, cirílico, hebreo, árabe y latín con tildes de serie. Para memorias en chino / japonés / coreano, instala los segmentadores opcionales (`npm install @node-rs/jieba tiny-segmenter`) para partir los runs CJK en tokens a nivel de palabra; sin ellos, agentmemory hace soft-fallback a tokenización por run completo y muestra una pista única en stderr. ### Proveedores de embedding Las instalaciones sin claves desactivan los embeddings vectoriales: `mem::search` usa BM25, mientras que `smart-search` también puede usar datos estructurales de grafo existentes. Para optar por embeddings semánticos locales y gratuitos, añade esto a `~/.agentmemory/.env` y reinicia agentmemory: ```env EMBEDDING_PROVIDER=local ``` La instalación npm normal incluye el runtime opcional `@huggingface/transformers`. La primera petición de embedding descarga `Xenova/all-MiniLM-L6-v2`, así que necesita acceso a red y puede tardar más; la inferencia posterior corre en local. Los proveedores remotos se autodetectan a partir de sus claves a menos que `EMBEDDING_PROVIDER` los sobrescriba. | Proveedor | Modelo | Coste | Notas | |---|---|---|---| | **Local (opt-in recomendado)** | `all-MiniLM-L6-v2` | Gratis | En local tras la primera descarga del modelo, +8pp de recall sobre BM25-only | | Gemini | `gemini-embedding-001` | Free tier | 100+ idiomas, 768/1536/3072 dims (MRL), entrada de 2048 tokens. Sustituye a `text-embedding-004` ([deprecado, cierre el 14 ene 2026](https://ai.google.dev/gemini-api/docs/deprecations)) | | OpenAI | `text-embedding-3-small` | $0.02/1M | Máxima calidad | | Voyage AI | `voyage-code-3` | De pago | Optimizado para código | | Cohere | `embed-english-v3.0` | Trial gratis | Uso general | | OpenRouter | Cualquier modelo | Varía | Proxy multi-modelo | ---

Servidor MCP

54 tools, 6 recursos, 3 prompts y 17 skills. > **Shim MCP vs servidor completo:** el paquete publicado `@agentmemory/mcp` es un shim ligero. Expone la superficie completa de 54 tools **solo cuando puede alcanzar un servidor agentmemory en ejecución** vía `AGENTMEMORY_URL` (modo proxy). Sin servidor accesible, el shim cae a un set local de 7 tools (`memory_save`, `memory_recall`, `memory_smart_search`, `memory_sessions`, `memory_export`, `memory_audit`, `memory_governance_delete`). La variable de entorno `AGENTMEMORY_TOOLS=core|all` es un flag *del lado del servidor*; definirla en el bloque `env` del shim no tiene efecto. Si ves solo 7 tools en Cursor / OpenCode / Gemini CLI, arranca `npx -y @agentmemory/agentmemory@latest` (o la stack Docker) y define `AGENTMEMORY_URL=http://localhost:3111`. ### 54 Tools Tres superficies de tools, de menor a mayor: `AGENTMEMORY_TOOLS=core` recorta la visibilidad a 8 esenciales (`memory_save`, `memory_recall`, `memory_consolidate`, `memory_smart_search`, `memory_sessions`, `memory_diagnose`, `memory_lesson_save`, `memory_reflect`); el set base de abajo son las 14 tools fundacionales del registro; el valor por defecto (`AGENTMEMORY_TOOLS=all`) expone las 54.
Tools base (14) | Tool | Descripción | |------|-------------| | `memory_recall` | Busca observaciones pasadas | | `memory_compress_file` | Comprime ficheros markdown preservando la estructura | | `memory_save` | Guarda un insight, decisión o patrón | | `memory_file_history` | Observaciones pasadas sobre ficheros concretos | | `memory_patterns` | Detecta patrones recurrentes | | `memory_sessions` | Lista sesiones recientes | | `memory_smart_search` | Búsqueda híbrida semántica + por palabras | | `memory_vision_search` | Busca observaciones de imágenes | | `memory_timeline` | Observaciones cronológicas | | `memory_profile` | Perfil de proyecto (conceptos, ficheros, patrones) | | `memory_export` | Exporta todos los datos de memoria | | `memory_relations` | Consulta el grafo de relaciones | | `memory_commit_lookup` | Sesiones detrás de un commit de git | | `memory_commits` | Commits registrados para una sesión |
Tools extendidas (54 en total, la superficie por defecto) | Tool | Descripción | |------|-------------| | `memory_patterns` | Detecta patrones recurrentes | | `memory_timeline` | Observaciones cronológicas | | `memory_relations` | Consulta el grafo de relaciones | | `memory_graph_query` | Recorrido del grafo de conocimiento | | `memory_consolidate` | Ejecuta la consolidación de 4 niveles | | `memory_claude_bridge_sync` | Sincroniza con MEMORY.md | | `memory_team_share` | Comparte con miembros del equipo | | `memory_team_feed` | Elementos compartidos recientes | | `memory_audit` | Pista de auditoría de operaciones | | `memory_governance_delete` | Borrado con pista de auditoría | | `memory_snapshot_create` | Snapshot versionado en Git | | `memory_action_create` | Crea ítems de trabajo con dependencias | | `memory_action_update` | Actualiza estado de una action | | `memory_frontier` | Actions desbloqueadas, ordenadas por prioridad | | `memory_next` | La única acción más importante a continuación | | `memory_lease` | Leases exclusivos de actions (multiagente) | | `memory_routine_run` | Instancia rutinas de workflow | | `memory_signal_send` | Mensajería entre agentes | | `memory_signal_read` | Lee mensajes con acuse de recibo | | `memory_checkpoint` | Gates de condiciones externas | | `memory_mesh_sync` | Sincronización P2P entre instancias | | `memory_sentinel_create` | Watchers dirigidos por eventos | | `memory_sentinel_trigger` | Dispara sentinels desde fuera | | `memory_sketch_create` | Grafos de actions efímeros | | `memory_sketch_promote` | Promociona a permanente | | `memory_crystallize` | Compacta cadenas de actions | | `memory_diagnose` | Health checks | | `memory_heal` | Repara automáticamente estado atascado | | `memory_facet_tag` | Tags dimension:value | | `memory_facet_query` | Consulta por tags de facet | | `memory_verify` | Traza provenance |
### 6 Recursos · 3 Prompts · 17 Skills | Tipo | Nombre | Descripción | |------|------|-------------| | Resource | `agentmemory://status` | Salud, conteo de sesiones, conteo de memorias | | Resource | `agentmemory://project/{name}/profile` | Inteligencia por proyecto | | Resource | `agentmemory://project/{name}/recent` | Observaciones recientes de un proyecto | | Resource | `agentmemory://memories/latest` | Las 10 memorias activas más recientes | | Resource | `agentmemory://graph/stats` | Estadísticas del grafo de conocimiento | | Resource | `agentmemory://team/{id}/profile` | Perfil de equipo compartido | | Prompt | `recall_context` | Búsqueda + devuelve mensajes de contexto | | Prompt | `session_handoff` | Datos de traspaso entre agentes | | Prompt | `detect_patterns` | Analiza patrones recurrentes | | Skill | `/recall` | Busca en memoria | | Skill | `/remember` | Guarda en memoria a largo plazo | | Skill | `/session-history` | Resúmenes recientes de sesiones | | Skill | `/forget` | Borra observaciones/sesiones | La tabla muestra las cuatro skills principales. El set completo son 9 skills invocables más 8 skills de referencia; consulta la sección de skills nativas más arriba. ### MCP standalone Ejecuta sin el servidor completo, para cualquier cliente MCP. Cualquiera de estos funciona: ```bash npx -y @agentmemory/agentmemory@latest mcp # canonical (always available) npx -y @agentmemory/mcp # shim package alias ``` O añádelo a la config MCP de tu agente: La mayoría de agentes (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI): ```json { "mcpServers": { "agentmemory": { "command": "npx", "args": ["-y", "@agentmemory/mcp"], "env": { "AGENTMEMORY_URL": "http://localhost:3111" } } } } ``` Fusiona la entrada `agentmemory` en el objeto `mcpServers` existente del host en lugar de reemplazar el fichero. Para clientes en sandbox que no pueden alcanzar el `localhost` del host, añade `"AGENTMEMORY_FORCE_PROXY": "1"` al bloque env y define `AGENTMEMORY_URL` a una ruta a la que el sandbox sí pueda llegar. OpenCode (`opencode.json`): ```json { "mcp": { "agentmemory": { "type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true } }, "plugin": ["./plugins/agentmemory-capture.ts"] } ``` Copia el fichero del plugin desde el repo: ```bash mkdir -p ~/.config/opencode/plugins cp plugin/opencode/agentmemory-capture.ts ~/.config/opencode/plugins/ cp plugin/opencode/commands/*.md ~/.config/opencode/commands/ ``` ---

Visor en tiempo real

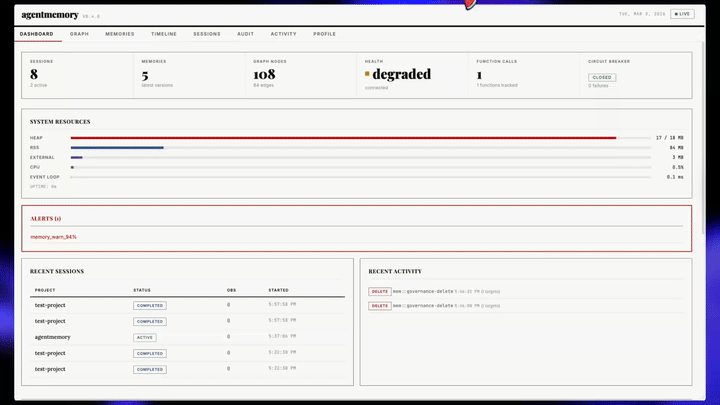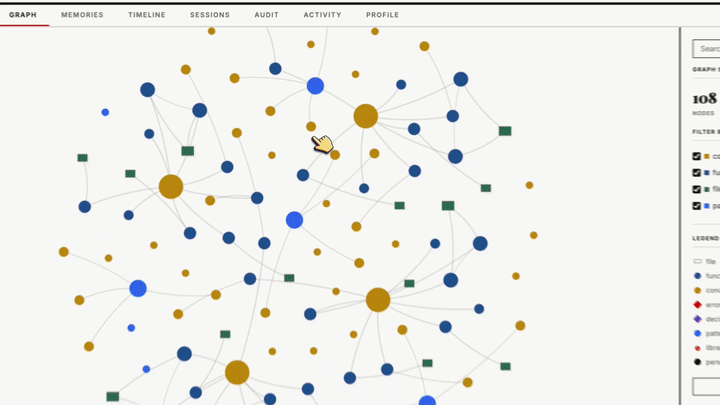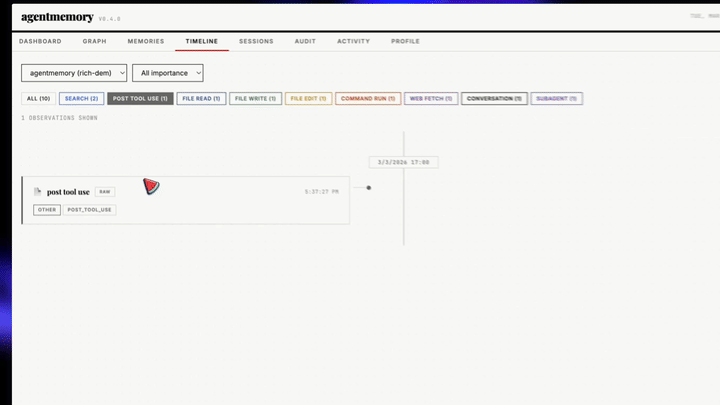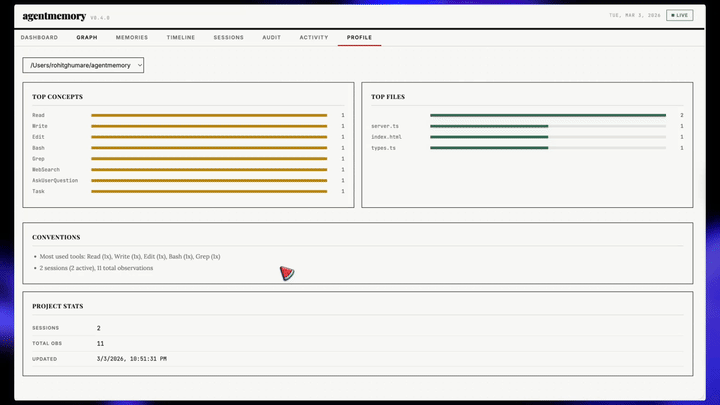
Arranca automáticamente en el puerto `3113`. El visor carga un snapshot al conectar (`GET /agentmemory/viewer/snapshot`) y luego aplica eventos de stream en vivo: memorias nuevas, lecciones, observaciones, entradas de auditoría, cambios de grafo y actualizaciones de salud aparecen sin polling ni recargas de página. Las únicas otras peticiones son las acciones que haces clic, las páginas de "cargar más" y las búsquedas. Cuando el stream se cae, el visor muestra cuán viejos son sus números, reconecta con backoff y resincroniza desde un snapshot. - **12 pestañas en cuatro grupos** con conteos en vivo, deep links (`#memories/`, `#sessions/?obs=`, `#graph/`, `#health/consolidation`), atajos de teclado y un menú móvil. - **Memories:** búsqueda del lado del servidor, filtros por proyecto, agente y tipo, un panel de detalle con la cadena de versiones y un word diff, enlaces de provenance, botones de copia para el id, la llamada MCP y un comando curl, edición (una nueva versión), forget con confirmación, forget masivo y exportación JSON. - **Sessions:** una línea de tiempo de observaciones inline con entrada y salida de tool legibles, filtros y paginación, y las memorias y lecciones que produjo cada sesión. - **Graph:** búsqueda, detalle de nodo con relaciones y fuentes, una leyenda que no depende solo del color, y controles de zoom. - **Health:** la versión en vivo de `GET /agentmemory/status`. Cada problema viene con su solución, además del backend de estado, el estado de guardado del índice, el progreso de compactación de provenance del grafo y una explicación de la consolidación con los umbrales reales. - Páginas **Audit, Activity, Profile, Replay, Lessons, Actions y Crystals**, cada una con un estado vacío que dice qué es la sección, por qué está vacía y el comando que la rellena, y un tooltip de glosario `?` en cada término y número. ```bash open http://localhost:3113 ``` El servidor del visor se enlaza a `127.0.0.1` por defecto y adjunta el secreto del servidor cuando reenvía peticiones a la REST API, así que no necesita configuración. El endpoint `/agentmemory/viewer` servido por REST sigue las reglas habituales de bearer-token y redirige los navegadores sin token al puerto del visor. Las cabeceras CSP usan un nonce de script por respuesta y desactivan los atributos handler inline (`script-src-attr 'none'`). ---

iii Console

El visor en `:3113` muestra lo que tu agente **recordó**. La [iii console](https://iii.dev/docs/console) muestra lo que tu agente **hizo**: cada operación de memoria como una traza OpenTelemetry, cada entrada KV editable, cada función invocable, cada stream tappable. Dos ventanas sobre la misma memoria: una con forma de producto, otra con forma de motor. Observa cómo se dispara un `memory_smart_search` y ve el BM25 scan → embedding lookup → fusión RRF → reranker como un waterfall. Edita un timer de consolidación atascado en el navegador de KV. Repite un hook `PostToolUse` con un payload modificado. Fija el stream de WebSocket y observa cómo aterrizan las observaciones en vivo. agentmemory incluye esto gratis porque cada llamada a función y cada trigger se disparan a través de iii; nada personalizado, nada que instrumentar.

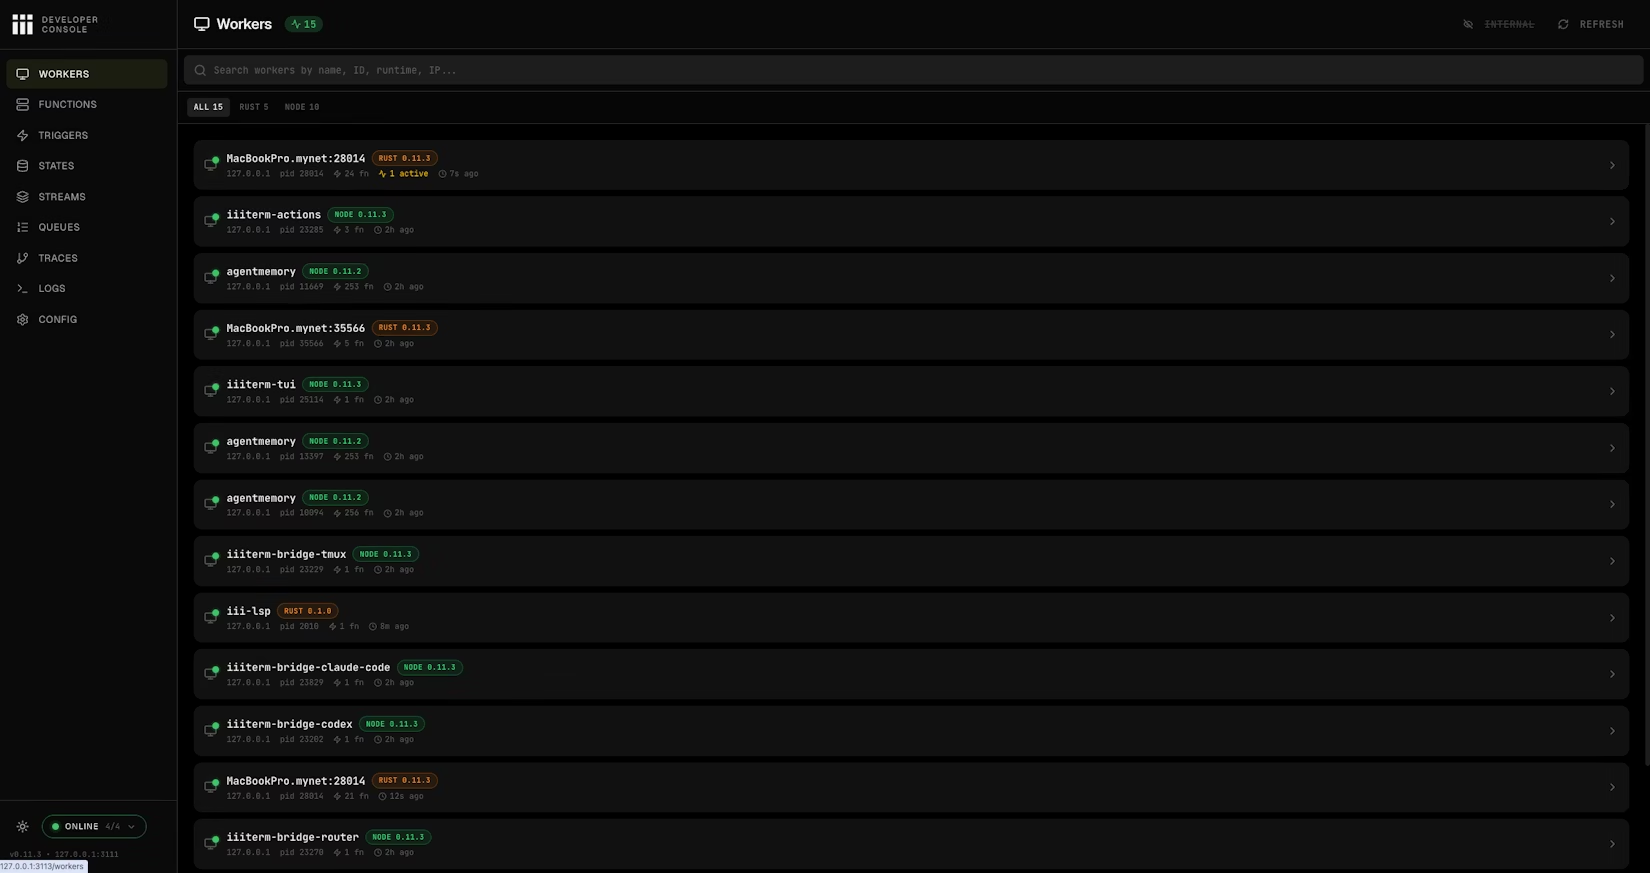
Página Workers de iii console: workers conectados incluyendo instancias de agentmemory con conteo de funciones en vivo y metadatos de runtime
Página Workers: cada worker conectado, incluida agentmemory, con PID, conteo de funciones, runtime y last-seen.
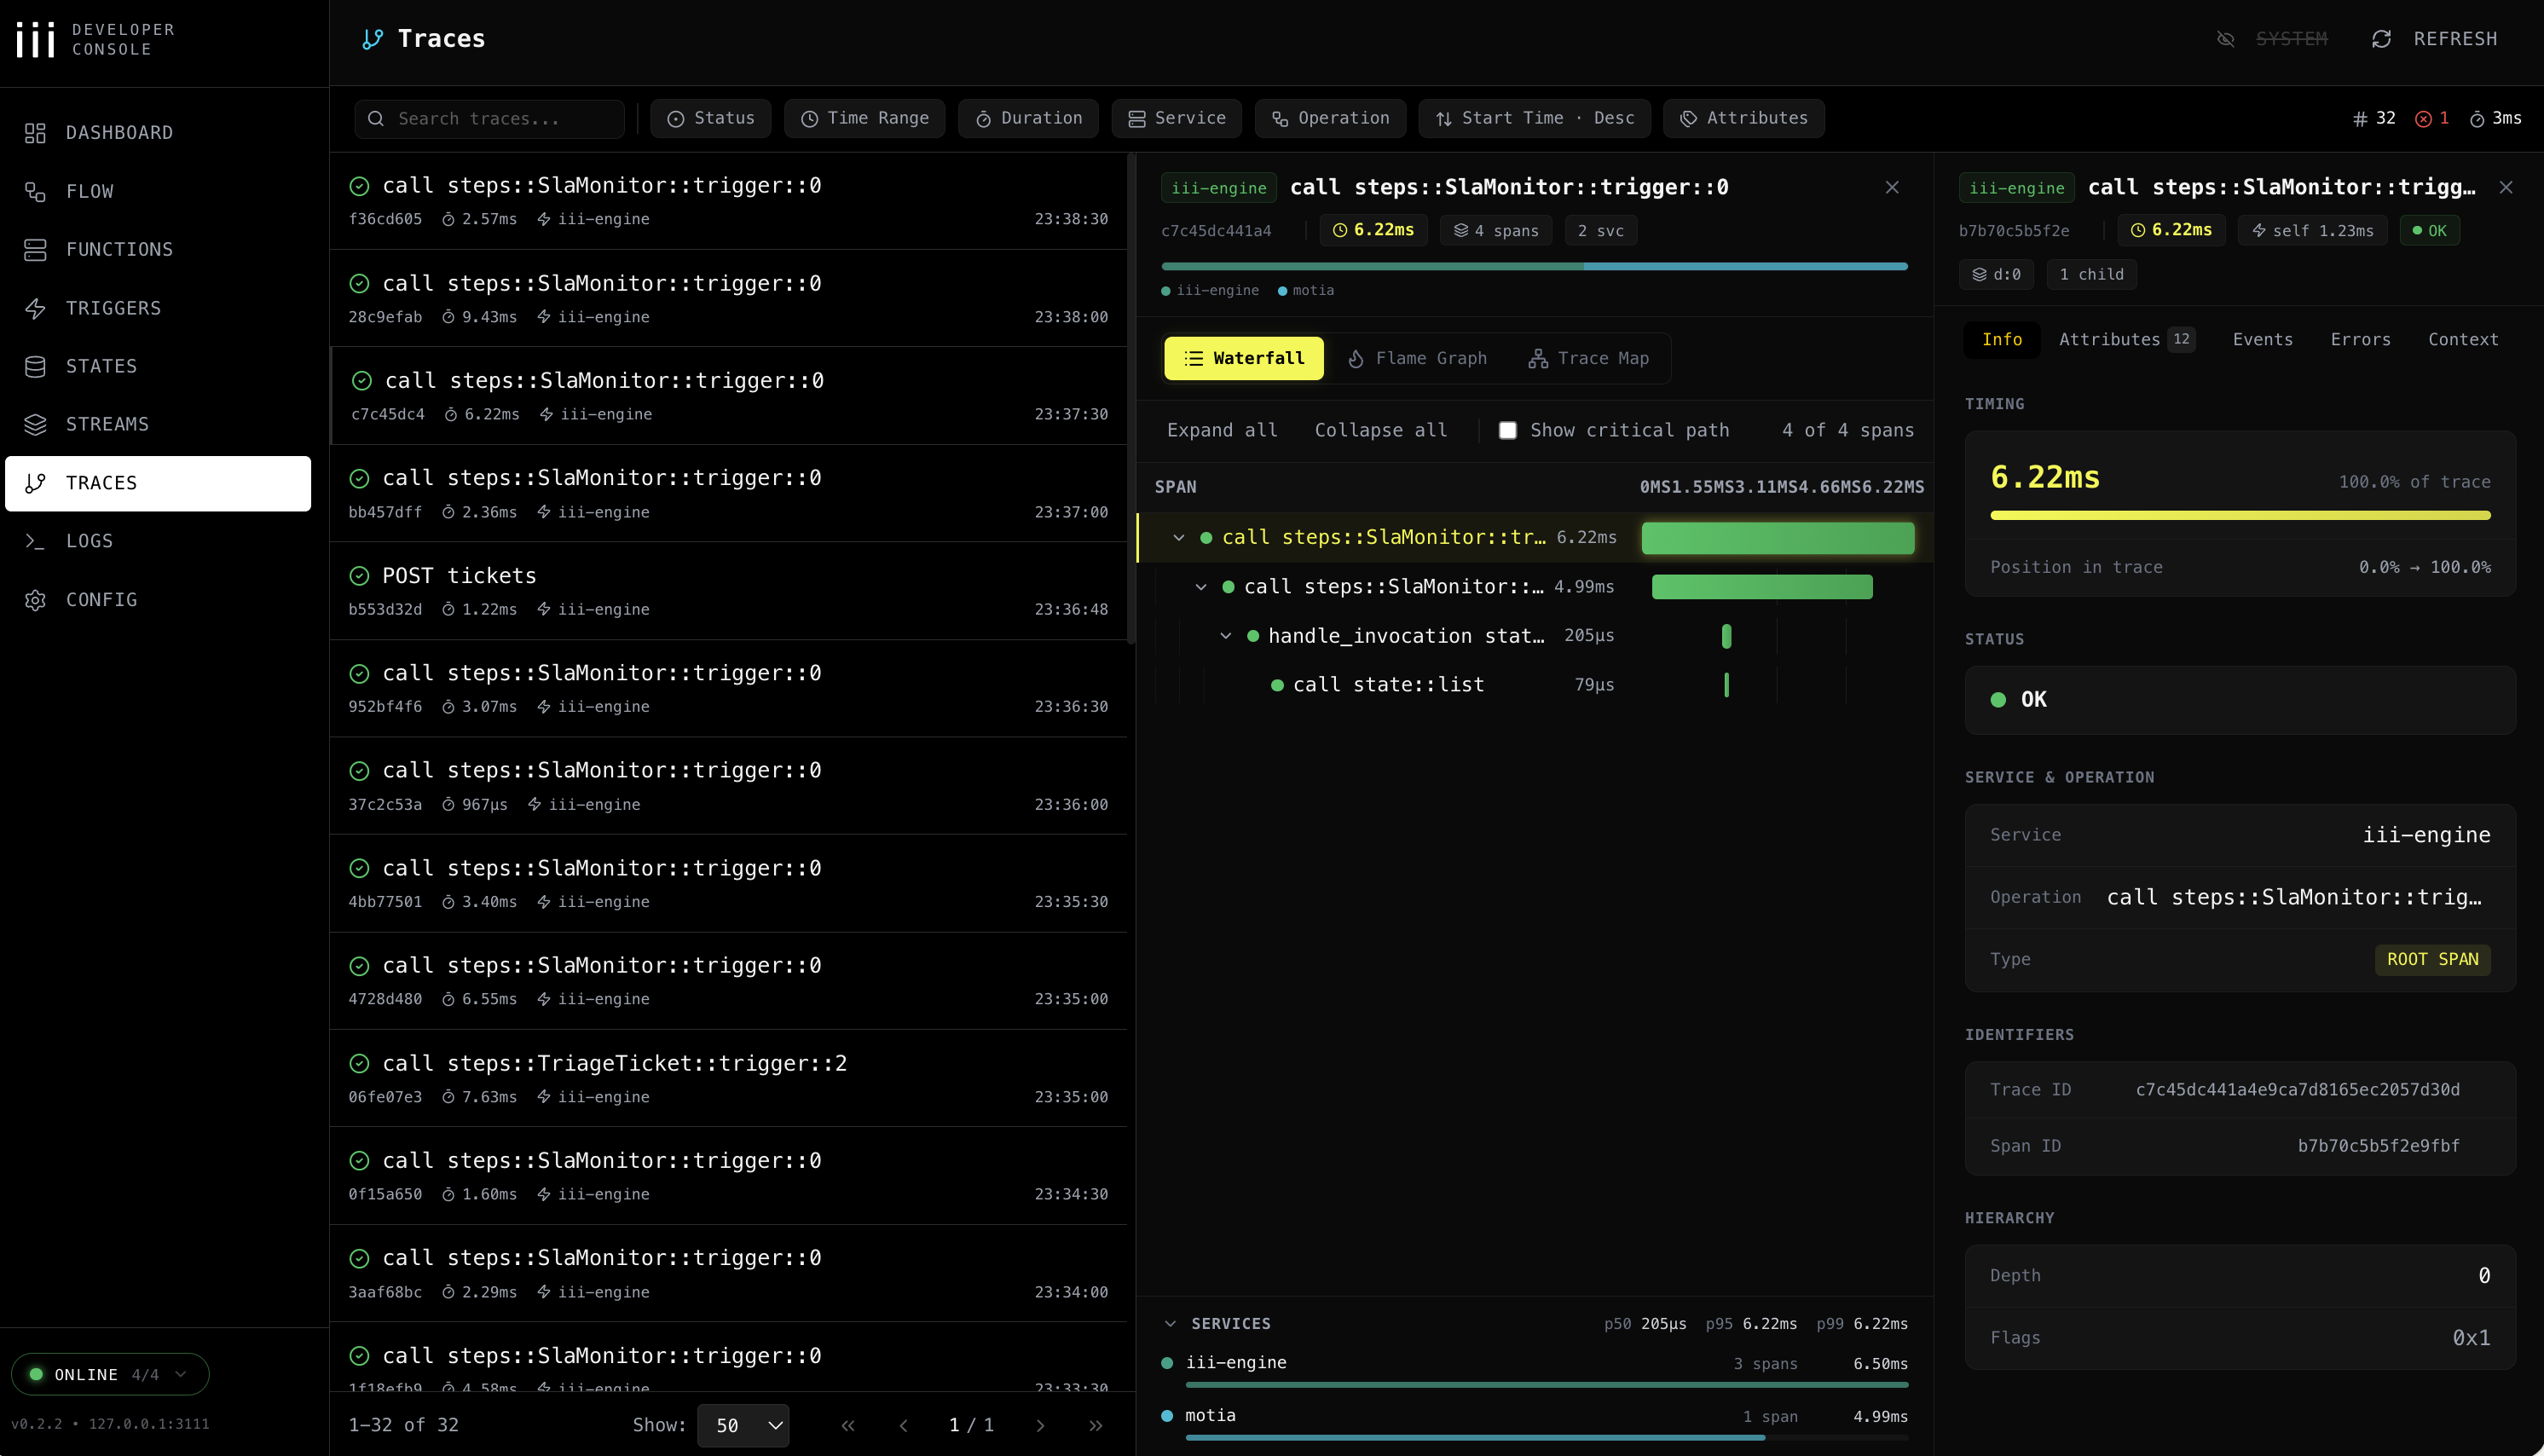
**Ya está instalado.** La console se incluye con el `iii` engine fijado (0.22+); no hay nada separado que instalar. El primer lanzamiento descarga el binario de la console junto al motor. **Lánzala junto a agentmemory:** ```bash agentmemory console ``` Esto ejecuta el `iii console` del motor fijado contra los puertos que agentmemory resolvió (REST, streams, bridge) y lo sirve un puerto por encima del visor, `http://localhost:3114` por defecto. `--console-port N` elige otro puerto; `--port` y `--instance` seleccionan la instancia de agentmemory del mismo modo que lo hacen para `stop`; cualquier otro flag se pasa tal cual, por ejemplo `--enable-flow` para la página experimental de grafo de arquitectura. Lo mismo a mano, útil cuando `agentmemory` no está en el PATH: ```bash ~/.agentmemory/bin/iii console --port 3114 \ --engine-port 3111 \ --ws-port 3112 \ --bridge-port 49134 ``` **Qué puedes hacer desde la console:** | Página | Úsala para | |------|-----------| | **Workers** | Ver todos los workers conectados y sus métricas en vivo, incluyendo el propio worker de agentmemory. | | **Functions** | Invoca cualquiera de las funciones de agentmemory directamente con un payload JSON; útil para probar `memory.recall`, `memory.consolidate`, `graph.query` sin conectar un cliente. | | **Triggers** | Repite triggers de HTTP, cron, eventos y estado: dispara el cron de consolidación manualmente, reintenta una ruta HTTP, emite un cambio de estado. | | **States** | Navegador de KV con CRUD completo sobre sesiones, slots de memoria, timers de ciclo de vida y el índice de embeddings; edita valores in situ. | | **Streams** | Monitor de WebSocket en vivo para escrituras de memoria, eventos de hook y actualizaciones de observaciones mientras fluyen por los streams de iii. | | **Queues** | Topics de queue durables + gestión de dead-letter. Repite o descarta jobs fallidos de embedding / compresión. | | **Traces** | Vistas waterfall / flame / service-breakdown de OpenTelemetry. Filtra por `trace_id` para ver exactamente qué funciones, llamadas a BD y peticiones de embedding produjo un único `memory.search`. | | **Logs** | Logs OTEL estructurados, filtrados y correlacionados con IDs de trace/span. | | **Config** | Configuración de runtime: ve exactamente con qué workers, proveedores y puertos está corriendo tu motor. | | **Flow** | (Opcional, `--enable-flow`) Grafo de arquitectura interactivo de cada worker, trigger y stream. |

Vista de waterfall de trazas de iii console mostrando duración por span
Traces: waterfall / flame / service breakdown para cada operación de memoria.

**Las traces ya están activas:** `iii-config.yaml` se sirve con el worker `iii-observability` habilitado (`exporter: memory`, `sampling_ratio: 0.1`, métricas + logs). No se necesita configuración adicional; en el momento en que agentmemory arranca, cada operación de memoria emite un log estructurado que la console puede leer, y una de cada diez (`sampling_ratio: 0.1`) emite además un trace span. Si en su lugar quieres exportar a Jaeger/Honeycomb/Grafana Tempo, cambia `exporter: memory` por `exporter: otlp` y define el endpoint del collector según la documentación de observabilidad de iii. > **Aviso:** la console en sí no exige auth; manténla enlazada a `127.0.0.1` (el valor por defecto) y nunca la expongas públicamente. ---

Powered by iii

agentmemory **ya es una instancia [iii](https://iii.dev) en ejecución**. Tres primitivos (worker, función, trigger) componen el runtime; el estado KV, los streams y las trazas OTEL provienen de los workers iii-state, iii-stream e iii-observability que se incluyen con iii. No has instalado Postgres, Redis, Express, pm2 ni Prometheus, porque iii los reemplaza. Eso significa que un comando más extiende agentmemory con una capacidad completamente nueva. ### Extiende agentmemory con más workers Los builtins que agentmemory necesita ya están en `iii-config.yaml` y arrancan con él: `iii-state` (KV), `iii-queue` (reintentos durables para los suscriptores de eventos), `iii-pubsub`, `iii-cron`, `iii-stream` e `iii-observability` (trazas OTEL, métricas y logs en cada función). Cualquier otra cosa del [registro de workers de iii](https://workers.iii.dev) se conecta al mismo motor: copia `iii-config.yaml` a `~/.agentmemory/iii-config.yaml` (la CLI prefiere ese fichero sobre el empaquetado y aun así renderiza en él los puertos y las rutas de datos), añade la entrada, instala el runtime del worker una vez con `~/.agentmemory/bin/iii update worker`, y reinicia agentmemory. ```yaml workers: # ...the bundled entries... - name: database # SQL-backed state adapter when you outgrow the KV defaults - name: iii-sandbox # run code that came out of memory_recall inside a throwaway VM - name: mcp # extra MCP servers next to agentmemory's, same engine ``` | Worker | Qué obtienes encima de agentmemory | |---|---| | [`database`](https://workers.iii.dev/workers/database) | Adaptador de estado respaldado por SQL para cuando superes los valores por defecto de KV en memoria | | [`iii-sandbox`](https://workers.iii.dev/workers/iii-sandbox) | El código que sale de `memory_recall` corre dentro de una VM descartable, no en tu shell | | [`mcp`](https://workers.iii.dev/workers/mcp) | Levanta servidores MCP extra junto al de agentmemory, compartiendo el mismo motor | En el motor 0.22.x mantén los nombres con prefijo `iii-` para los builtins de arriba; las entradas sin prefijo `http`, `state`, `queue`, `pubsub` y `cron` son los workers standalone del registro a los que agentmemory se moverá con la migración a 0.23. Registro completo: [workers.iii.dev](https://workers.iii.dev). Cada worker allí se compone a través de los mismos primitivos que usa agentmemory, y el agentmemory que ya tienes es uno de ellos. ### Configuración del motor y dirección de bind `agentmemory start` lee la configuración del motor desde el primer fichero que exista: `AGENTMEMORY_III_CONFIG`, `./iii-config.yaml` en el directorio actual, `~/.agentmemory/iii-config.yaml`, y luego el `iii-config.yaml` empaquetado. En cada arranque renderiza ese fichero (rutas de datos, puertos, backend de estado) en `~/.agentmemory/data/iii-config.runtime.yaml` y lanza el motor con la copia renderizada, así que edita el fichero fuente, no el renderizado. Los valores `host:` del fichero fuente se mantienen tal como están escritos. El `iii-config.yaml` empaquetado se enlaza a `127.0.0.1` a propósito, y ese valor por defecto también aplica dentro de un contenedor. Una CLI arrancada en un contenedor escucha en el loopback del contenedor, así que los puertos publicados no alcanzan nada. Para servir una CLI en contenedor a través de puertos publicados, define `AGENTMEMORY_III_CONFIG` a una config que se enlace a `0.0.0.0`. El `iii-config.docker.yaml` empaquetado es una de ellas: enlaza `iii-http`, `iii-stream` y el puerto del motor a `0.0.0.0` y almacena el estado bajo `/data`, así que monta ahí un volumen con permiso de escritura. Mantén `AGENTMEMORY_SECRET` definido, y publica solo los puertos que necesites, en `127.0.0.1` o detrás de un proxy de confianza. El `docker-compose.yml` de este repo no pasa por la búsqueda de config de la CLI: monta `iii-config.docker.yaml` en `/app/config.yaml`, y el contenedor `iii-engine` arranca con `--config /app/config.yaml`. Las [plantillas de despliegue](../deploy/) de un clic escriben su propia config `0.0.0.0` en sus entrypoints. ### Backend de almacenamiento: file (por defecto) vs redis `iii-state` e `iii-stream` usan por defecto el almacén KV basado en ficheros que trae iii-engine: un fichero JSON por scope, mantenido en la memoria del proceso del motor y reescrito a disco con un timer. Ese es el valor por defecto correcto para una instalación local de un solo usuario; un daemon compartido con varios escritores concurrentes obtiene en cambio escrituras reales por clave desde Redis, al coste de un round trip de red por operación (cada llamada `state::*` sigue serializándose en una única conexión Redis, así que esto cambia el lock del file store por un socket, no por paralelismo). Define `AGENTMEMORY_STATE_BACKEND=redis` (más `AGENTMEMORY_REDIS_URL`) para cambiar ambos workers al adaptador `redis` integrado en iii-engine, que almacena cada clave como un campo de hash de Redis (`HSET`) en lugar de reescribir todo un scope en cada escritura: ```env # ~/.agentmemory/.env AGENTMEMORY_STATE_BACKEND=redis AGENTMEMORY_REDIS_URL=redis://localhost:6379 ``` `AGENTMEMORY_STATE_BACKEND` tiene por defecto `file`; dejarla sin definir mantiene el comportamiento actual sin cambios, y un valor no reconocido (cualquier cosa distinta de `file` o `redis`) es un error de arranque en lugar de un fallback silencioso. `/agentmemory/status` y la página Health del visor (la fila State store) informan de qué backend está activo y si responde, nunca la URL. **Solo `redis://` sin cifrar.** El motor fijado (0.22.1) construye su cliente Redis sin soporte TLS, así que una URL `rediss://` (la mayoría de ofertas de Redis gestionado, como Upstash, Redis Cloud y ElastiCache con cifrado en tránsito, usan TLS-only por defecto) falla al conectar. La conexión no está cifrada, así que la contraseña de Redis y cada memoria almacenada cruzan el cable en texto claro: apunta a un Redis local o a uno en una red privada de confianza. Para cualquier otro Redis, ejecuta un túnel cifrado (stunnel, SSH o una VPN) en el host de agentmemory, de modo que el salto `redis://` sin cifrar se quede en ese host y la conexión upstream del túnel esté cifrada y autenticada. Si una contraseña de Redis contiene una comilla simple, codifícala en percent-encoding (`%27`); el motor expande la URL dentro de su config YAML antes de parsearla. **Un servidor Redis por `--instance`.** Los prefijos de clave Redis del motor (`state:`, `stream::`) son fijos, así que dos instancias de agentmemory (`--instance 1`, `--instance 2`, ...) que apunten a la misma base de datos se sobrescriben los datos mutuamente. Un índice de base de datos separado (`redis://localhost:6379/1`) mantiene separados los datos almacenados, pero el motor retransmite los eventos del visor en vivo sobre un único canal pub/sub de Redis (`stream::events`), y el pub/sub de Redis ignora el índice de base de datos, así que el visor de cada instancia seguiría mostrando los eventos en vivo del otro. Dale a cada instancia su propio servidor Redis (o puerto) cuando ejecutes más de una. **Qué se mantiene igual, y qué difiere.** Todas las funciones de agentmemory funcionan sobre Redis: sesiones, observaciones, memorias (remember, supersede, evolve, forget), búsqueda y los buckets del índice, lecciones, el grafo, el log de auditoría y sus scopes mensuales, export e import, borrados de gobernanza, estado de consolidación, el snapshot del visor y su stream en vivo, y el monitor de salud. El motor almacena cada scope como un hash de Redis (`HSET`/`HGET`/`HGETALL`) y dispara los mismos triggers de estado que el file store. Tres diferencias del motor se gestionan dentro de agentmemory: - Redis devuelve los registros de un scope sin orden fijo. agentmemory los ordena del más antiguo al más reciente (por el tiempo de creación en el id del registro, luego por su timestamp) para que las listas, la paginación y los chunks de export vuelvan en el mismo orden que en el file store. - El motor aplica actualizaciones parciales en Redis mediante un script Lua que convierte los arrays vacíos en objetos vacíos. agentmemory aplica esas actualizaciones por sí mismo (leer, cambiar, escribir bajo un lock por clave) sobre Redis, así que campos como `tags: []` se mantienen como arrays. - La comprobación del log de auditoría legacy lee el scope antiguo desde Redis en lugar de buscar el fichero del file store en disco. Una diferencia requiere tu intervención: **tras un reinicio de Redis, el motor deja de retransmitir eventos en vivo** al visor hasta que agentmemory se reinicia. Los datos se siguen guardando y leyendo normalmente. El monitor de salud envía un evento de prueba a través de Redis cada 30 segundos; cuando no vuelve, `/agentmemory/status` y la página Health del visor muestran "Live updates are not reaching the viewer" con la solución: reiniciar agentmemory. Si Redis está caído, el informe de estado muestra "The state store is not answering" y cómo comprobarlo (`redis-cli -u "$AGENTMEMORY_REDIS_URL" ping`). Listar un scope muy grande lee todo el hash en un único `HGETALL`, el mismo coste que tiene el file store al mantenerlo en memoria. **Ajustes de Redis recomendados.** La política de snapshot por defecto `save 3600 1 300 100 60 10000` puede perder minutos de escrituras en un crash, peor que la ventana de flush de 5s del file store. Define `appendonly yes` para cualquier cosa cuya pérdida te importaría. Define `maxmemory-policy noeviction`; `allkeys-lru` o similar descarta memorias silenciosamente en cuanto Redis alcanza su límite de memoria. Un arranque nativo (sin Docker), y cada [plantilla de despliegue](../deploy/) de un clic (sobrescriben el `iii-config.yaml` empaquetado y arrancan de forma nativa), leen `AGENTMEMORY_STATE_BACKEND`/`AGENTMEMORY_REDIS_URL` y los renderizan en el `iii-config` lanzado. La URL en sí nunca se escribe en ese fichero renderizado, solo una referencia `${AGENTMEMORY_REDIS_URL}` que el proceso del motor expande desde su propio entorno al arrancar. Solo la ruta de Docker Compose propia de este repo (`AGENTMEMORY_USE_DOCKER=1`, o reanudar un motor ya arrancado de esa forma) monta `iii-config.docker.yaml` como solo lectura y nunca renderiza; `agentmemory start` avisa cuando detecta esa combinación. Cambia ese fichero a mano, siguiendo la misma forma `name: redis` / `config: redis_url: ...` que muestran los docs de los workers [iii-state](https://workers.iii.dev/workers/iii-state) e [iii-stream](https://workers.iii.dev/workers/iii-stream), y apunta `redis_url` a un Redis alcanzable desde el contenedor. `docker-compose.yml` pasa `AGENTMEMORY_REDIS_URL` al contenedor del motor, así que `redis_url: '${AGENTMEMORY_REDIS_URL}'` funciona ahí y mantiene la URL fuera del fichero montado. La config renderizada mantiene la URL fuera de `~/.agentmemory/data/iii-config.runtime.yaml`, pero el propio worker de configuración del motor sigue persistiendo el valor *expandido* en `~/.agentmemory/config/iii-state.yaml` y `iii-stream.yaml` una vez que arranca (la expansión de `${VAR}` de iii-engine ocurre antes de que ese worker guarde su seed, y guarda el valor resuelto, no la referencia). Trata ese directorio como si contuviera una credencial: `chmod 700 ~/.agentmemory` en cualquier host compartido, y prefiere un usuario de Redis ACL con scope a lo que agentmemory necesita en lugar de las credenciales de administrador de la base de datos. **La migración no es automática.** Cambiar `AGENTMEMORY_STATE_BACKEND` arranca desde un store vacío en ambos lados; nada copia los datos existentes de file a Redis o viceversa. Exporta desde el backend que dejas e importa en el que te mudas. Esto corre de forma idéntica en bash y zsh (incluido `bash -u`). Un array como `AUTH=(${AGENTMEMORY_SECRET:+-H "Authorization: Bearer $AGENTMEMORY_SECRET"})` no: zsh mantiene la cabecera como una sola palabra malformada mientras que bash la divide en dos, así que ambas peticiones devuelven 401 siempre que `AGENTMEMORY_SECRET` esté definido: ```bash # 0. Use the generated secret when none is exported: AGENTMEMORY_SECRET="${AGENTMEMORY_SECRET:-$(cat ~/.agentmemory/secret 2>/dev/null)}" # 1. On the old backend, while agentmemory is still running on it: if [ -n "${AGENTMEMORY_SECRET:-}" ]; then curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" http://localhost:3111/agentmemory/export > backup.json else curl -fsS http://localhost:3111/agentmemory/export > backup.json fi # 2. Confirm backup.json is a usable export before switching backends: jq -e '.version and .exportedAt' backup.json > /dev/null || { echo "backup.json is not a valid export; do not switch backends" >&2 exit 1 } # 3. Switch AGENTMEMORY_STATE_BACKEND (and AGENTMEMORY_REDIS_URL if needed), # restart agentmemory against the new backend, then: if [ -n "${AGENTMEMORY_SECRET:-}" ]; then jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \ curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" -X POST http://localhost:3111/agentmemory/import \ -H 'Content-Type: application/json' -d @- else jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \ curl -fsS -X POST http://localhost:3111/agentmemory/import \ -H 'Content-Type: application/json' -d @- fi ``` `/agentmemory/export` también acepta `?maxSessions=` y `?offset=` para dividir en chunks un corpus grande entre varias llamadas; `strategy` en import es `merge` (seguro por defecto), `replace` o `skip`. ### Qué reemplaza iii | Stack tradicional | agentmemory usa | |---|---| | Express.js / Fastify | iii HTTP Triggers | | SQLite / Postgres + pgvector | iii KV State + índice vectorial in-memory | | SSE / Socket.io | iii Streams (WebSocket) | | pm2 / systemd | Supervisión de workers del iii engine | | Prometheus / Grafana | iii OTEL + monitor de salud | | Sistemas de plugins propios | `iii worker add ` | **219 ficheros de código · ~52,000 LOC · 2,500+ tests · 311 funciones · 60 scopes KV**, todo sobre tres primitivos. No hay `agentmemory plugin install`. El sistema de plugins es iii mismo. ---

Configuración

### Proveedores de LLM agentmemory autodetecta proveedores desde tu entorno. Un proveedor habilita las operaciones respaldadas por LLM, pero configurar solo el proveedor no activa la compresión de observaciones escrita por LLM. Esa ruta requiere tanto un proveedor como `AGENTMEMORY_AUTO_COMPRESS=true`. | Proveedor | Config | Notas | |----------|--------|-------| | **No-op (por defecto)** | No necesita config | La compresión/resumen respaldados por LLM están desactivados. La compresión sintética y el recall por BM25 siguen funcionando. Ver `AGENTMEMORY_ALLOW_AGENT_SDK` más abajo si antes dependías del fallback por suscripción de Claude. | | Anthropic API | `ANTHROPIC_API_KEY` | Facturación por token | | MiniMax | `MINIMAX_API_KEY` | Compatible con Anthropic | | Gemini | `GEMINI_API_KEY` | También habilita embeddings | | OpenRouter | `OPENROUTER_API_KEY` | Cualquier modelo | | OpenAI API | `OPENAI_API_KEY` | Por defecto `gpt-5.6-luna`, sobrescribe con `OPENAI_MODEL` | | **Local (Ollama / LM Studio / vLLM / llama.cpp)** | `OPENAI_API_KEY=local` + `OPENAI_BASE_URL=http://localhost:11434/v1` (Ollama) o `http://localhost:1234/v1` (LM Studio) + `OPENAI_MODEL=` | Cualquier cosa compatible con la API de OpenAI. Coste cero, corre en tu propio hardware. Ver [Modelos locales](#local-models-ollama--lm-studio--vllm) más abajo. | | Fallback por suscripción de Claude | `AGENTMEMORY_ALLOW_AGENT_SDK=true` | Solo opt-in. Lanza sesiones de `@anthropic-ai/claude-agent-sdk`; antes causaba recursión sin límite en el hook Stop, así que ya no es el valor por defecto. | ### Modelos locales (Ollama / LM Studio / vLLM) agentmemory habla con cualquier servidor compatible con la API de OpenAI, así que cualquier cosa que expone `/v1/chat/completions` funciona sin cambios de código. Sin claves de pago, sin nube, sin rate limits; corre enteramente en tu hardware. **Ollama** (puerto por defecto `11434`): ```bash ollama pull qwen3:8b # or qwen3:4b, gpt-oss:20b, qwen3-coder:30b, etc. ollama serve ``` ```env # ~/.agentmemory/.env OPENAI_API_KEY=ollama # any non-empty string; Ollama ignores it OPENAI_BASE_URL=http://localhost:11434/v1 OPENAI_MODEL=qwen3:8b ``` **LM Studio** (puerto por defecto `1234`): Abre LM Studio → pestaña Local Server → Start Server. Elige cualquier modelo de chat del selector (Qwen 3, gpt-oss, DeepSeek R1, etc.). ```env # ~/.agentmemory/.env OPENAI_API_KEY=lmstudio # any non-empty string; LM Studio ignores it OPENAI_BASE_URL=http://localhost:1234/v1 OPENAI_MODEL=qwen3-8b # match the model name from LM Studio ``` **vLLM / llama.cpp / Text Generation Inference**: misma forma. Apunta `OPENAI_BASE_URL` a la URL que expone tu servidor y define `OPENAI_MODEL` con un nombre que tu servidor acepte. **Elecciones de modelo para trabajo de memoria**: la compresión y el resumen son tareas cortas (<2K tokens de entrada, <500 tokens de salida) para las que un modelo instruct de 7B es más que suficiente. Recomendaciones: | Modelo | Tamaño | Por qué | |-------|------|-----| | `qwen3:8b` | ~5.2 GB | Valor por defecto equilibrado en una máquina de 16 GB; fuerte en extracción y texto con forma de tool | | `qwen3:4b` | ~2.6 GB | La opción razonable más pequeña; bien para compresión, más débil para extracción de grafo | | `qwen3-coder:30b` | ~19 GB | La mejor elección local para sesiones con forma de código (30B MoE, 3.3B activos) en hardware de 24-32 GB | | `gpt-oss:20b` | ~14 GB | Modelo general fuerte que cabe en 16 GB de RAM | | `deepseek-r1:8b` | ~5.2 GB | Distill de razonamiento; más lento pero con extracciones más limpias | Los modelos Qwen 3 piensan por defecto y pueden quemar todo el presupuesto de tokens en razonamiento antes de cualquier salida. Define `AGENTMEMORY_LLM_NOTHINK=1` para añadir `/no_think` a los prompts de extracción de grafo, y sube `MAX_TOKENS` (16384 funciona) si las extracciones vuelven vacías. Los modelos de clase reasoning (estilo `o1` con bloques ``) pueden devolver `content` vacío con un campo `reasoning` que tu servidor local puede no exponer. Si las extracciones vuelven en blanco, cambia primero a un modelo que no sea reasoning. La variable de entorno `OPENAI_REASONING_EFFORT=none` también puede desactivar el thinking en los modelos thinking de Ollama Cloud que replican el schema de reasoning de OpenAI. Los embeddings locales se incluyen como dependencia opcional pero no están activados por defecto. Define `EMBEDDING_PROVIDER=local` para optar por `Xenova/all-MiniLM-L6-v2` (384-dim). La primera petición de embedding descarga el modelo; la inferencia corre en local después. Sin ese ajuste o una clave de embedding remota, los vectores se quedan desactivados, `mem::search` usa BM25, y `smart-search` todavía puede añadir coincidencias de grafo existentes. ### Selección de modelo con conciencia de coste Cuando la compresión en segundo plano escrita por LLM está activada con un proveedor y `AGENTMEMORY_AUTO_COMPRESS=true`, corre en cada observación, así que la elección de modelo cambia de forma significativa el gasto mensual. Datos de carga de trabajo capturados: 635 peticiones / 888K tokens / 35 horas de uso activo, ejecutados contra tres modelos de OpenRouter a los precios del 2026-05-23. | Nivel | Modelo | Input / 1M | Output / 1M | Coste para las 35h capturadas | Notas | |------|-------|------------|-------------|---------------------------|-------| | Recomendado | `deepseek/deepseek-v4-flash-0731` | $0.07 | $0.14 | ~$0.07 (est.) | El DeepSeek más reciente; la elección recomendada más barata para cargas de trabajo de compresión. | | Recomendado | `deepseek/deepseek-v4-pro` | $0.435 | $0.87 | ~$0.46 | Calidad sólida de compresión + resumen a ~10× menos coste que Sonnet. | | Recomendado | `qwen/qwen3-coder` | $0.45 | $1.80 | ~$0.55 | Razonamiento de código fuerte si tus sesiones tienen una forma muy orientada a código. | | Premium | `anthropic/claude-sonnet-5` | $3.00 | $15.00 | ~$5.02 (est.) | Mismo precio de lista que la ejecución medida de Sonnet 4.6; precio de lanzamiento $2/$10 hasta el 2026-08-31. | | Premium | `openai/gpt-5.6-sol` | $5.00 | $30.00 | ~$9 (est.) | Nivel flagship; caro para trabajo en segundo plano siempre activo. | | Evitar | `anthropic/claude-opus-5` | $5.00 | $25.00 | ~$8.40 (est.) | Modelo de clase flagship; sobregasto para compresión. | Las filas medidas vienen de la ejecución capturada; las filas (est.) escalan la misma mezcla de tokens por el precio de lista de cada modelo. agentmemory imprime un aviso en runtime cuando `OPENROUTER_MODEL` coincide con un patrón de nivel premium. Define `AGENTMEMORY_SUPPRESS_COST_WARNING=1` para silenciarlo una vez que hayas tomado una decisión informada. Equilibrio entre calidad y coste para el trabajo de memoria: la compresión es una tarea de resumen con barras de calidad relativamente laxas (el agente vuelve a leer el resumen, no el usuario). DeepSeek V4 Flash / V4 Pro / Qwen3-Coder quedan dentro del margen de error de Sonnet en esta tarea mientras cuestan 10-70× menos. Reserva los modelos de nivel premium para las consultas que lees directamente. Fuentes: [precios de OpenRouter para Claude Sonnet 5](https://openrouter.ai/anthropic/claude-sonnet-5), [DeepSeek V4 Flash](https://openrouter.ai/deepseek/deepseek-v4-flash-0731), [notas de precios de DeepSeek](https://api-docs.deepseek.com/quick_start/pricing/). ### Memoria multiagente (`AGENT_ID` + `AGENTMEMORY_AGENT_SCOPE`) En montajes multiagente donde varios roles comparten un servidor agentmemory (architect / developer / reviewer / researcher / support-agent), `AGENT_ID` etiqueta cada escritura con el rol que la hizo. `AGENTMEMORY_AGENT_SCOPE` controla si el recall filtra por esa etiqueta. ```env TEAM_ID=company USER_ID=engineering-team AGENT_ID=architect AGENTMEMORY_AGENT_SCOPE=isolated # optional; default "shared" ``` Dos modos: | Modo | Etiqueta escrituras | Filtra recall | Cuándo usarlo | |------|------------|---------------|-------------| | `shared` (por defecto) | sí | no | Contexto cross-agent con pista de auditoría. El architect puede ver lo que anotó el developer, pero cada fila registra quién lo dijo. | | `isolated` | sí | sí | Separación estricta. El architect nunca ve las observaciones / memorias / sesiones del developer. | Qué se etiqueta cuando `AGENT_ID` está definido: `Session.agentId`, `RawObservation.agentId`, `CompressedObservation.agentId`, `Memory.agentId`. El rol fluye desde `api::session::start` → `mem::observe` → `mem::compress` → KV. Qué se filtra en modo isolated: `mem::smart-search`, `/agentmemory/memories`, `/agentmemory/observations`, `/agentmemory/sessions`. Cada endpoint acepta `?agentId=` para sobrescribir por petición, y `?agentId=*` para optar por salir del scope del entorno por completo. `/memories` también acepta `?includeOrphans=true` para sacar memorias previas a AGENT_ID cuyo `agentId` es undefined. Sobrescritura por llamada en la capa SDK / REST: cada endpoint que muta (`/session/start`, `/remember`) acepta un campo `agentId` en el body que gana frente al entorno. Útil para runtimes que enrutan muchos roles a un único proceso de servidor. La tool MCP `memory_save` expone el mismo campo `agentId`, el servidor stdio standalone reenvía tanto `agentId` como `project`, y las memorias guardadas llevan `agentId` al índice de búsqueda, de modo que la búsqueda con scope de agente cubre tanto memorias como observaciones. Cuando `AGENT_ID` no está definido, la memoria permanece sin scope (comportamiento legacy, sin etiquetas, sin filtros). ### Puertos agentmemory + iii-engine enlazan cuatro puertos por defecto. Si un reinicio falla con `port in use`, esta tabla te dice qué proceso buscar. | Puerto | Proceso | Propósito | Override de entorno | |------|---------|---------|--------------| | `3111` | agentmemory | REST API + MCP HTTP + `/agentmemory/health` + `/agentmemory/livez` | `III_REST_PORT` | | `3112` | iii-engine | Worker de streams interno (consumido por agentmemory + visor) | `III_STREAM_PORT` (preferido) o el legacy `III_STREAMS_PORT` | | `3113` | agentmemory | Visor en tiempo real (`http://localhost:3113`) | `III_VIEWER_PORT` o `AGENTMEMORY_VIEWER_URL` para la URL reportada | | `49134` | iii-engine | WebSocket; los workers se registran aquí, la telemetría OTel fluye por encima | `III_ENGINE_PORT` o `III_ENGINE_URL` | `--port ` cambia el ancla REST y deriva streams `N+1`, visor `N+2` y WebSocket del motor `N+46023` solo donde el puerto o URL explícito correspondiente de arriba no está definido. No crea un namespace de ciclo de vida aislado. Usa `--instance 1` para un segundo daemon; usa el ancla 3211, por defecto `3211/3212/3213/49234`, y recibe un directorio de datos y ciclo de vida `instance-1` separado. Las instancias 1 a 50 siguen el mismo patrón. El motor fijado arranca con `--no-update-check` (sin búsquedas de actualización o avisos de seguridad contra GitHub al arrancar) y con la telemetría anónima de uso de iii desactivada: agentmemory define `III_TELEMETRY_ENABLED=false` para el motor que lanza a menos que tú mismo exportes la variable, y el fichero compose empaquetado hace lo mismo. Limpieza de procesos obsoletos cuando los puertos se quedan ocupados tras una ejecución que crasheó: ```bash # macOS / Linux — find whatever is on each port and kill it lsof -i :3111,3112,3113,49134 pkill -f agentmemory || true pkill -f 'iii ' || true # Windows netstat -ano | findstr ":3111 :3112 :3113 :49134" taskkill /F /PID ``` `agentmemory stop` recoge limpiamente tanto el worker como el pidfile del motor en un shutdown nativo graceful. En modo Docker vacía el worker nativo, detiene el contenedor del motor validado exacto, y preserva tanto el contenedor como su montaje `/data` para un reinicio sin pérdida; el siguiente arranque valida y reanuda ese mismo contenedor. La desinstalación respaldada por Docker requiere `agentmemory remove --keep-data`: elimina los ficheros compartidos gestionados por agentmemory mientras preserva el contenedor validado, su montaje de datos y el registro de ciclo de vida necesario para recuperarlos. El borrado destructivo de datos de Docker se deja intencionadamente al operador tras un backup. La CLI también se niega a adoptar o señalizar como motor nativo a los tenedores de puertos de Docker o VM (backend de Docker, vpnkit, colima) a menos que se pase `--force`. La limpieza manual de arriba solo aplica al caso post-crash en el que no queda ningún pidfile. ### Fichero de configuración Pon la configuración de runtime de agentmemory en `~/.agentmemory/.env` en lugar de exportar variables en cada shell. Si el visor muestra una pista de setup tipo `export ANTHROPIC_API_KEY=...`, cópiala a este fichero como `ANTHROPIC_API_KEY=...` sin el prefijo `export`, y reinicia agentmemory. Las variables de entorno del proceso siguen funcionando y tienen prioridad sobre los valores del fichero. En Windows, el mismo fichero vive en `%USERPROFILE%\.agentmemory\.env`: ```powershell New-Item -ItemType Directory -Force $HOME\.agentmemory notepad $HOME\.agentmemory\.env ``` Para probar con una suscripción Claude Code Pro/Max en lugar de una API key, haz opt-in explícitamente: ```env AGENTMEMORY_ALLOW_AGENT_SDK=true AGENTMEMORY_AUTO_COMPRESS=true ``` La compresión de observaciones escrita por LLM requiere ambas líneas: acceso a un proveedor de LLM (incluyendo este fallback explícito de suscripción) y `AGENTMEMORY_AUTO_COMPRESS=true`. Un proveedor por sí solo deja en su lugar la ruta de compresión sintética por defecto. La consolidación (nodos de grafo, lecciones, crystals) está activada por defecto siempre que haya un proveedor de LLM configurado. Opta por salir explícitamente con `CONSOLIDATION_ENABLED=false` si quieres una operación sin LLM. La extracción de grafo es un flag separado: ```env GRAPH_EXTRACTION_ENABLED=true # CONSOLIDATION_ENABLED=false # opt out of auto-consolidation ``` ### Variables de entorno Crea `~/.agentmemory/.env`: ```env # LLM provider (pick one — default is the no-op provider: no LLM calls) # ANTHROPIC_API_KEY=sk-ant-... # ANTHROPIC_BASE_URL=... # Optional: Anthropic-compatible proxy / Azure # GEMINI_API_KEY=... # OPENROUTER_API_KEY=... # MINIMAX_API_KEY=... # OPENAI_API_KEY=*** # NOTE: this same key auto-activates BOTH the # # OpenAI LLM provider (here) AND the OpenAI # # embedding provider (further below). Set # # OPENAI_API_KEY_FOR_LLM=false to scope it # # to embeddings only. # OPENAI_BASE_URL=https://api.openai.com # Optional: override for Azure / vLLM / LM Studio / proxies # # Azure: https://.openai.azure.com/openai/deployments/ # # Auto-detected from `.openai.azure.com` hostname; uses # # api-key header + api-version query param. # OPENAI_API_VERSION=2024-08-01-preview # Optional: Azure api-version query param # OPENAI_MODEL=gpt-5.6-luna # Optional: default model # OPENAI_TIMEOUT_MS=60000 # Optional: OpenAI-scoped alias for the outbound fetch # # timeout. Takes precedence over AGENTMEMORY_LLM_TIMEOUT_MS # # for back-compat with v0.9.17. New configs should # # prefer the global AGENTMEMORY_LLM_TIMEOUT_MS below. # OPENAI_REASONING_EFFORT=none # Optional: "low" | "medium" | "high" | "none" # # Honored only by OpenAI's reasoning models (o1, o3, # # gpt-*-reasoning) and providers that mirror that # # schema (Ollama Cloud thinking models). Standard # # chat models reject this field with 400. Set to # # "none" for thinking models that return reasoning # # but no content. # OPENAI_API_KEY_FOR_LLM=false # Optional: set to false to skip OpenAI auto-detection # # for LLM (useful if you only want OpenAI for embeddings) # Opt-in Claude-subscription fallback (spawns @anthropic-ai/claude-agent-sdk); # leave OFF unless you understand the Stop-hook recursion risk: # AGENTMEMORY_ALLOW_AGENT_SDK=true # Embedding provider (BM25-only when unset; local is an explicit opt-in) # EMBEDDING_PROVIDER=local # VOYAGE_API_KEY=... # OPENAI_API_KEY=sk-... # OPENAI_BASE_URL=https://api.openai.com # Override for Azure / vLLM / LM Studio / proxies # OPENAI_EMBEDDING_MODEL=text-embedding-3-small # OPENAI_EMBEDDING_DIMENSIONS=1536 # Required when the model is not in the known-models table # OPENAI_EMBEDDING_BASE_URL=https://... # Embeddings only; falls back to OPENAI_BASE_URL # OPENAI_EMBEDDING_API_KEY=sk-... # Embeddings only; wins over OPENAI_API_KEY when set # Outbound LLM / embedding timeout # AGENTMEMORY_LLM_TIMEOUT_MS=60000 # Default: 60 000 ms (60 s). Applies to every # raw-fetch provider (Gemini, OpenRouter, MiniMax, # OpenAI LLM, OpenAI/Cohere/Voyage/OpenRouter # embedding). For the OpenAI LLM path, the # OpenAI-scoped OPENAI_TIMEOUT_MS alias (above) # takes precedence when set, for back-compat # with v0.9.17. # Increase for slow networks or large batch calls; # decrease to fail-fast on rate-limit holds. # Search tuning # BM25_WEIGHT=0.4 # VECTOR_WEIGHT=0.6 # TOKEN_BUDGET=2000 # Auth (generated into ~/.agentmemory/secret on first start when unset) # AGENTMEMORY_SECRET=your-secret # VIEWER_ALLOWED_ORIGINS=https://memory.example.com # AGENTMEMORY_IMPORT_ROOT=~/projects # Ports (defaults: 3111 API, 3113 viewer) # III_REST_PORT=3111 # Engine usage telemetry (iii). Off unless you set it; true opts in. # III_TELEMETRY_ENABLED=false # Features # AGENTMEMORY_AUTO_COMPRESS=false # OFF by default. Requires an LLM # provider as well. When both are on, # every PostToolUse hook calls your # LLM provider to compress the # observation — expect significant # token spend on active sessions. # AGENTMEMORY_SLOTS=false # OFF by default. Editable pinned # memory slots — persona, # user_preferences, tool_guidelines, # project_context, guidance, # pending_items, session_patterns, # self_notes. Size-limited; agent # edits via memory_slot_* tools. # Pinned slots addressable for # SessionStart injection. # AGENTMEMORY_REFLECT=false # OFF by default. Requires SLOTS=on. # Stop hook fires mem::slot-reflect: # scans recent observations, auto- # appends TODOs to pending_items, # counts patterns in # session_patterns, records touched # files in project_context. Fire- # and-forget; does not block. # AGENTMEMORY_INJECT_CONTEXT=false # OFF by default. When on: # - SessionStart may inject ~1-2K # chars of project context into # the first turn of each session # (this is what actually reaches # the model — Claude Code treats # SessionStart stdout as context) # - PreToolUse fires /agentmemory/enrich # on every file-touching tool call # (resource cleanup, not a token # fix — PreToolUse stdout is debug # log only per Claude Code docs) # Observations are still captured via # PostToolUse regardless of this flag. # GRAPH_EXTRACTION_ENABLED=false # AGENTMEMORY_LLM_NOTHINK=1 # Local reasoning models only: ask the # model to skip its hidden thinking pass # during graph extraction. Faster runs; # relation quality can drop slightly. # CONSOLIDATION_ENABLED=false # on by default when an LLM provider is configured # LESSON_DECAY_ENABLED=true # OBSIDIAN_AUTO_EXPORT=false # AGENTMEMORY_EXPORT_ROOT=~/.agentmemory # CLAUDE_MEMORY_BRIDGE=false # SNAPSHOT_ENABLED=false # Storage and durability # AGENTMEMORY_STATE_BACKEND=file # file (default) or redis; see "Storage backend" below # AGENTMEMORY_REDIS_URL=redis://localhost:6379 # Required with redis, plain redis:// only # AGENTMEMORY_STATE_SAVE_INTERVAL_MS=2000 # How often the engine writes file state to disk. # A hard kill loses at most this window. # AGENTMEMORY_INDEX_SAVE_INTERVAL_MS=600000 # Minimum time between search index saves; # shutdown and deletes still save at once. # AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=true # One-time background trim of oversized graph # provenance; false skips it # Sessions # AGENTMEMORY_SESSION_SWEEP_ENABLED=true # Hourly sweep marks sessions left active past # the threshold as abandoned. Deletes nothing; # new activity makes the session active again. # AGENTMEMORY_SESSION_SWEEP_STALE_HOURS=24 # Capture filters (hooks) # AGENTMEMORY_CAPTURE_ALLOW= # Comma or space list of tool names or globs; # when set, only these tools are captured # AGENTMEMORY_CAPTURE_DENY= # Extra names or globs to skip, added to the # defaults: memory_*, toolsearch, # listmcpresources, fetchmcpresource # AGENTMEMORY_CAPTURE_OUTPUT_MAX=8000 # Max characters of tool output per observation # AGENTMEMORY_PRE_COMPACT_BUDGET=1500 # Token budget for PreCompact context; 0 disables # Audit log # AGENTMEMORY_AUDIT_RETENTION_MONTHS=0 # Drop month scopes older than N months; 0 keeps all # AGENTMEMORY_AUDIT_INDEX_PERSIST=false # 1 or true records index migration and cleanup # rows (debugging only) # Team # TEAM_ID= # USER_ID= # TEAM_MODE=private # Tool visibility: "all" (54 tools, default) or "core" (8 tools, lean) # AGENTMEMORY_TOOLS=core ``` ---

API

138 endpoints en el puerto `3111`. La REST API se enlaza a `127.0.0.1` por defecto. Los endpoints protegidos requieren `Authorization: Bearer `, y los endpoints de mesh sync requieren un `AGENTMEMORY_SECRET` definido explícitamente en ambos peers. **La autenticación está activada por defecto.** Cuando `AGENTMEMORY_SECRET` no está definida (ni en el shell ni en `~/.agentmemory/.env`), el servidor genera un secreto aleatorio en el primer arranque y lo guarda en `~/.agentmemory/secret` con modo `0600`. Todos los clientes empaquetados lo leen desde ahí cuando hablan con un servidor local: la CLI, el visor, los hooks bajo `plugin/scripts`, el servidor MCP y el shim `@agentmemory/mcp`, las configs escritas por `agentmemory connect`, y las integraciones empaquetadas de OpenCode, Pi, OpenClaw, Hermes y filesystem-watcher. El secreto guardado solo se envía a URLs de loopback (`localhost`, `127.0.0.0/8`, `::1`). Un `AGENTMEMORY_SECRET` explícito siempre gana, y los clientes remotos igualmente necesitan tenerlo definido. Docker y los entrypoints de `deploy/` ya generan y exportan su propio secreto. Para llamar a la API a mano: ```bash curl -H "Authorization: Bearer $(cat ~/.agentmemory/secret)" http://localhost:3111/agentmemory/health ``` **Reglas de petición para escrituras.** Las peticiones `POST`, `PUT`, `PATCH` y `DELETE` a la REST API y al visor deben enviar `Content-Type: application/json` (un parámetro `charset` está bien) siempre que lleven body, y una cabecera `Origin`, cuando está presente, debe ser un origen de loopback para el puerto REST o del visor configurado, o estar listada en `VIEWER_ALLOWED_ORIGINS` (separados por comas, p. ej. `https://memory.example.com`). Los clientes que no envían cabecera `Origin` (CLI, hooks, MCP, curl, server-to-server) no se ven afectados. El visor también acepta su propio origen. **Rutas de fichero.** Los endpoints que leen o escriben ficheros (`/compress-file`, `/replay/import-jsonl`, `/graph/import-graphify`) solo aceptan rutas bajo `~/.agentmemory`, el directorio de datos de la instancia, o un directorio listado en `AGENTMEMORY_IMPORT_ROOT` (separa varios con `:`, o `;` en Windows). `/replay/import-jsonl` también acepta su valor por defecto `~/.claude/projects`. `/obsidian/export` se mantiene dentro de `AGENTMEMORY_EXPORT_ROOT` y `/migrate` dentro de `~/.agentmemory`. Los symlinks se resuelven antes de cada comprobación. **Eliminación de secretos.** Las API keys, bearer tokens, bloques de clave privada PEM y credenciales embebidas en URLs (`scheme://user:password@host`) se redactan antes de almacenar el texto, en cada ruta de escritura: observations, remember, evolve, slots, lessons, actions, sketches, signals, checkpoints, imports, jsonl replay, mesh sync, team shares, salida de compresión y resumen, crystals y nodos de grafo.
Endpoints principales | Method | Path | Descripción | |--------|------|-------------| | `GET` | `/agentmemory/health` | Comprobación de salud (siempre pública) | | `GET` | `/agentmemory/status` | Qué va mal y cómo arreglarlo (HTML para navegadores, JSON en el resto de casos) | | `GET` | `/agentmemory/viewer/snapshot` | Todo lo que muestra el visor, en una sola respuesta | | `POST` | `/agentmemory/session/start` | Arranca sesión + obtiene contexto | | `POST` | `/agentmemory/session/end` | Termina sesión | | `POST` | `/agentmemory/observe` | Captura observación (ver entrega de captura más abajo) | | `GET` | `/agentmemory/capture` | Inbox de captura, dead letters y spool offline | | `POST` | `/agentmemory/capture/retry` | Reintenta capturas dead-letter | | `POST` | `/agentmemory/capture/drain` | Envía ahora el spool offline local | | `POST` | `/agentmemory/smart-search` | Búsqueda híbrida | | `POST` | `/agentmemory/context` | Genera contexto | | `POST` | `/agentmemory/remember` | Guarda en memoria a largo plazo | | `POST` | `/agentmemory/forget` | Borra observaciones | | `POST` | `/agentmemory/enrich` | Contexto de fichero + memorias + bugs | | `GET` | `/agentmemory/profile` | Perfil de proyecto | | `GET` | `/agentmemory/export` | Exporta todos los datos | | `POST` | `/agentmemory/import` | Importa desde JSON | | `POST` | `/agentmemory/graph/query` | Consulta del grafo de conocimiento | | `POST` | `/agentmemory/graph/compact` | Recorta provenance de grafo sobredimensionado | | `POST` | `/agentmemory/team/share` | Comparte con el equipo | | `GET` | `/agentmemory/audit` | Pista de auditoría | Lista completa de endpoints: [`src/triggers/api.ts`](../src/triggers/api.ts)
**Entrega de captura.** Los hooks envían cada observación una vez a `POST /agentmemory/observe` con un `eventId`. Es el id propio del host para la llamada cuando el payload tiene uno (por ejemplo el `tool_use_id` de Claude Code), o si no, un hash de la sesión, el tipo de hook, el nombre de la tool, la entrada, la salida y el timestamp del host. El servidor escribe el evento en un inbox de captura en el state store, almacena la observación, y luego elimina la entrada del inbox. El código de estado indica qué pasó: | Status | campo `status` | Significado | |---|---|---| | `201` | `accepted` | Almacenado. `observationId` es la nueva observación. | | `202` | `accepted` (`state: "retrying"`) | Aceptado, pero el almacenado falló. El servidor lo reintenta, también tras un reinicio. | | `200` | `duplicate` | Este `eventId` ya fue aceptado. `observationId` es la observación existente; no se almacena nada nuevo. | | `400` / `422` | `rejected` | Payload inválido, o el almacenado falló definitivamente (el evento se guarda como dead letter). | | `503` | `rejected` (`retryable: true`) | El inbox está lleno (`AGENTMEMORY_CAPTURE_INBOX_MAX`). Los hooks almacenan el evento en el spool y lo envían después. | Los eventos fallidos se reintentan cada `AGENTMEMORY_CAPTURE_RETRY_INTERVAL_MS` (10 s) con backoff que se duplica, hasta `AGENTMEMORY_CAPTURE_MAX_ATTEMPTS` (5). Los eventos que siguen fallando se quedan en el inbox como dead letters, aparecen listados en `/agentmemory/status` y en la página Health del visor, y se pueden reintentar con `POST /agentmemory/capture/retry` (`{"eventId": "..."}` o `{"all": true}`). Los ids de evento aceptados se recuerdan durante `AGENTMEMORY_CAPTURE_DEDUP_HOURS` (168 horas, como máximo `AGENTMEMORY_CAPTURE_EVENTS_MAX` ids), así que un hook repetido tras un timeout o un reinicio se almacena una vez, mientras que dos llamadas a tool separadas con sus propios ids de host se almacenan dos veces aunque su contenido sea idéntico. Cuando una observación se borra (forget, borrado de sesión, eviction, auto-forget o un import que reemplaza el store), su evento se marca como borrado antes de eliminar la observación, así que repetir ese evento dentro de la misma ventana se responde como duplicado y no almacena nada. El state store escribe a disco cada 2 segundos, así que un evento respondido todavía puede estar solo en memoria por un instante. Para cubrir eso, cada respuesta `2xx` también lleva el `bootId` del servidor (nuevo en cada arranque), `acceptedAt` y `durableAfterMs` (el intervalo de guardado más 1.5 s en el file store, 1.5 s en redis, donde la persistencia es un ajuste del operador). Los hooks mantienen el evento en el spool local hasta que pasa esa ventana y lo borran en una llamada posterior sin otra petición. Si el `bootId` ha cambiado para entonces, el servidor se reinició, así que el hook envía el evento de nuevo con el mismo `eventId`; un evento que sí llegó a disco no se almacena dos veces. El servidor también envía esos eventos por sí mismo al arrancar y en cada intervalo de reintento, así que un reinicio no pierde nada aunque ningún hook corra después. Los hooks antiguos ignoran los campos extra, y los hooks nuevos contra un servidor más antiguo descartan el evento en `2xx` como antes. Cuando el servidor está caído, no responde a tiempo o devuelve un 5xx, el hook añade la observación a un fichero de spool local, `/capture-spool/-.jsonl` (sobrescribe la carpeta con `AGENTMEMORY_CAPTURE_SPOOL_DIR`). El fichero es privado para tu usuario (modo 600), los secretos se redactan de la misma forma que los redacta el servidor, contiene como máximo `AGENTMEMORY_CAPTURE_SPOOL_MAX_BYTES` (5 MiB) y descarta entradas más viejas que `AGENTMEMORY_CAPTURE_SPOOL_MAX_AGE_HOURS` (168). Cuando está lleno, las entradas nuevas se descartan y se cuentan, y `/agentmemory/status` lo reporta. El hook sigue saliendo con código 0 dentro de su límite de tiempo y no añade ninguna petición cuando el servidor está sano. El spool se envía en el siguiente arranque y por el primer hook que vuelve a alcanzar el servidor, en un proceso en segundo plano para que el agente no espere. Los ids de evento hacen esto seguro: una observación que sí llegó antes de un timeout no se almacena dos veces. `npx @agentmemory/agentmemory capture` muestra el spool y el inbox del servidor, `--drain` envía el spool ahora, y `GET /agentmemory/capture` devuelve lo mismo como JSON. Define `AGENTMEMORY_CAPTURE_SPOOL=false` para desactivar el spool. **Compactación de provenance del grafo.** Cada nodo y edge del grafo de conocimiento guarda los ids de las 32 observaciones más recientes de las que proviene. Los stores escritos antes de ese tope pueden contener miles de ids por nodo caliente, lo que ralentiza la búsqueda de grafo y el visor, o tira el worker. agentmemory soluciona esto por sí mismo: en el primer arranque tras actualizar, recorta cada nodo, edge, edge reemplazado (el historial temporal del grafo) y el snapshot cacheado hasta el tope en segundo plano, en pequeños slices con una pausa entre ellos, para que la búsqueda, la captura y el visor sigan funcionando. Guarda su progreso, se reanuda tras un reinicio y nunca vuelve a correr una vez que ha terminado. `/agentmemory/status` y la página Health del visor lo muestran como pending, running (con el scope y la posición actuales), done o failed. Define `AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=false` para desactivarlo. Para ejecutarlo a mano, llama a `POST /agentmemory/graph/compact`. Recorre los índices de nombre y de clave de edge en lugar de listar cada nodo y edge, y es seguro volver a ejecutarlo. Cuando recorta ids escribe una entrada de auditoría `graph_compact`. ```bash curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{}' ``` En un store grande, o cuando la llamada devuelve 504, ejecútalo en slices. Envía `scope` (`nodes`, `edges` o `history`), `offset` y `limit`, y luego vuelve a llamar con el `nextOffset` devuelto hasta que sea `null`. Haz esto para `nodes`, `edges` y `history`, y termina con una llamada `{"scope":"snapshot"}`, porque una ejecución en slices no toca el snapshot cacheado. ```bash curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"nodes","offset":0,"limit":200}' curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"snapshot"}' ``` ---

Desarrollo

```bash npm run dev # Hot reload npm run build # Production build npm test # 2,500+ tests npm run test:integration # API tests (requires running services) ``` **Requisitos previos:** Node.js >= 20 con npm/npx; [iii-engine](https://iii.dev/docs) v0.22.1 o Docker. La instalación automática del motor en macOS/Linux también requiere `curl`, un `sh` POSIX y `tar`; Windows nativo usa el `iii.exe` fijado manual, WSL2 o Docker Desktop.

Licencia

[Apache-2.0](../LICENSE)