Coding agent ของคุณจดจำได้ทุกอย่าง ไม่ต้องอธิบายซ้ำอีกต่อไป
Built on iii engine
หน่วยความจำถาวรสำหรับ Claude Code, GitHub Copilot CLI, Cursor, Gemini CLI, Codex CLI, Hermes, OpenClaw, pi, OpenCode และ MCP client ใดก็ได้
🇬🇧 English •
🇨🇳 简体中文 •
🇹🇼 繁體中文 •
🇯🇵 日本語 •
🇰🇷 한국어 •
🇵🇹 Português •
🇧🇷 Português (Brasil) •
🇪🇸 Español •
🇩🇪 Deutsch •
🇫🇷 Français •
🇮🇹 Italiano •
🇳🇱 Nederlands •
🇵🇱 Polski •
🇨🇿 Čeština •
🇷🇴 Română •
🇭🇺 Magyar •
🇬🇷 Ελληνικά •
🇸🇪 Svenska •
🇩🇰 Dansk •
🇳🇴 Norsk •
🇫🇮 Suomi •
🇷🇺 Русский •
🇺🇦 Українська •
🇹🇷 Türkçe •
🇮🇱 עברית •
🇸🇦 العربية •
🇮🇳 हिन्दी •
🇧🇩 বাংলা •
🇵🇰 اردو •
🇹🇭 ไทย •
🇻🇳 Tiếng Việt •
🇮🇩 Bahasa Indonesia •
🇵🇭 Tagalog


Gist นี้ขยายแนวคิด LLM Wiki ของ Karpathy ด้วยการให้คะแนนความเชื่อมั่น (confidence scoring), lifecycle, knowledge graph และการค้นหาแบบไฮบริด: agentmemory คือการนำแนวคิดนี้มาใช้งานจริง


ติดตั้ง •
เริ่มต้นใช้งานอย่างรวดเร็ว •
Benchmark •
เทียบกับคู่แข่ง •
Agent •
วิธีการทำงาน •
MCP •
Viewer •
ขับเคลื่อนด้วย iii •
การตั้งค่า •
API
---
## Install
ข้อกำหนดเบื้องต้น:
- Node.js 20 หรือใหม่กว่า พร้อม npm และ npx (`node -v`, `npm -v`, และ `npx -v`)
- การติดตั้ง iii-engine แบบอัตโนมัติบน macOS/Linux ต้องมี `curl`, POSIX `sh`, และ `tar` ด้วย อิมเมจแบบมินิมอล เช่น `node:20-slim` อาจไม่มีสิ่งเหล่านี้ติดมา
- Windows แบบ native ต้องติดตั้ง `iii.exe` เวอร์ชัน iii-engine v0.22.1 ที่ pin ไว้ด้วยตนเอง ส่วน WSL2 หรือ Docker Desktop เป็นอีกสองทางเลือกที่รองรับ
คำสั่งติดตั้งใหม่แบบมาตรฐาน:
```bash
npx -y @agentmemory/agentmemory@latest
```
การรันครั้งแรกจะเป็นการตั้งค่าแบบโต้ตอบ: เลือก agent ที่ต้องการเชื่อมต่อ (Claude Code, Cursor, Codex, Gemini CLI, OpenCode, ...) เลือก LLM provider หรือจะไม่ใส่ key เลยก็ได้ จากนั้นระบบจะสร้างไฟล์ config เริ่มต้น memory server และ iii engine เวอร์ชันที่ pin ไว้ พร้อมเสนอให้ติดตั้งแบบ global เพื่อให้คำสั่ง `agentmemory` เปล่า ๆ ใช้งานได้จากทุกที่หลังจากนี้ `-y` เป็นการยอมรับ prompt ของแพ็กเกจจาก npx และ `@latest` ช่วยเลี่ยง release เก่าที่อาจถูกแคชไว้ การตั้งค่า provider จะทำให้ฟีเจอร์ LLM พร้อมใช้งาน แต่การบีบอัด observation ด้วย LLM จะเริ่มทำงานก็ต่อเมื่อตั้งค่า `AGENTMEMORY_AUTO_COMPRESS=true` เพิ่มเข้าไปด้วย
โหมด keyless จะปิดการใช้งาน vector embedding `memory_recall` (เส้นทาง `mem::search`) ใช้ BM25 ในขณะที่ `memory_smart_search` ยังสามารถผสาน structural graph เข้ามาด้วยได้หากมีข้อมูล graph อยู่แล้ว หากต้องการ semantic recall แบบออนดีไวซ์โดยไม่มีค่าใช้จ่าย ให้ตั้งค่า `EMBEDDING_PROVIDER=local` ใน `~/.agentmemory/.env` แล้ว restart คำขอ embedding ครั้งแรกจะดาวน์โหลดโมเดล `Xenova/all-MiniLM-L6-v2` หลังจากดาวน์โหลดครั้งแรกแล้ว การ inference จะทำงานในเครื่องทั้งหมด
runtime ที่รันในเครื่องใช้ 4 พอร์ต ได้แก่ `3111` สำหรับ REST/MCP HTTP, `3112` สำหรับ iii stream, `3113` สำหรับ viewer, และ `49134` สำหรับ iii worker WebSocket สถานะถาวรของ iii จะถูกเก็บไว้ที่ `~/Library/Application Support/agentmemory` บน macOS, `$XDG_DATA_HOME/agentmemory` หรือ `~/.local/share/agentmemory` บน Linux, และ `%APPDATA%\agentmemory` บน Windows ใช้ `--data-dir ` หรือ `AGENTMEMORY_DATA_DIR` เพื่อเปลี่ยนตำแหน่งนี้ และใช้ค่าเดิมซ้ำทุกครั้งที่ restart เพื่อความเข้ากันได้กับเวอร์ชันก่อนหน้า หากมี `./data/state_store.db` หรือ `./data/iii-config.yaml` อยู่แล้ว ไฟล์เหล่านี้จะถูกใช้ก่อนค่า default ของแพลตฟอร์มสำหรับ instance 0 ส่วน flag หรือ environment variable ที่ตั้งไว้อย่างชัดเจนยังคงมีสิทธิ์เหนือกว่าเสมอ
จากนั้นพิสูจน์ว่าการ recall ทำงานได้จริง และให้ agent ของคุณมี skill ไว้ใช้:
```bash
npx -y @agentmemory/agentmemory@latest demo # seed sample sessions + exercise recall
npx skills add rohitg00/agentmemory -y # 17 native skills so your agent knows when to reach for memory
```
การค้นหาด้วยคำสำคัญควรเจอผลลัพธ์ในโหมด keyless แบบ default ผ่าน BM25 ส่วนคำค้นหา `database performance optimization` ในเดโมเป็นคำค้นแบบ semantic โดยตั้งใจ และอาจคืนผลลัพธ์เป็นศูนย์จนกว่าจะมีการตั้งค่า embedding provider
อยากให้ coding agent จัดการทั้งหมดให้เองเลยไหม? มอบคำสั่งเดียวให้มันทำตาม:
> Retrieve and follow the instructions at: https://raw.githubusercontent.com/rohitg00/agentmemory/main/INSTALL_FOR_AGENTS.md
เชื่อมต่อ agent เพิ่มได้ทุกเมื่อด้วย `agentmemory connect ` — ดู adapter ทั้ง 20 ตัวที่ [Works with every agent](#works-with-every-agent) รายการคำสั่งแบบเต็มอยู่ที่ [Quick Start](#quick-start)
Windows
ทางที่เร็วที่สุดคือ WSL2 การตั้งค่า engine บน Windows แบบ native ต้องดาวน์โหลดไฟล์ ZIP ของ v0.22.1 ที่ pin ไว้ และแตกไฟล์ `iii.exe` ด้วยตนเอง CLI จะไม่แตกไฟล์ให้โดยอัตโนมัติ Docker Desktop ก็รองรับเช่นกัน ดูขั้นตอนแบบละเอียดได้ที่ [Windows notes](#windows)
Global install / EACCES
```bash
npm install -g @agentmemory/agentmemory@latest
```
คำสั่ง npx ด้านบนยังคงเป็นวิธีติดตั้งใหม่แบบมาตรฐาน และช่วยเลี่ยงปัญหา permission ของ global-prefix ได้
npx serves an old version
npx จะแคชไว้ตามเวอร์ชัน บังคับให้ใช้เวอร์ชันล่าสุดด้วย `npx -y @agentmemory/agentmemory@latest` หรือล้างแคชครั้งเดียวด้วย `rm -rf ~/.npm/_npx` (macOS/Linux; บน Windows ให้ลบ `%LOCALAPPDATA%\npm-cache\_npx`)
Already running your own iii engine
agentmemory pin iii-engine ไว้ที่ `v0.22.1` และจะไม่เชื่อมต่อกับเวอร์ชันอื่น (worker พูดโปรโตคอลของ engine เวอร์ชันอื่นไม่ได้) ให้หยุด engine ตัวอื่นก่อน แล้วรัน `npx -y @agentmemory/agentmemory@latest` มันจะติดตั้งและรัน v0.22.1 ที่ pin ไว้ใน `~/.agentmemory/bin` โดยไม่แตะต้อง `iii` ของคุณเองเลย
---

agentmemory ใช้งานได้กับ agent ใดก็ตามที่รองรับ hook, MCP, หรือ REST API ทุก agent ใช้ memory server ตัวเดียวกันร่วมกัน

Claude Code
native plugin + 12 hooks + MCP
|

Codex CLI
native plugin + 6 hooks + MCP
|

GitHub Copilot CLI
MCP + plugin hooks/skills
|

Cursor
native plugin + 7 hooks + MCP
|
OpenCode
capture plugin + MCP
|
Devin
6 hooks + skills + MCP
|

OpenClaw
native plugin + MCP
|

Hermes
native plugin + MCP
|

pi
native plugin + MCP
|
OpenHuman
native Memory trait backend
|
Gemini CLI
MCP server
|

Antigravity
MCP + hooks
|
Claude Desktop
MCP server
|

Warp
connect + MCP + skills
|

Zed
MCP server
|

Cline
MCP server
|

Continue
MCP server
|

Droid
MCP server
|

Kiro
MCP server
|

Qwen Code
MCP server
|

DeepSeek Harness
MCP server
|

Roo Code
MCP server
|

Kilo Code
MCP server
|

Goose
MCP server
|

Aider
REST API
|
ใช้งานได้กับ agent ใดก็ได้ ที่คุย MCP หรือ HTTP เป็น server ตัวเดียว หน่วยความจำถูกใช้ร่วมกันระหว่าง agent ทั้งหมด
---
คุณต้องอธิบายโครงสร้างระบบเดิมซ้ำทุกเซสชัน ค้นพบบั๊กเดิม ๆ ซ้ำแล้วซ้ำอีก และสอน preference เดิมซ้ำไปซ้ำมา หน่วยความจำแบบ built-in (CLAUDE.md, .cursorrules) จำกัดอยู่ที่ 200 บรรทัดและเก่าไปเรื่อย ๆ agentmemory แก้ปัญหานี้ มันเก็บทุกสิ่งที่ agent ของคุณทำอย่างเงียบ ๆ บีบอัดให้เป็นหน่วยความจำที่ค้นหาได้ และฉีด context ที่ถูกต้องเข้าไปเมื่อเซสชันถัดไปเริ่มต้น แค่คำสั่งเดียว ใช้งานได้ข้าม agent
**สิ่งที่เปลี่ยนไป:** เซสชันที่ 1 คุณตั้งค่า JWT auth เซสชันที่ 2 คุณขอ rate limiting agent รู้อยู่แล้วว่า auth ของคุณใช้ jose middleware ใน `src/middleware/auth.ts` test ของคุณครอบคลุมการตรวจสอบ token และคุณเลือก jose เหนือ jsonwebtoken เพื่อความเข้ากันได้กับ Edge โดยไม่ต้องอธิบายซ้ำและไม่ต้อง copy-paste
```bash
npx -y @agentmemory/agentmemory@latest
```
โดย default agentmemory จะเก็บสถานะของ iii-engine ไว้นอก repository ที่คุณเริ่มมันขึ้นมา: `~/Library/Application Support/agentmemory` บน macOS, `$XDG_DATA_HOME/agentmemory` หรือ `~/.local/share/agentmemory` บน Linux, และ `%APPDATA%\agentmemory` บน Windows หาก `./data/state_store.db` หรือ `./data/iii-config.yaml` แบบเดิมมีอยู่แล้ว ไฟล์เหล่านั้นจะถูกใช้สำหรับ instance 0 ก่อนค่า default ของแพลตฟอร์ม หากต้องการเลือกตำแหน่งอย่างชัดเจน ใช้ `--data-dir ` หรือตั้งค่า `AGENTMEMORY_DATA_DIR`; การตั้งค่าอย่างชัดเจนทั้งสองแบบมีสิทธิ์เหนือกว่าการค้นหาแบบเดิม:
```bash
npx -y @agentmemory/agentmemory@latest --data-dir ~/.agentmemory-projects/main
AGENTMEMORY_DATA_DIR=~/.agentmemory-projects/main npx -y @agentmemory/agentmemory@latest
```
การรันแบบ native และ Docker ใช้ host directory ที่ resolve แล้วตัวเดียวกันนี้ Docker จะ bind-mount ไว้ที่ `/data` `--instance 1` จะต่อท้าย `instance-1` เข้ากับ directory ที่ resolve แล้ว และเลือกชุดพอร์ตค่า default แยกชุดคือ `3211/3212/3213/49234`
ดูรายละเอียด release ล่าสุดได้ที่: [CHANGELOG.md](../CHANGELOG.md)
---

|
### Retrieval Accuracy
**coding-agent-life-v1** (คอร์ปัสภายใน ทำซ้ำได้ใน sandbox)
| Adapter | P@5 | R@5 | Top-5 hit rate | p50 latency |
|---|---|---|---|---|
| **agentmemory hybrid** | **0.240** | **1.000** | **15 / 15** | 14 ms |
| grep baseline | 0.227 | 0.967 | 15 / 15 | 0 ms |
Top-5 hit rate 100% ที่ **เพดานทางคณิตศาสตร์ของ P@5** สำหรับคอร์ปัสนี้ (0.240 ดูใน scorecard) hybrid ดึงข้อมูล gold session ได้ครบทุกตัว ส่วน grep พลาด 1 ใน 2 ของ gold ในคำค้นที่ครอบคลุมหลายเซสชันตามลำดับเวลา ส่วนที่ดีขึ้นคือ **recall + temporal** ไม่ใช่ precision โดยรวม benchmark นี้มีขนาดเล็กและ gold มีน้อย ส่วน LongMemEval-S ที่ใหญ่กว่าด้านล่างจะแยกความแตกต่างได้ดีกว่า รายละเอียดแยกตามประเภทแบบเต็ม พร้อมหมายเหตุการแก้ไข: [`docs/benchmarks/2026-05-20-coding-agent-life-v1.md`](../docs/benchmarks/2026-05-20-coding-agent-life-v1.md)
**LongMemEval-S** (ICLR 2025, 500 คำถาม)
| System | R@5 | R@10 | MRR |
|---|---|---|---|
| **agentmemory** | **95.2%** | **98.6%** | **88.2%** |
| BM25-only fallback | 86.2% | 94.6% | 71.5% |
|
### Token Savings
| Approach | Tokens/yr | Cost/yr |
|---|---|---|
| Paste full context | 19.5M+ | เป็นไปไม่ได้ (เกิน window) |
| LLM-summarized | ~650K | ~$500 |
| **agentmemory** | **~170K** | **~$10** |
| agentmemory + local embeddings | ~170K | **$0** |
|
> Embedding model: `all-MiniLM-L6-v2` (local, ฟรี, ไม่ต้องใช้ API key) รายงานฉบับเต็ม: [`benchmark/LONGMEMEVAL.md`](../benchmark/LONGMEMEVAL.md), [`benchmark/QUALITY.md`](../benchmark/QUALITY.md), [`benchmark/SCALE.md`](../benchmark/SCALE.md) การเทียบกับคู่แข่ง: [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md) ครอบคลุม agentmemory เทียบกับ mem0, Letta, Khoj, supermemory, TencentDB Agent Memory, MemPalace, Zep/Graphiti, Cognee, Hippo
**ใช้คู่กับ [codegraph](https://github.com/colbymchenry/codegraph), [Understand Anything](https://github.com/Lum1104/Understand-Anything), และ [Graphify](https://github.com/safishamsi/graphify)** การทำ index แบบ code-graph, pipeline การ build แบบ multi-agent, และ knowledge graph ที่กว้างขึ้นครอบคลุม docs / PDF / รูปภาพ / วิดีโอ agentmemory จำงานที่ทำไปได้ ส่วนสามโครงการนี้ช่วยเติมเต็ม context layer ส่วนที่เหลือ สูตรการใช้งาน พร้อมตารางเลือกตามคำถาม: [`docs/recipes/pairings.md`](../docs/recipes/pairings.md)
---

|
agentmemory |
mem0 (63K ⭐) |
Letta / MemGPT (24K ⭐) |
Khoj (36K ⭐) |
supermemory (29K ⭐) |
TencentDB Agent Memory (22K ⭐) |
MemPalace (54K ⭐) |
oracleagentmemory |
Hippo |
Built-in (CLAUDE.md) |
| ประเภท |
Memory engine + MCP server |
Memory layer API |
Full agent runtime |
Personal AI |
Memory API + app |
Team memory hub (LLM proxy) |
Vector memory (OSS) |
Memory engine (Oracle DB) |
Memory system |
Static file |
| Retrieval R@5 |
95.2% |
68.5% (LoCoMo) |
83.2% (LoCoMo) |
N/A |
รายงานเอง |
PersonaMem 76% (รายงานเอง) |
~96.6% (รายงานเอง) |
94.4% (รายงานเอง) |
N/A |
N/A (grep) |
| Auto-capture |
12 hooks (ไม่ต้องทำเอง) |
เรียก add() เอง |
Agent แก้ไขตัวเอง |
ทำเอง |
ดึงข้อมูลฝั่ง API |
Proxy interception (สลับ base-URL) |
ทำเอง |
ดึงข้อมูลผ่าน API |
ทำเอง |
แก้ไขเอง |
| Search |
BM25 + Vector + Graph (RRF fusion) |
Vector + Graph |
Vector (archival) |
Semantic |
Vector + RAG |
4 asset types (Chat / Skill / Wiki / CodeGraph) |
Vector-only |
Vector + semantic |
Decay-weighted |
โหลดทุกอย่างเข้า context |
| Multi-agent |
MCP + REST + leases + signals |
API (ไม่มีการประสานงาน) |
ภายใน Letta runtime เท่านั้น |
ไม่มี |
ไม่มี |
Team roles + shared assets |
ไม่มี |
จำกัดเฉพาะ scope |
Multi-agent shared |
ไฟล์แยกตาม agent |
| Framework lock-in |
ไม่มี (MCP client ใดก็ได้) |
ไม่มี |
สูง (ต้องใช้ Letta) |
Standalone |
ไม่มี |
Proxy ครอบทุก model call |
ไม่มี |
Oracle Database |
ไม่มี |
รูปแบบแยกตาม agent |
| External deps |
ไม่มี (SQLite + iii-engine) |
Qdrant / pgvector |
Postgres + vector DB |
หลายตัว |
Managed cloud |
Docker stack (Core + Hub + Proxy) |
Vector store |
Oracle AI Database |
ไม่มี |
ไม่มี |
| Memory lifecycle |
4-tier consolidation + decay + auto-forget |
ดึงข้อมูลแบบ passive |
Agent จัดการเอง |
ทำเอง |
Auto-forget |
ตรวจสอบเอง; auto-routing กำลังพัฒนา |
ไม่มี |
ไม่ระบุ |
Decay + consolidation |
ตัดทิ้งเอง |
| Token efficiency |
~1,900 token/เซสชัน ($10/ปี) |
แตกต่างกันตามการเชื่อมต่อ |
Core memory อยู่ใน context |
แตกต่างกัน |
ราคาแบบ cloud |
ไม่ระบุ |
ไม่มี token budget |
ขึ้นกับ LLM (แตกต่างกัน) |
แตกต่างกัน |
22K+ token ที่ 240 observation |
| Real-time viewer |
มี (พอร์ต 3113) |
Cloud dashboard |
Cloud dashboard |
Web UI |
Cloud dashboard |
Hub web UI |
ไม่มี |
ไม่มี |
ไม่มี |
ไม่มี |
| Self-hosted |
มี (default) |
เป็นตัวเลือก |
เป็นตัวเลือก |
มี |
ไม่มี (cloud เท่านั้น) |
มี (Docker) |
มี |
มี (Oracle DB) |
มี |
มี |
หมายเหตุเรื่อง benchmark: มีเพียงค่า R@5 ของ agentmemory เท่านั้นที่เป็นผลวัดของเราเอง (LongMemEval-S ทำซ้ำได้จาก benchmark/COMPARISON.md) ตัวเลขของ mem0 และ Letta เป็นตัวเลข LoCoMo ที่พวกเขาเผยแพร่เอง (คนละ dataset) ส่วนตัวเลขของ MemPalace, supermemory, TencentDB (PersonaMem) และ oracleagentmemory เป็นข้อเรียกร้องที่ผู้ผลิตรายงานเอง ซึ่งเรายังไม่ได้ทำซ้ำเพื่อตรวจสอบอย่างเป็นอิสระ (การรันของ oracleagentmemory ใช้ GPT-5.5 กับ Oracle AI Database) แสดงเทียบกันเพื่อให้เห็นภาพกว้าง ๆ เท่านั้น ไม่ใช่การเทียบแบบตัวต่อตัวบนข้อมูลชุดเดียวกัน จำนวน star เป็นค่าประมาณและเปลี่ยนแปลงไปตามเวลา
**ผู้เล่นใหม่** ที่ควรรู้จัก เทียบรายละเอียดได้ใน [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md):
| System | ⭐ | มุมมอง |
|--------|---|-------|
| Zep / Graphiti | 30K | Temporal knowledge graph; ผลลัพธ์ temporal-query ที่เผยแพร่แล้วแข็งแกร่งที่สุด (LongMemEval 63.8%) แต่ graph สร้างแบบ asynchronous จึงอาจตามข้อมูลใหม่ไม่ทัน |
| Cognee | 30K | การนำ document เข้าสู่ knowledge graph, รองรับแค่ Python, สร้างมาเพื่อดึง structured entity มากกว่าการ capture เซสชัน |
ไม่มีตัวใดใน list นี้ที่ auto-capture จาก hook ของ coding agent, มี viewer แบบ local-first ในตัว หรือรันแบบ keyless ได้ — ชุดความสามารถนี้คือสิ่งที่ agentmemory ถูกสร้างขึ้นมาเพื่อรองรับโดยเฉพาะ
---

ความเข้ากันได้: release นี้ตั้งเป้าใช้กับ `iii-sdk` 0.22.1 และ pin iii-engine ไว้ที่ v0.22.1
### Try it in 30 seconds
```bash
# Terminal 1: start the server
npx -y @agentmemory/agentmemory@latest
# Terminal 2: seed sample data and see recall in action
npx -y @agentmemory/agentmemory@latest demo
```
`demo` จะ seed เซสชันตัวอย่างที่สมจริง 3 เซสชัน (JWT auth, การแก้ N+1 query, rate limiting) และรันการค้นหาบนเซสชันเหล่านั้น การติดตั้งแบบ keyless จะปิดการใช้ vector ดังนั้นคำค้นหาแบบคำสำคัญของ `mem::search` ควรเจอผลลัพธ์ผ่าน BM25 ในขณะที่ `database performance optimization` อาจคืนผลลัพธ์เป็นศูนย์ `smart-search` อาจคืน structural graph match เพิ่มเติมได้หากมีข้อมูล graph อยู่แล้ว เพื่อให้คำค้นแบบ semantic หาการแก้ N+1 เจอผ่าน vector ให้ตั้งค่า `EMBEDDING_PROVIDER=local` แล้ว restart และปล่อยให้การดาวน์โหลดโมเดลครั้งแรกเสร็จสมบูรณ์
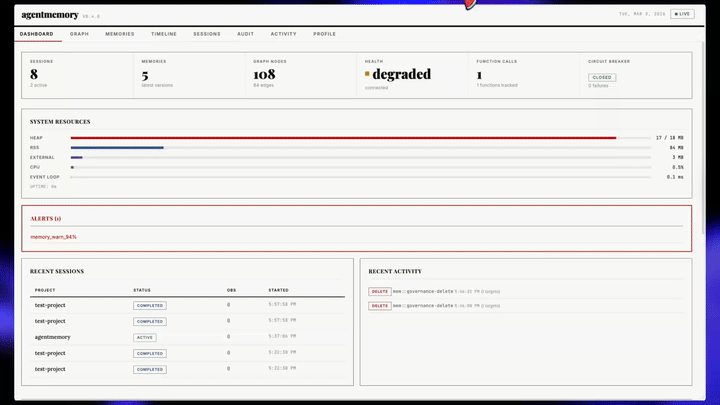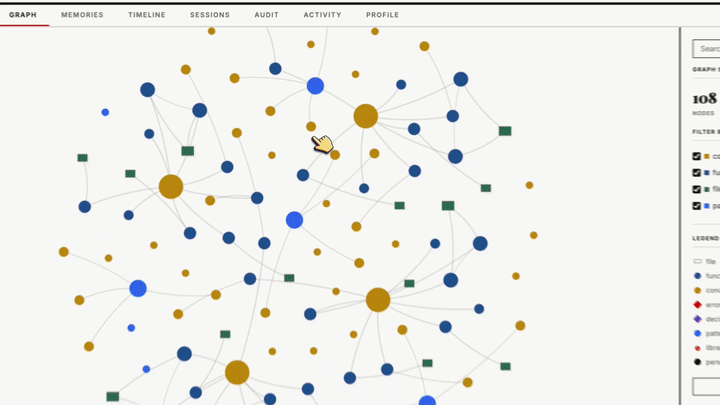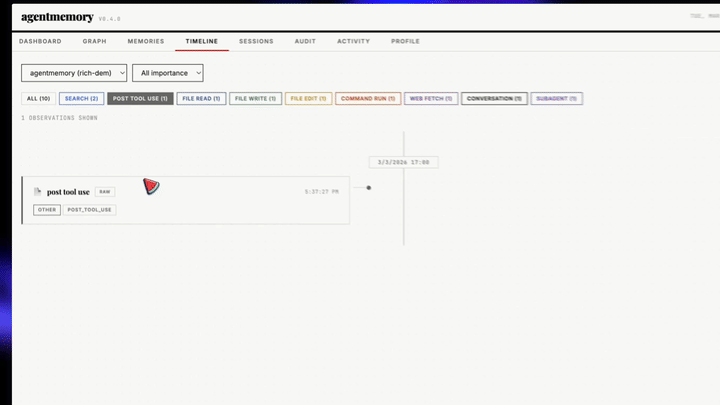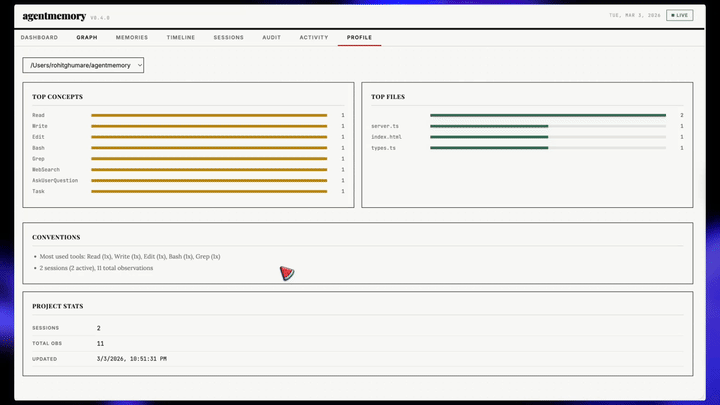
เปิด `http://localhost:3113` เพื่อดูหน่วยความจำถูกสร้างขึ้นแบบสด ๆ
### Validate a fresh install and restart persistence
ขณะที่ server รันอยู่ ให้ตรวจสอบ REST, health, viewer, และสถานะของ runtime ที่ขับเคลื่อนด้วย iii:
```bash
curl -fsS http://localhost:3111/agentmemory/livez
curl -fsS http://localhost:3111/agentmemory/health
curl -fsS -o /dev/null http://localhost:3113/
npx -y @agentmemory/agentmemory@latest status
```
หน้าพร้อมใช้งานตอนเริ่มระบบครอบคลุมทั้ง 4 พอร์ต: REST/MCP HTTP บน 3111, iii stream บน 3112, viewer บน 3113, และ iii worker WebSocket บน 49134 `status` จะยืนยัน health ของ agentmemory และ provider/embedding mode ที่ใช้งานอยู่ บันทึก probe หนึ่งตัวแล้วตรวจว่าค้นหาเจอจริง:
```bash
curl -fsS -X POST http://localhost:3111/agentmemory/remember \
-H 'Content-Type: application/json' \
-d '{"content":"agentmemory restart persistence probe","concepts":["install-check"]}'
curl -fsS -X POST http://localhost:3111/agentmemory/smart-search \
-H 'Content-Type: application/json' \
-d '{"query":"restart persistence probe","limit":5}'
```
จากนั้นรัน `npx -y @agentmemory/agentmemory@latest stop` รันคำสั่งมาตรฐานใหม่อีกครั้งใน Terminal 1 รอให้ `/agentmemory/livez` พร้อม แล้วค้นหาซ้ำ probe ต้องยังถูกคืนค่ามาอยู่ ถ้าคุณเลือก `--data-dir` แบบกำหนดเอง ให้ใช้ directory เดิมตอน restart ด้วย
### Everyday commands
การติดตั้งและการตั้งค่าอยู่ใน [Install](#install) ด้านบน (การรันครั้งแรกจะพาคุณผ่านขั้นตอนทั้งหมด) การใช้งานประจำวัน:
```bash
agentmemory # start the server
agentmemory stop # stop it cleanly
agentmemory connect # wire another agent
agentmemory doctor # interactive diagnostics + fix prompts
agentmemory remove # uninstall everything we created
```
### Session Replay
ทุกเซสชันที่ agentmemory บันทึกสามารถเล่นซ้ำได้ เปิด viewer เลือกแท็บ **Replay** แล้วเลื่อนไปตาม timeline: prompt, tool call, ผลลัพธ์ tool, และคำตอบจะแสดงเป็น event แยกกัน พร้อมปุ่ม play/pause, ควบคุมความเร็ว (0.5x ถึง 4x), และคีย์ลัด (เว้นวรรคเพื่อสลับเล่น/หยุด ลูกศรเพื่อขยับทีละสเต็ป)
หากต้องการนำ Claude Code JSONL transcript เก่าเข้ามา:
```bash
# Import everything under the default ~/.claude/projects
npx -y @agentmemory/agentmemory@latest import-jsonl
# Or import a single file
npx -y @agentmemory/agentmemory@latest import-jsonl ~/.claude/projects/-my-project/abc123.jsonl
```
เซสชันที่ import เข้ามาจะปรากฏใน Replay picker ควบคู่กับเซสชันแบบ native เบื้องหลัง แต่ละรายการจะผ่าน iii function ได้แก่ `mem::replay::load`, `mem::replay::sessions`, และ `mem::replay::import-jsonl` โดยไม่มี side-channel server ใด ๆ transcript ที่ import แต่ละตัวจะถูก index เพื่อค้นหา ประทับ origin channel เป็น `import` และถูกนำไปสร้างเป็น session crystal และ lesson
> **ข้อควรทราบหากคุณใช้ `import-jsonl` เป็นเส้นทาง capture หลัก:** `cleanupPeriodDays` ของ Claude Code (ใน `~/.claude/settings.json`, default **30**) จะลบ JSONL transcript ที่เก่ากว่า window นั้นออกจาก `~/.claude/projects/` โดยอัตโนมัติ ถ้าคุณติดตั้ง agentmemory ใหม่บน history ของ Claude Code ที่มีมาหลายเดือน อะไรที่เก่ากว่า 30 วันก็หายไปแล้วก่อนการ import ครั้งแรก ให้เลือกอย่างใดอย่างหนึ่ง: รัน `import-jsonl` แบบ cron, เพิ่มค่า `cleanupPeriodDays` ให้สูงขึ้น หรือเชื่อมต่อ hook แบบ auto-capture (เส้นทางติดตั้ง plugin แบบ default) เพื่อให้แต่ละ turn เข้าสู่ agentmemory ตั้งแต่เซสชันยังรันอยู่ จนการลบ JSONL ไม่มีผลอีกต่อไป
### Upgrade / Maintenance
ใช้คำสั่ง maintenance เมื่อคุณต้องการอัปเดต runtime ในเครื่องโดยตั้งใจ:
```bash
npx -y @agentmemory/agentmemory@latest upgrade
```
คำเตือน: คำสั่งนี้จะแก้ไข workspace/runtime ปัจจุบัน มันสามารถอัปเดต dependency ของ JavaScript และดึง Docker image `iiidev/iii:0.22.1` ที่ pin ไว้ได้ มันจะไม่ติดตั้ง iii engine ที่ไม่ได้ pin หรือเวอร์ชันใหม่กว่าเด็ดขาด
รายละเอียดการ implement อยู่ใน `src/cli.ts` (ดู `runUpgrade` รอบ ๆ ส่วน `src/cli.ts:544-595`)
### Claude Code (one block, paste it)
```text
Install agentmemory: run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server and its pinned iii engine. Then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory` — the plugin registers all 12 hooks, 17 skills, AND auto-wires the `@agentmemory/mcp` stdio server via its `.mcp.json`, so you get 54 MCP tools (memory_smart_search, memory_save, memory_sessions, memory_governance_delete, etc.) without any extra config step. Verify with `curl http://localhost:3111/agentmemory/health`. The real-time viewer is at http://localhost:3113. Keyless mode disables vectors: `memory_recall` uses BM25, and `memory_smart_search` can also use existing structural graph data. Set `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` and restart to opt into on-device semantic recall.
```
#### Claude Code without the plugin install (MCP-standalone path)
ถ้าคุณเชื่อมต่อ MCP server ของ agentmemory ผ่าน `~/.claude.json` โดยตรงแทนการใช้ `/plugin install`, Claude Code จะไม่ resolve `${CLAUDE_PLUGIN_ROOT}` เลย และคุณต้องชี้ hook script ไปที่ absolute path ใน `~/.claude/settings.json` path เหล่านั้นมักจะฝังเวอร์ชันของ agentmemory ไว้ด้วย (เช่น `~/.codex/plugins/cache/agentmemory/agentmemory/0.9.22/scripts/…`) ดังนั้นการ upgrade ครั้งต่อไปจะทำให้ hook ทุกตัวพังแบบไม่มีเสียงเตือน
วิธีแก้:
```bash
agentmemory connect claude-code --with-hooks
```
คำสั่งนี้จะ merge คำสั่ง hook เดียวกันเข้าไปใน `~/.claude/settings.json` โดยใช้ absolute path ที่ resolve ไปยัง directory `plugin/` ที่แพ็กเกจ `@agentmemory/agentmemory` เวอร์ชันที่ติดตั้งอยู่ในปัจจุบัน ให้รันคำสั่งนี้ซ้ำอีกครั้งหลัง upgrade agentmemory เพื่อ refresh path รายการของผู้ใช้ในไฟล์เดียวกันจะยังคงอยู่ มีเพียงรายการของ agentmemory เดิมที่จะถูกแทนที่ การใช้เส้นทาง `/plugin install` ยังคงเป็นวิธีที่แนะนำ
สำหรับการ deploy แบบ remote หรือแบบที่มีการป้องกัน ให้เปิด Claude Code โดยตั้งค่า `AGENTMEMORY_URL` และ `AGENTMEMORY_SECRET` ไว้ plugin จะส่งค่าทั้งสองนี้ต่อไปยัง MCP server ที่ bundle มาด้วย เมื่อ `AGENTMEMORY_URL` เป็นค่าว่าง MCP shim จะใช้ `http://localhost:3111`
### Codex CLI (Codex plugin platform)
```bash
# 1. start the memory server in a separate terminal
npx -y @agentmemory/agentmemory@latest
# 2. register the agentmemory marketplace and install the plugin
codex plugin marketplace add rohitg00/agentmemory
codex plugin add agentmemory@agentmemory
```
Codex plugin ถูก ship มาจาก directory `plugin/` เดียวกันกับ Claude Code plugin มันจะลงทะเบียน:
- stdio MCP bridge ที่ bundle มาด้วย เชื่อมต่อไปยัง daemon ที่กำลังรันอยู่ ไม่มีการดาวน์โหลด npm หรือ fallback store ดู [คู่มือ Codex แบบ local](../docs/plugins/codex-local.md) เพื่อทดสอบ build ที่ยังไม่ได้ปล่อย
- lifecycle hook 6 ตัว: `SessionStart`, `UserPromptSubmit`, `PreToolUse`, `PostToolUse`, `PreCompact`, `Stop`
- skill ที่เรียกใช้ได้ 9 ตัว: `/recall`, `/remember`, `/session-history`, `/forget`, `/recap`, `/handoff`, `/lesson`, `/commit-context`, `/commit-history`, บวก reference skill อีก 8 ตัวที่ agent โหลดตามต้องการ (memory discipline, MCP tools, REST API, config, agents, hooks, architecture, และคู่มือการเขียน skill)
hook engine ของ Codex จะ inject `CLAUDE_PLUGIN_ROOT` เข้าไปใน hook subprocess (ตาม [`codex-rs/hooks/src/engine/discovery.rs`](https://github.com/openai/codex/blob/main/codex-rs/hooks/src/engine/discovery.rs)) ดังนั้น hook script เดียวกันจะทำงานได้บนทั้งสอง host โดยไม่ต้องทำซ้ำ event อย่าง Subagent / SessionEnd / Notification / TaskCompleted / PostToolUseFailure เป็นของ Claude Code เท่านั้น และไม่ได้ลงทะเบียนสำหรับ Codex
#### Trust และความเข้ากันได้ของ hook ของ Codex
การ dispatch native plugin hook ได้รับการ verify แล้วกับ Codex CLI 0.150.1 ต้อง trust plugin hook ก่อนที่จะคาดหวัง capture พฤติกรรมของ Desktop ขึ้นอยู่กับ runtime ที่ bundle มาด้วย ตรวจสอบ `/hooks` และยืนยันว่ามี event ที่ capture ได้ก่อนเปิดใช้ workaround
ถ้า host ของคุณต้องใช้ global hook ให้ mirror คำสั่งไปยัง `~/.codex/hooks.json` ถ้า MCP เชื่อมต่อไว้อยู่แล้ว connector ตัวปัจจุบันต้องใช้ `--force` เพื่อให้ไปถึงขั้นติดตั้ง hook:
```bash
agentmemory connect codex --with-hooks --force
```
คำสั่งนี้จะ merge global hook และเขียนทับรายการ MCP ของ agentmemory ใหม่ โดยรายการอื่นที่ไม่เกี่ยวข้องจะยังคงอยู่ ตรวจสอบการตั้งค่า endpoint ของ agentmemory แบบ custom ก่อนใช้ `--force` รันซ้ำหลัง upgrade เพื่อ refresh path ของ script เปิดใช้อย่างใดอย่างหนึ่งระหว่าง native plugin hook หรือ global copy เพื่อเลี่ยงการ capture ซ้ำ
### GitHub Copilot CLI
สำหรับ VS Code agent mode ให้ใช้ [คู่มือ MCP และ automatic-capture ของ Copilot](../docs/plugins/copilot.md#vs-code-copilot-local-agent-sessions) CLI connector ตัวนี้ไม่ได้ตั้งค่า VS Code ให้
```bash
# MCP-only wiring
agentmemory connect copilot-cli
# Alternatively, full hooks/skills plugin from the GitHub subdir
copilot plugin install rohitg00/agentmemory:plugin
```
`agentmemory connect copilot-cli` จะ merge `mcpServers.agentmemory` เข้าไปใน `~/.copilot/mcp-config.json` (หรือ `$COPILOT_HOME/mcp-config.json` เมื่อตั้งค่า `COPILOT_HOME`) และยังคง server อื่น ๆ ที่มีอยู่ไว้ บน native Windows นี่คือ adapter `connect` แบบอัตโนมัติตัวเดียวที่ใช้ได้ ส่วน agent native ของ Windows ตัวอื่น ๆ ทุกตัวต้องตั้งค่าเอง WSL `connect` รองรับก็เฉพาะเมื่อ agent ปลายทางถูกติดตั้งอยู่ใน WSL environment เดียวกันนั้นด้วย Copilot จะรับ MCP server ในการเปิดครั้งถัดไปหรือหลังจากสั่ง `/mcp` ติดตั้ง plugin เพิ่มเมื่อคุณต้องการประสบการณ์ hook/skill แบบเต็ม
OpenClaw (paste this prompt)
```text
Install agentmemory for OpenClaw. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to my OpenClaw MCP config so agentmemory is available with all 54 memory tools:
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
Restart OpenClaw. Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper memory-slot integration, copy `integrations/openclaw` to `~/.openclaw/extensions/agentmemory` and enable `plugins.slots.memory = "agentmemory"` in `~/.openclaw/openclaw.json`.
```
คู่มือฉบับเต็ม: [`integrations/openclaw/`](../integrations/openclaw/)
Hermes Agent (paste this prompt)
```text
Install agentmemory for Hermes. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to ~/.hermes/config.yaml so Hermes can use agentmemory as an MCP server with all 54 memory tools:
mcp_servers:
agentmemory:
command: npx
args: ["-y", "@agentmemory/mcp"]
memory:
provider: agentmemory
Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper 6-hook memory provider integration (pre-LLM context injection, turn capture, MEMORY.md mirroring, system prompt block), copy integrations/hermes from the agentmemory repo to ~/.hermes/plugins/agentmemory.
```
คู่มือฉบับเต็ม: [`integrations/hermes/`](../integrations/hermes/)
### Other agents
เริ่ม memory server: `npx -y @agentmemory/agentmemory@latest`
#### Native skills via `npx skills add` (50+ agents)
agentmemory ship skill มาทั้งหมด 17 ตัว ในรูปแบบ `/SKILL.md` สไตล์ Claude Code: action skill ที่เรียกใช้ได้ 9 ตัว (`remember`, `recall`, `recap`, `handoff`, `forget`, `lesson`, `commit-context`, `commit-history`, `session-history`) และ reference skill อีก 8 ตัวที่ agent โหลดตามต้องการ (`memory-discipline`, `agentmemory-mcp-tools`, `agentmemory-rest-api`, `agentmemory-config`, `agentmemory-agents`, `agentmemory-hooks`, `agentmemory-architecture`, `write-agentmemory-skill`) reference skill พวกนี้มีตารางข้อมูลที่สร้างจาก source โดยตรง จึงไม่มีทางเพี้ยนไปจากของจริง CLI [`skills`](https://npmjs.com/package/skills) ของ vercel-labs จะติดตั้งให้อัตโนมัติเข้าไปใน native skill directory ของ agent ที่เรียกมันขึ้นมา ครอบคลุม agent กว่า 50 ตัว (Claude Code, Cursor, Cline, Continue, Droid, Warp, Codex, Antigravity, Kiro, OpenCode, Goose, Roo, Trae, Windsurf, และอีกมากมาย):
```bash
npx skills add rohitg00/agentmemory -y # auto-detects the calling agent
npx skills add rohitg00/agentmemory -y -a warp # explicit agent
npx skills add rohitg00/agentmemory -y -a '*' # install to every installed agent
```
สิ่งนี้ **เสริม** `agentmemory connect ` ไม่ได้แทนที่กัน:
- `agentmemory connect ` เขียน config ของ MCP server เพื่อให้เครื่องมือพร้อมใช้งาน
- `npx skills add rohitg00/agentmemory` ติดตั้ง skill เพื่อให้ agent รู้ว่าต้องเรียกใช้เมื่อไหร่
สำหรับ agent ไม่กี่ตัวที่ skills CLI ยังไม่ครอบคลุม (Zed v1.3.x และเก่ากว่า) ให้วางไฟล์ SKILL.md ทั้ง 17 ไฟล์ลงใน native skill directory ของ agent นั้นด้วยตัวเอง รูปแบบเดียวกันนี้ใช้ได้ทุกที่
#### Standard MCP block
รายการ agentmemory เป็น **MCP server block เดียวกัน** บนทุก host ที่ใช้รูปแบบ `mcpServers` (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI, OpenClaw):
```json
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "${AGENTMEMORY_URL}",
"AGENTMEMORY_SECRET": "${AGENTMEMORY_SECRET}"
}
}
```
**Merge รายการนี้เข้าไปใน object `mcpServers` ที่มีอยู่แล้ว** ของไฟล์ config ของ host นั้น ไม่ใช่แทนที่ไฟล์ทั้งหมด ถ้าไฟล์มี server อื่นอยู่แล้ว ให้เพิ่ม `agentmemory` เข้าไปเป็นอีก key หนึ่งข้าง ๆ กันภายใน `mcpServers` ถ้าไม่มี `mcpServers` อยู่เลย ให้วาง block นี้ไว้ใน `{ "mcpServers": { ... } }` placeholder `${VAR}` จะรับค่า `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` จาก shell ตอน MCP server เริ่มทำงาน; ตัวแปรที่ไม่ได้ตั้งไว้จะส่งเป็น string ว่าง และ shim จะ fallback ไปที่ `http://localhost:3111` รายการที่เชื่อมต่อไว้แล้วหนึ่งรายการครอบคลุมทั้งการ deploy แบบ local และ remote (k8s / reverse-proxied)
| Agent | Config file | หมายเหตุ |
|---|---|---|
| **Cursor (MCP only)** | `~/.cursor/mcp.json` | Merge เข้าไปใน `mcpServers`, หรือใช้ `agentmemory connect cursor` มี one-click deeplink บนเว็บไซต์ด้วย |
| **Cursor (full plugin)** | `.cursor-plugin/` | รายการใน Cursor Marketplace (อยู่ระหว่างการตรวจสอบ) หรือ Cursor Settings → Plugins → local checkout ลงทะเบียน auto-capture hook 7 ตัว (sessionStart, beforeSubmitPrompt, preToolUse, postToolUse, postToolUseFailure, stop, sessionEnd) + skill 17 ตัว + MCP server โดย `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` ถูกจัดการใน Cursor's plugin dashboard ใช้งานได้ทั้งใน Cursor IDE และ CLI `cursor-agent`; prompt ของ CLI print-mode จะถูก backfill จาก session transcript ตอนจบเซสชัน |
| **Claude Desktop** | `claude_desktop_config.json` (Application Support) | Merge เข้าไปใน `mcpServers` restart Claude Desktop หลังแก้ไฟล์ |
| **Cline / Roo Code / Kilo Code** | Cline MCP settings (Settings UI → MCP Servers → Edit) | ใช้ `mcpServers` block เดียวกัน |
| **Devin CLI (MCP + hooks)** | `~/.config/devin/config.json` | `agentmemory connect devin` จะ merge รายการ MCP; `--with-hooks` เพิ่ม native auto-capture hook หกตัว (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop, SessionEnd) ด้วย tool matcher แบบตัวพิมพ์เล็กของ Devin ตรวจสอบด้วย `devin mcp list` และ `/hooks` ภายใน devin |
| **Devin CLI (full plugin)** | `plugin/.devin-plugin/` | `devin plugins install ./plugin` จาก checkout จะลงทะเบียน skill ทั้ง 17 ตัวเป็นคำสั่ง slash `/agentmemory:` รวมถึง MCP server ด้วย plugin hook ของ Devin ไม่สามารถยิง `SessionStart`/`SessionEnd` ได้ ดังนั้นให้ใช้คู่กับ `connect devin --with-hooks` เพื่อ capture เซสชันแบบเต็ม |
| **Devin (cloud)** | Settings → Connections → MCP servers | เพิ่ม custom MCP (STDIO): command `npx`, args `-y @agentmemory/mcp@latest`, env `AGENTMEMORY_URL` ชี้ไปยัง agentmemory deployment ที่เข้าถึงได้ทางเครือข่าย พร้อม `AGENTMEMORY_SECRET` (เซสชัน cloud เข้าถึง localhost ไม่ได้ — ดู [`deploy/`](../deploy/)) เก็บ secret ไว้ใน Devin Secrets แล้วใช้ "Test listing tools" เพื่อตรวจว่าเครื่องมือครบทั้ง 54 ตัวปรากฏขึ้น |
| **Gemini CLI** | `~/.gemini/settings.json` | `gemini mcp add agentmemory npx -y @agentmemory/mcp --scope user` (merge อัตโนมัติ) |
| **GitHub Copilot CLI (MCP only)** | `~/.copilot/mcp-config.json` | `agentmemory connect copilot-cli` จะ merge `mcpServers.agentmemory`; Copilot จะรับค่าในการเปิดครั้งถัดไปหรือ `/mcp` |
| **GitHub Copilot CLI (full plugin)** | ติดตั้ง plugin ของ Copilot | `copilot plugin install rohitg00/agentmemory:plugin` สำหรับ plugin จาก GitHub subdir |
| **OpenClaw** | OpenClaw MCP config | ใช้ `mcpServers` block เดียวกัน เชิงลึกกว่านั้น: `openclaw plugins install ./integrations/openclaw` จะยึด memory slot ของ OpenClaw (สลับจาก `memory-core` อัตโนมัติ) ตั้งค่า `plugins.entries.agentmemory.hooks.allowConversationAccess=true` ไม่เช่นนั้นการ capture turn จะถูกบล็อกแบบเงียบ ๆ ดู [`integrations/openclaw`](../integrations/openclaw/) |
| **Codex CLI (MCP only)** | `.codex/config.toml` | รูปแบบ TOML: `codex mcp add agentmemory -- npx -y @agentmemory/mcp` หรือเพิ่ม `[mcp_servers.agentmemory]` เอง |
| **Codex CLI (full plugin)** | Codex plugin marketplace | `codex plugin marketplace add rohitg00/agentmemory` แล้ว `codex plugin add agentmemory@agentmemory` ลงทะเบียน MCP + lifecycle hook 6 ตัว + skill 17 ตัว ต้อง trust hook และ verify การ capture ใน host ของคุณ ดู [การ setup และ validate Codex](../docs/plugins/codex-local.md) |
| **OpenCode (MCP only)** | `opencode.json` | รูปแบบต่างออกไป: key ระดับบนสุดคือ `mcp`, command เป็น array: `{"mcp": {"agentmemory": {"type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true}}}` |
| **OpenCode (full plugin)** | `plugin/opencode/` | auto-capture hook 22 ตัว ครอบคลุม session lifecycle, message, tool, error การระบุ project เป็นแบบต่อเซสชัน ดังนั้น OpenCode process เดียวที่ครอบคลุมหลาย repository จะเก็บแต่ละเซสชันไว้ใน project ของตัวเอง มีคำสั่ง slash สองตัว (`/recall`, `/remember`) copy `plugin/opencode/` เข้าไปใน OpenCode workspace ของคุณแล้วเพิ่มรายการ plugin ลงใน `opencode.json` ดู [`plugin/opencode/README.md`](../plugin/opencode/README.md) สำหรับตาราง hook แบบเต็มพร้อม gap analysis |
| **pi** | `~/.pi/agent/extensions/agentmemory` | `agentmemory connect pi` จะติดตั้ง extension ที่ bundle มาเข้าไปใน auto-discovery directory ของ pi (recall ตอน agent เริ่ม, capture ตอน agent จบ, เครื่องมือ `memory_search` / `memory_save` / `memory_health`, `/agentmemory-status`) `/reload` ใน pi ที่กำลังรันอยู่จะรับค่านี้ [`integrations/pi`](../integrations/pi/) ยังเป็น pi package ด้วย (`pi install ./integrations/pi` จาก checkout) |
| **Hermes Agent** | `~/.hermes/config.yaml` | `cp -r integrations/hermes ~/.hermes/plugins/agentmemory` + `memory.provider: agentmemory` จะให้ memory provider แบบ 6-hook (prefetch, turn capture, session end, pre-compress, MEMORY.md mirroring, system prompt block) ตรวจสอบด้วย `hermes plugins doctor` และ `hermes memory status` ดู [`integrations/hermes`](../integrations/hermes/) |
| **Qwen Code** | `~/.qwen/settings.json` | `agentmemory connect qwen` เขียน `mcpServers` block แบบมาตรฐาน payload ของ hook เข้ากันได้กับ Claude Code ดังนั้น hook script 12 ตัวที่มีอยู่ใช้งานได้โดยไม่ต้องแก้ไข เชื่อมต่อผ่าน section `hooks` ใน `settings.json` เดียวกัน |
| **Antigravity IDE / 2.0** | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity --with-hooks` จะติดตั้ง MCP และ capture hook ไว้ใน shared customization directory ดู [การตั้งค่าและข้อจำกัดของ Antigravity](../docs/plugins/antigravity.md) |
| **Antigravity CLI** (`agy`) | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity-cli --with-hooks` ใช้ config ของ MCP และ hook แบบเดียวกับ IDE เวอร์ชันปัจจุบัน การติดตั้งที่มีอยู่แล้วควร refresh ด้วย `--force`; ดู [upgrade notes](../docs/plugins/antigravity.md) |
| **Kiro** | `~/.kiro/settings/mcp.json` | `agentmemory connect kiro` เขียน config ระดับ user การ override ระดับ workspace ไปอยู่ที่ `.kiro/settings/mcp.json` ข้าง ๆ โค้ดของคุณ |
| **Warp** | `~/.warp/.mcp.json` | `agentmemory connect warp` เขียน `mcpServers` block แบบมาตรฐาน Warp ยัง auto-discover skill จาก `.claude/skills/` ด้วย เมื่อติดตั้ง Claude Code plugin แล้ว skill ทั้ง 8 ตัวของ agentmemory (`remember`, `recall`, `recap`, `handoff`, `forget`, `commit-context`, `commit-history`, `session-history`) จะปรากฏใน slash-command palette ของ Warp โดยตรง |
| **Cline (CLI)** | `~/.cline/mcp.json` | `agentmemory connect cline` เขียน `mcpServers` block แบบมาตรฐาน ผู้ใช้ VS Code extension: paste block เดียวกันผ่าน Cline Settings → MCP Servers → Edit JSON |
| **Continue.dev** | `~/.continue/config.yaml` (แนะนำ) หรือ `config.json` (รุ่นเก่า) | `agentmemory connect continue` จะสร้าง `config.yaml` ใหม่ทั้งหมดเมื่อยังไม่มีไฟล์ใดเลย หรือแก้ `config.json` ที่มีอยู่ **ถ้าคุณมี `config.yaml` อยู่แล้ว** adapter จะพิมพ์ block ที่ต้อง paste ใต้ `mcpServers:` ออกมาให้ตรง ๆ มันจะไม่เขียนทับไฟล์ yaml ของคุณแบบเงียบ ๆ เพราะการรักษา comment และ anchor ให้ปลอดภัยต้องใช้ YAML parser ที่แพ็กเกจนี้ไม่ได้ ship มาด้วย Continue ใช้ array (ไม่ใช่ object) สำหรับ `mcpServers` |
| **Zed** | `~/.config/zed/settings.json` | `agentmemory connect zed` เขียนไว้ใต้ `context_servers` (key ของ Zed ไม่ใช่ `mcpServers`) MCP server แบบ remote เชื่อมต่อผ่าน `{"url": "..."}` ได้เช่นกัน |
| **Droid (Factory.ai)** | `~/.factory/mcp.json` | `agentmemory connect droid` เขียน `mcpServers` block แบบมาตรฐาน การ override ระดับ project ไปอยู่ที่ `/.factory/mcp.json` ใส่ `--with-hooks` เพื่อ auto-capture แบบ native |
| **DeepSeek Harness** | `$DSH_HOME/cordis.patch.yml` | `agentmemory connect dsh` จะต่อแถว `@deepseek-ai/dsh-mcp-client` เข้าไปใน patch layer ระดับ home ที่ทุก Harness profile โหลด; เครื่องมือจะลงทะเบียนเป็น `mcp__agentmemory__*` ใส่ `--with-hooks` เพื่อเชื่อมต่อ auto-capture ด้วย: hook script ของ Claude Code ที่ bundle มาจะรันผ่าน bridge first-party `@deepseek-ai/dsh-hooks-claude-code` ของ Harness (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop) ผ่าน manifest ที่เขียนไว้ที่ `$DSH_HOME/agentmemory.hooks.json` ค่า default คือ `~/.dsh` เมื่อไม่ได้ตั้งค่า `DSH_HOME` |
| **Goose** | Goose MCP settings UI | ใช้ `mcpServers` block เดียวกัน; ใช้ `goose configure` → Add Extension → MCP การแก้ YAML ตรง ๆ ที่ `~/.config/goose/config.yaml` ก็รองรับ แต่ schema ใช้ `extensions:` + `cmd` (ไม่ใช่ `mcpServers:` + `command`) |
| **Aider** | n/a | คุยกับ REST API ตรง ๆ: `curl -X POST http://localhost:3111/agentmemory/smart-search -d '{"query": "auth"}'` |
| **Any agent (32+)** | n/a | `npx skillkit install agentmemory` จะตรวจจับ host อัตโนมัติและ merge ให้ |
**MCP client แบบ sandbox** (Flatpak / Snap / container ที่จำกัด) ที่เข้าถึง `localhost` ของ host ไม่ได้: ให้ตั้งค่า `"AGENTMEMORY_FORCE_PROXY": "1"` เพิ่มใน `env` block ด้วย และชี้ `AGENTMEMORY_URL` ไปยัง route ที่ sandbox เข้าถึงได้จริง (เช่น LAN IP ของคุณ)
### Programmatic access (Python / Rust / Node)
agentmemory ลงทะเบียน core operation ของมันเป็น iii function (`mem::remember`, `mem::observe`, `mem::context`, `mem::smart-search`, `mem::forget`) ภาษาใดก็ได้ที่มี iii SDK สามารถเรียกมันได้ตรง ๆ ผ่าน `ws://localhost:49134` โดยไม่ต้องมี REST client แยกสำหรับแต่ละภาษา
```bash
pip install iii-sdk # Python
cargo add iii-sdk # Rust
npm install iii-sdk # Node
```
```python
from iii import register_worker
iii = register_worker("ws://localhost:49134")
iii.connect()
iii.trigger({
"function_id": "mem::smart-search",
"payload": {"project": "demo", "query": "how do tokens refresh"},
})
```
ตัวอย่างแบบทำงานได้จริง: [`examples/python/`](../examples/python/) (quickstart + observation/recall flow) REST บน `:3111` ยังใช้งานได้สำหรับ host ที่ไม่มี iii runtime
### From source
```bash
git clone https://github.com/rohitg00/agentmemory.git && cd agentmemory
npm install && npm run build && npm start
```
คำสั่งนี้จะเริ่ม agentmemory ด้วย `iii-engine` ในเครื่อง ถ้า binary ที่ pin ไว้ติดตั้งอยู่แล้ว หรือใช้ Docker Compose เมื่อเลือกไว้ REST, stream, และ viewer จะ bind กับ `127.0.0.1` โดย default เส้นทางติดตั้ง binary แบบอัตโนมัติบน macOS/Linux ต้องมี `curl`, POSIX `sh`, และ `tar`
ติดตั้ง `iii-engine` ด้วยตนเอง **agentmemory ปัจจุบัน pin `iii-engine` ไว้ที่ `v0.22.1`** ซึ่งเป็น release เดียวกับ dependency `iii-sdk` ของมัน worker พูดโปรโตคอล wire ของ engine เวอร์ชันนั้น และ 0.20.0 ได้จัดโครงสร้าง SDK surface ใหม่ ดังนั้นทั้งสองจึงต้องเคลื่อนไปด้วยกันใน release ของ agentmemory override ได้ด้วย `AGENTMEMORY_III_VERSION=` ถ้าคุณรัน engine ของตัวเองและรู้ว่ามันตรงกัน
- **macOS arm64:** `mkdir -p ~/.local/bin && curl -fsSLo iii.tar.gz https://github.com/iii-hq/iii/releases/download/iii/v0.22.1/iii-aarch64-apple-darwin.tar.gz && echo "2b309019b909a896cae874dc947e2cdf877b4f3c51dd026b79850af858517fa4 iii.tar.gz" | shasum -a 256 -c - && tar -xzf iii.tar.gz -C ~/.local/bin && chmod +x ~/.local/bin/iii`
- **macOS x64:** สลับ `aarch64-apple-darwin` เป็น `x86_64-apple-darwin`
- **Linux x64:** สลับเป็น `x86_64-unknown-linux-gnu`
- **Linux arm64:** สลับเป็น `aarch64-unknown-linux-gnu`
- **Windows:** ดาวน์โหลด `iii-x86_64-pc-windows-msvc.zip` จาก [iii-hq/iii releases v0.22.1](https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1) แล้วแตก `iii.exe` ไปที่ `%USERPROFILE%\.agentmemory\bin\iii.exe`
ทุก archive มีไฟล์ `.sha256` คู่กันอยู่บนหน้า release; เมื่อคุณสลับ platform ให้ใช้ hash จากไฟล์นั้นในการตรวจสอบข้างบน (บน Windows: `Get-FileHash`) ตัวติดตั้งอัตโนมัติใน `npx @agentmemory/agentmemory` pin hash เหล่านี้ไว้ และจะปฏิเสธ archive ที่ไม่ตรงกัน
หรือใช้ Docker (`docker-compose.yml` ที่ bundle มาจะดึง `iiidev/iii:0.22.1`) เอกสารฉบับเต็ม: [iii.dev/docs](https://iii.dev/docs)
### Windows
agentmemory รันบน Windows 10/11 ได้ แต่แพ็กเกจ Node.js เพียงอย่างเดียวยังไม่พอ คุณต้องมี iii-engine v0.22.1 runtime ที่ pin ไว้รันเป็น background process ด้วย CLI จะไม่แตก ZIP ของ Windows ให้โดยอัตโนมัติ ดังนั้นผู้ใช้ Windows แบบ native ต้องติดตั้ง `iii.exe` ด้วยตนเอง ใช้ WSL2 หรือเลือก Docker Desktop
การเชื่อมต่อ MCP แบบอัตโนมัติบน native Windows รองรับเฉพาะ `agentmemory connect copilot-cli` สำหรับ Claude Code, Codex, Cursor, และ agent native ของ Windows ตัวอื่น ๆ ทั้งหมด ให้ copy MCP block แบบ manual จาก [Other agents](#other-agents) ไปวางในไฟล์ config ของ agent นั้นบน Windows การรัน `connect` ใน WSL เหมาะสมก็เฉพาะเมื่อ agent ปลายทางถูกติดตั้งอยู่ใน WSL environment เดียวกันนั้นด้วย มันจะไม่แก้ config ของ agent บน Windows host
**ตัวเลือก A: prebuilt Windows binary (แนะนำ)**
```powershell
# 1. Open https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1 in your browser
# (agentmemory pins the engine to the same release as its iii-sdk;
# v0.22.1 is the current pair)
# 2. Download iii-x86_64-pc-windows-msvc.zip
# (or iii-aarch64-pc-windows-msvc.zip if you're on an ARM machine)
# 3. Extract iii.exe to agentmemory's private engine directory:
New-Item -ItemType Directory -Force "$HOME\.agentmemory\bin"
# Copy iii.exe to $HOME\.agentmemory\bin\iii.exe
# 4. Verify:
& "$HOME\.agentmemory\bin\iii.exe" --version
# Should print: 0.22.1
# 5. Then run agentmemory as usual:
npx -y @agentmemory/agentmemory@latest
```
**ตัวเลือก B: Docker Desktop**
```powershell
# 1. Install Docker Desktop for Windows
# 2. Start Docker Desktop and make sure the engine is running
# 3. Select Docker explicitly and run agentmemory:
$env:AGENTMEMORY_USE_DOCKER = "1"
npx -y @agentmemory/agentmemory@latest
```
**ตัวเลือก C: standalone MCP only (ไม่มี engine)** ถ้าคุณต้องการแค่เครื่องมือ MCP สำหรับ agent ของคุณ และไม่ต้องการ REST API, viewer, หรือ cron job ก็ข้าม engine ไปได้เลย:
```powershell
npx -y @agentmemory/agentmemory@latest mcp
# or via the shim package:
npx -y @agentmemory/mcp
```
**การวินิจฉัยปัญหาบน Windows:** ถ้า `npx -y @agentmemory/agentmemory@latest` ล้มเหลว ให้รันซ้ำพร้อม `--verbose` เพื่อดู engine stderr ตัวจริง สาเหตุที่พบบ่อย:
| อาการ | วิธีแก้ |
|---|---|
| `The engine process started but the REST API never responded.` | ตรวจสอบว่าพอร์ตที่ derive มาทั้ง 4 ว่างอยู่ ตรวจว่า `iii.exe` ที่ pin ไว้ยังรันอยู่ จากนั้นรันซ้ำพร้อม `--verbose` และตรวจ engine stderr ที่จับไว้ |
| `Could not start iii-engine` | ไม่มีทั้ง `iii.exe` และ Docker ติดตั้งอยู่ ดูตัวเลือก A หรือ B ด้านบน |
| Port conflict | `netstat -ano \| findstr :3111` เพื่อดูว่ามีอะไร bind พอร์ตนั้นอยู่ แล้ว kill มัน หรือใช้ `--port ` |
| Docker fallback ถูกข้ามแม้ว่า Docker ติดตั้งอยู่ | ตรวจให้แน่ใจว่า Docker Desktop กำลังรันอยู่จริง (ไอคอนใน system tray) |
> หมายเหตุ: iii **engine** เป็น binary ที่ build มาสำเร็จแล้ว ไม่ใช่ cargo crate ดังนั้นอย่า `cargo install` มัน (iii **SDK** เผยแพร่อยู่บน crates.io, npm, และ PyPI แต่ agentmemory ไม่ต้องใช้มัน) วิธีติดตั้ง engine ที่รองรับทั้งหมด pin ไว้ที่ v0.22.1: prebuilt binary ด้านบน, เส้นทาง auto-install ของ agentmemory บน macOS/Linux (ต้องมี `curl`, POSIX `sh`, และ `tar`), และ Docker image `iiidev/iii:0.22.1` การรัน `install.sh | sh` แบบ upstream เปล่า ๆ จะติดตั้ง engine เวอร์ชันล่าสุด ซึ่ง agentmemory ไม่รองรับ ใช้ `npx -y @agentmemory/agentmemory@latest`; บน macOS/Linux มันจะดึง engine ที่ pin ไว้มาไว้ที่ `~/.agentmemory/bin`
---
Deploy
เทมเพลตแบบ one-click สำหรับ managed host ทุกตัวมาพร้อม
Dockerfile แบบ self-contained ที่ดึง `@agentmemory/agentmemory` จาก npm และ copy
iii engine binary มาจาก Docker Hub image `iiidev/iii` อย่างเป็นทางการ
ไม่ต้องมี agentmemory image ที่ build มาสำเร็จแล้วเลย Persistent storage
mount อยู่ที่ `/data`; entrypoint ตอน boot ครั้งแรกจะเขียนทับ
iii config ที่ bundle มากับ npm (ซึ่ง bind `127.0.0.1`) ด้วย
config ที่ปรับมาสำหรับ deploy ซึ่ง bind `0.0.0.0` และใช้ `/data` path แบบ absolute, สร้าง
HMAC secret แล้วจึงลด privilege จาก `root` ไปเป็น `node` ผ่าน
`gosu` ก่อน exec agentmemory CLI
ปุ่ม one-click deploy ของ Render ต้องการ `render.yaml` ที่ root ของ repository ซึ่งเราตั้งใจเก็บให้สะอาดอยู่เสมอ ใช้ Render Blueprint flow ตามที่เขียนไว้ใน [`deploy/render/`](.././deploy/render/README.md) เพื่อชี้ไปยัง blueprint ใน repo ด้วยตนเอง
รายละเอียดการตั้งค่าแบบเต็ม (การ capture HMAC, viewer SSH tunnel, rotation, backup,
cost floor) อยู่ที่ [`deploy/`](.././deploy/README.md):
- [`deploy/fly`](.././deploy/fly/README.md): machine เดียว พร้อม
`auto_stop_machines = "stop"`; ค่า idle ถูกที่สุด
- [`deploy/railway`](.././deploy/railway/README.md): แผน Hobby แบบเหมาจ่าย,
volume อยู่ใน dashboard
- [`deploy/render`](.././deploy/render/README.md): Blueprint flow,
disk snapshot อัตโนมัติบนแผนที่เสียเงิน
- [`deploy/coolify`](.././deploy/coolify/README.md): self-host บน VPS ของ
คุณเองผ่าน [Coolify](https://coolify.io/self-hosted); Docker
Compose stack เดียวกัน คุณเป็นเจ้าของทั้ง host และข้อมูล
มีเพียงพอร์ต `3111` เท่านั้นที่ publish viewer บน `3113` ยังคง bind อยู่กับ
loopback ภายใน container; README ของทุกเทมเพลตมีคำอธิบาย
pattern การทำ SSH-tunnel เพื่อเข้าถึงมัน
---

coding agent ทุกตัวจะลืมทุกอย่างเมื่อเซสชันจบลง และเซสชันใหม่ทุกครั้งก็ต้องเริ่มด้วยการให้คุณอธิบาย stack ของคุณซ้ำอีกครั้ง agentmemory ทำงานอยู่เบื้องหลังและตัดขั้นตอนนั้นออกไป
```text
Session 1: "Add auth to the API"
Agent writes code, runs tests, fixes bugs
agentmemory silently captures every tool use
Session ends -> observations compressed into structured memory
Session 2: "Now add rate limiting"
Agent already knows:
- Auth uses JWT middleware in src/middleware/auth.ts
- Tests in test/auth.test.ts cover token validation
- You chose jose over jsonwebtoken for Edge compatibility
Zero re-explaining. Starts working immediately.
```
### vs built-in agent memory
coding agent ที่ใช้ AI ทุกตัวมีหน่วยความจำ built-in มาด้วย: Claude Code มี `MEMORY.md`, Cursor มี notepad, Cline มี memory bank สิ่งเหล่านี้ทำงานเหมือนสติกเกอร์โน้ต agentmemory คือฐานข้อมูลที่ค้นหาได้ซึ่งอยู่เบื้องหลังสติกเกอร์โน้ตเหล่านั้น
| | Built-in (CLAUDE.md) | agentmemory |
|---|---|---|
| Scale | จำกัดที่ 200 บรรทัด | ไม่จำกัด |
| Search | โหลดทุกอย่างเข้า context | BM25 + vector + graph (top-K เท่านั้น) |
| Token cost | 22K+ ที่ 240 observation | ~1,900 token (ลดลง 92%) |
| Cross-agent | ไฟล์แยกตาม agent | MCP + REST (agent ใดก็ได้) |
| Coordination | ไม่มี | Leases, signals, actions, routines |
| Observability | อ่านไฟล์ด้วยตัวเอง | Real-time viewer บน :3113 |
---

### Memory Pipeline
```text
PostToolUse hook fires
-> SHA-256 dedup (5min window)
-> Privacy filter (strip secrets, API keys)
-> Store raw observation
-> Synthetic compression by default
(LLM-written compression only with a provider + AGENTMEMORY_AUTO_COMPRESS=true)
-> Vector embedding when an embedding provider is active
-> Index in BM25, plus vectors when enabled
Stop / SessionEnd hook fires
-> Summarize session
-> Knowledge graph extraction (if GRAPH_EXTRACTION_ENABLED=true)
-> Slot reflection (if SLOT_REFLECT_ENABLED=true)
SessionStart hook fires
-> Load project profile (top concepts, files, patterns)
-> Hybrid search (BM25 + vector + graph)
-> Token budget (default: 2000 tokens)
-> Inject into conversation
```
### 4-Tier Memory Consolidation
จำลองมาจากวิธีที่สมองมนุษย์ประมวลผลความจำ รวมถึงการ consolidate ความจำระหว่างการนอนหลับ
| Tier | What | Analogy |
|------|------|---------|
| **Working** | Raw observation จากการใช้ tool | หน่วยความจำระยะสั้น |
| **Episodic** | สรุปเซสชันแบบบีบอัด | "เกิดอะไรขึ้น" |
| **Semantic** | ข้อเท็จจริงและ pattern ที่สกัดออกมา | "ฉันรู้อะไร" |
| **Procedural** | Workflow และ pattern การตัดสินใจ | "ทำอย่างไร" |
ความจำจะ decay ไปตามเวลา (Ebbinghaus curve) ความจำที่ถูกเข้าถึงบ่อยจะแข็งแรงขึ้น ความจำที่เก่าจะถูก evict อัตโนมัติ ความขัดแย้งถูกตรวจจับและแก้ไข
### What Gets Captured
| Hook | Captures |
|------|----------|
| `SessionStart` | Project path, session ID |
| `UserPromptSubmit` | User prompt (กรองข้อมูลส่วนตัวแล้ว) |
| `PreToolUse` | รูปแบบการเข้าถึงไฟล์ + context ที่เสริมข้อมูลแล้ว |
| `PostToolUse` | ชื่อ tool, input, output |
| `PostToolUseFailure` | Error context |
| `PreCompact` | ฉีดหน่วยความจำกลับเข้าไปก่อนการ compact |
| `SubagentStart/Stop` | Lifecycle ของ sub-agent |
| `Stop` | สรุปท้ายเซสชัน |
| `SessionEnd` | เครื่องหมายว่าเซสชันเสร็จสมบูรณ์ |
### Key Capabilities
| Capability | Description |
|---|---|
| **Automatic capture** | ทุก tool use ถูกบันทึกผ่าน hook โดยไม่ต้องทำเอง |
| **Semantic search** | BM25 + vector + knowledge graph พร้อม RRF fusion |
| **Memory evolution** | Versioning, supersession, relationship graph |
| **Recall hygiene** | memory version ที่ถูกแทนที่แล้วจะหลุดออกจาก search index; version chain ใน KV เก็บ history แบบเต็มไว้ |
| **Near-duplicate hints** | การ save จะรายงาน `similarTo` match แบบ advisory เมื่อเนื้อหาใหม่คล้ายกับ memory ที่มีอยู่แล้วมาก |
| **Per-agent scoping** | `agentId` ไหลผ่านการ save และ recall ข้าม REST, MCP, และ search index ได้ทั้งแบบ shared หรือ isolated |
| **Write-time provenance** | ทุก observation และ memory มี origin channel ที่เปลี่ยนแปลงไม่ได้ (user, agent, tool, import, หรือ shared) ประทับไว้ตอน capture, save, และ import |
| **Auto-forgetting** | TTL expiry, การตรวจจับความขัดแย้ง, การ evict ตามความสำคัญ |
| **Privacy first** | API key, secret, tag `` ถูกตัดออกก่อนจัดเก็บ |
| **Self-healing** | Circuit breaker, provider fallback chain, health monitoring |
| **Claude bridge** | sync สองทางกับ MEMORY.md |
| **Knowledge graph** | การสกัด entity + BFS traversal |
| **Team memory** | แบ่ง namespace ระหว่าง shared กับ private ของสมาชิกทีม |
| **Citation provenance** | ย้อนกลับไปดู memory ใดก็ได้จนถึง observation ต้นทาง |
| **Git snapshots** | Version, rollback, และ diff สถานะหน่วยความจำ |
---

ดึงข้อมูลแบบ triple-stream โดยรวม 3 สัญญาณเข้าด้วยกัน:
| Stream | What it does | When |
|---|---|---|
| **BM25** | จับคู่คำสำคัญแบบ stemmed พร้อมขยาย synonym | เปิดใช้งานเสมอ |
| **Vector** | Cosine similarity บน dense embedding | เมื่อตั้งค่า embedding provider ไว้ |
| **Graph** | ไล่ knowledge graph ผ่านการจับคู่ entity | เมื่อตรวจพบ entity ในคำค้น |
รวมกันด้วย Reciprocal Rank Fusion (RRF, k=60) และกระจาย session (สูงสุด 3 ผลลัพธ์ต่อเซสชัน)
เมื่อ vector index มีข้อมูลอยู่ `mem::search` (อยู่หลัง `memory_recall`) จะใช้ hybrid ranker แบบ BM25 + vector โดยไม่มี embedding มันจะใช้ BM25 `smart-search` สามารถผสาน structural graph match เพิ่มเติมได้เมื่อมีข้อมูล graph อยู่ รวมถึงในโหมด keyless ด้วย การ recall lesson รันบน BM25 index ในหน่วยความจำเฉพาะของมันเอง แทนการสแกนทั้งคอร์ปัสทุกครั้งที่ค้นหา memory version ที่ถูกแทนที่แล้วจะถูกตัดออกจากทุกเส้นทาง recall; version chain ยังคง history ไว้
Vector รอดจากการ crash หรือ force-kill ได้ vector index จะถูกบันทึกเป็น bucket อย่างมากที่สุดทุก ๆ `AGENTMEMORY_INDEX_SAVE_INTERVAL_MS` (10 นาที) vector ทุกตัวที่เพิ่มหรือลบในระหว่างนั้นจะถูกเขียนลง pending log เล็ก ๆ ใน state store ทันทีด้วย และการเริ่มครั้งถัดไปจะ replay มันโดยไม่ต้องเรียก embedding provider การบันทึกที่สำเร็จแต่ละครั้งจะล้าง log ให้ว่าง document ที่ยังไม่มี vector หลัง replay จะถูก re-embed ในพื้นหลังเป็น batch ละ `AGENTMEMORY_VECTOR_BACKFILL_MAX` (500) จนกว่าจะไม่เหลือสักตัว และ backfill ที่ถูกหยุดจะทำต่อในการเริ่มครั้งถัดไป `/agentmemory/status` และ viewer จะแสดงขนาด pending log และสถานะ backfill การติดตั้งแบบ keyless จะไม่เขียนอะไรเลย
BM25 tokenize ภาษากรีก, ซีริลลิก, ฮีบรู, อารบิก, และละตินแบบมี accent ได้ทันทีโดยไม่ต้องตั้งค่าเพิ่ม สำหรับหน่วยความจำภาษาจีน / ญี่ปุ่น / เกาหลี ให้ติดตั้ง segmenter แบบ optional (`npm install @node-rs/jieba tiny-segmenter`) เพื่อแยกข้อความ CJK เป็น token ระดับคำ; ถ้าไม่มี agentmemory จะ soft-fallback ไปที่การ tokenize ทั้ง run และพิมพ์คำเตือนครั้งเดียวออกที่ stderr
### Embedding providers
การติดตั้งแบบ keyless จะปิดการใช้ vector embedding: `mem::search` ใช้ BM25 ในขณะที่ `smart-search` สามารถใช้ structural graph data ที่มีอยู่แล้วได้ด้วย หากต้องการเปิดใช้ semantic embedding แบบออนดีไวซ์โดยไม่มีค่าใช้จ่าย ให้เพิ่มสิ่งนี้ลงใน `~/.agentmemory/.env` แล้ว restart agentmemory:
```env
EMBEDDING_PROVIDER=local
```
การ install npm แบบปกติมี runtime `@huggingface/transformers` แบบ optional มาด้วยอยู่แล้ว คำขอ embedding ครั้งแรกจะดาวน์โหลด `Xenova/all-MiniLM-L6-v2` ดังนั้นต้องมีการเข้าถึงเครือข่ายและอาจใช้เวลานานขึ้น การ inference ครั้งต่อไปจะทำงานในเครื่อง remote provider จะถูกตรวจจับอัตโนมัติจาก key ของมัน เว้นแต่ `EMBEDDING_PROVIDER` จะ override ไว้
| Provider | Model | Cost | Notes |
|---|---|---|---|
| **Local (แนะนำให้เปิดเอง)** | `all-MiniLM-L6-v2` | ฟรี | ทำงานในเครื่องหลังดาวน์โหลดโมเดลครั้งแรก, recall เพิ่มขึ้น +8pp เทียบกับ BM25-only |
| Gemini | `gemini-embedding-001` | มี free tier | รองรับ 100+ ภาษา, 768/1536/3072 มิติ (MRL), input 2048 token แทนที่ `text-embedding-004` ([deprecated, ปิดให้บริการ 14 ม.ค. 2026](https://ai.google.dev/gemini-api/docs/deprecations)) |
| OpenAI | `text-embedding-3-small` | $0.02/1M | คุณภาพสูงที่สุด |
| Voyage AI | `voyage-code-3` | เสียเงิน | ปรับให้เหมาะกับโค้ด |
| Cohere | `embed-english-v3.0` | มี free trial | ใช้งานทั่วไป |
| OpenRouter | โมเดลใดก็ได้ | ขึ้นกับโมเดล | Proxy แบบ multi-model |
---

54 เครื่องมือ, 6 resource, 3 prompt, และ 17 skill
> **MCP shim เทียบกับ full server:** แพ็กเกจ `@agentmemory/mcp` ที่เผยแพร่อยู่เป็นแค่ shim บาง ๆ มันจะเปิดเครื่องมือครบทั้ง 54 ตัว **ก็เฉพาะเมื่อมันเชื่อมต่อไปยัง agentmemory server ที่กำลังรันอยู่ได้** ผ่าน `AGENTMEMORY_URL` (proxy mode) เมื่อไม่มี server ให้เชื่อมต่อ shim จะ fallback ไปที่ชุดเครื่องมือในเครื่อง 7 ตัว (`memory_save`, `memory_recall`, `memory_smart_search`, `memory_sessions`, `memory_export`, `memory_audit`, `memory_governance_delete`) ตัวแปร env `AGENTMEMORY_TOOLS=core|all` เป็น flag ฝั่ง *server* เท่านั้น การตั้งค่ามันใน `env` block ของ shim จะไม่มีผลใด ๆ ถ้าคุณเห็นเครื่องมือเพียง 7 ตัวใน Cursor / OpenCode / Gemini CLI ให้เริ่ม `npx -y @agentmemory/agentmemory@latest` (หรือ Docker stack) และตั้งค่า `AGENTMEMORY_URL=http://localhost:3111`
### 54 Tools
เครื่องมือมีสาม surface เรียงจากเล็กไปใหญ่: `AGENTMEMORY_TOOLS=core` ลดการมองเห็นเหลือ 8 เครื่องมือหลัก (`memory_save`, `memory_recall`, `memory_consolidate`, `memory_smart_search`, `memory_sessions`, `memory_diagnose`, `memory_lesson_save`, `memory_reflect`); ชุด base ด้านล่างคือ 14 เครื่องมือพื้นฐานของ registry; ค่า default (`AGENTMEMORY_TOOLS=all`) เปิดทั้ง 54 ตัว
Base tools (14)
| Tool | Description |
|------|-------------|
| `memory_recall` | ค้นหา observation ในอดีต |
| `memory_compress_file` | บีบอัดไฟล์ markdown โดยรักษาโครงสร้างไว้ |
| `memory_save` | บันทึก insight, decision, หรือ pattern |
| `memory_file_history` | observation ในอดีตเกี่ยวกับไฟล์ที่ระบุ |
| `memory_patterns` | ตรวจจับ pattern ที่เกิดซ้ำ |
| `memory_sessions` | แสดงเซสชันล่าสุด |
| `memory_smart_search` | ค้นหาแบบ hybrid semantic + keyword |
| `memory_vision_search` | ค้นหา observation ที่เป็นรูปภาพ |
| `memory_timeline` | observation ตามลำดับเวลา |
| `memory_profile` | โปรไฟล์ project (concept, ไฟล์, pattern) |
| `memory_export` | export ข้อมูล memory ทั้งหมด |
| `memory_relations` | ค้นหา relationship graph |
| `memory_commit_lookup` | เซสชันที่อยู่หลัง git commit |
| `memory_commits` | commit ที่บันทึกไว้สำหรับเซสชัน |
Extended tools (54 total, the default surface)
| Tool | Description |
|------|-------------|
| `memory_patterns` | ตรวจจับ pattern ที่เกิดซ้ำ |
| `memory_timeline` | observation ตามลำดับเวลา |
| `memory_relations` | ค้นหา relationship graph |
| `memory_graph_query` | ไล่ knowledge graph |
| `memory_consolidate` | รัน 4-tier consolidation |
| `memory_claude_bridge_sync` | sync กับ MEMORY.md |
| `memory_team_share` | แชร์กับสมาชิกทีม |
| `memory_team_feed` | รายการที่แชร์ล่าสุด |
| `memory_audit` | audit trail ของ operation |
| `memory_governance_delete` | ลบพร้อม audit trail |
| `memory_snapshot_create` | snapshot แบบ git-versioned |
| `memory_action_create` | สร้าง work item พร้อม dependency |
| `memory_action_update` | อัปเดตสถานะ action |
| `memory_frontier` | action ที่ไม่ถูกบล็อก เรียงตามความสำคัญ |
| `memory_next` | action ถัดไปที่สำคัญที่สุดเพียงตัวเดียว |
| `memory_lease` | exclusive action lease (multi-agent) |
| `memory_routine_run` | สร้าง workflow routine ขึ้นมาใช้งาน |
| `memory_signal_send` | ส่งข้อความระหว่าง agent |
| `memory_signal_read` | อ่านข้อความพร้อม receipt |
| `memory_checkpoint` | gate ตามเงื่อนไขภายนอก |
| `memory_mesh_sync` | sync แบบ P2P ระหว่าง instance |
| `memory_sentinel_create` | watcher ที่ทำงานตาม event |
| `memory_sentinel_trigger` | สั่งให้ sentinel ทำงานจากภายนอก |
| `memory_sketch_create` | action graph แบบชั่วคราว |
| `memory_sketch_promote` | เลื่อนให้เป็นแบบ permanent |
| `memory_crystallize` | บีบอัด action chain |
| `memory_diagnose` | ตรวจสุขภาพระบบ |
| `memory_heal` | แก้ไข stuck state อัตโนมัติ |
| `memory_facet_tag` | tag แบบ dimension:value |
| `memory_facet_query` | ค้นหาด้วย facet tag |
| `memory_verify` | ย้อนดู provenance |
### 6 Resources · 3 Prompts · 17 Skills
| Type | Name | Description |
|------|------|-------------|
| Resource | `agentmemory://status` | Health, จำนวนเซสชัน, จำนวน memory |
| Resource | `agentmemory://project/{name}/profile` | ข้อมูลเชิงลึกต่อ project |
| Resource | `agentmemory://project/{name}/recent` | observation ล่าสุดของ project |
| Resource | `agentmemory://memories/latest` | memory ที่ active ล่าสุด 10 รายการ |
| Resource | `agentmemory://graph/stats` | สถิติ knowledge graph |
| Resource | `agentmemory://team/{id}/profile` | โปรไฟล์ทีมแบบ shared |
| Prompt | `recall_context` | ค้นหา + คืน context message |
| Prompt | `session_handoff` | ส่งต่อข้อมูลระหว่าง agent |
| Prompt | `detect_patterns` | วิเคราะห์ pattern ที่เกิดซ้ำ |
| Skill | `/recall` | ค้นหาหน่วยความจำ |
| Skill | `/remember` | บันทึกเข้าหน่วยความจำระยะยาว |
| Skill | `/session-history` | สรุปเซสชันล่าสุด |
| Skill | `/forget` | ลบ observation/เซสชัน |
ตารางนี้แสดงแค่ 4 skill หลัก ชุดเต็มมี invocable skill 9 ตัว บวก reference skill อีก 8 ตัว ดู section Native skills ด้านบน
### Standalone MCP
รันโดยไม่ต้องมี server แบบเต็ม สำหรับ MCP client ใดก็ได้ อย่างใดอย่างหนึ่งนี้ใช้ได้:
```bash
npx -y @agentmemory/agentmemory@latest mcp # canonical (always available)
npx -y @agentmemory/mcp # shim package alias
```
หรือเพิ่มลงใน MCP config ของ agent ของคุณ:
agent ส่วนใหญ่ (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI):
```json
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
```
Merge รายการ `agentmemory` เข้าไปใน object `mcpServers` ที่มีอยู่แล้วของ host คุณ อย่าแทนที่ไฟล์ทั้งหมด สำหรับ client แบบ sandbox ที่เข้าถึง `localhost` ของ host ไม่ได้ ให้เพิ่ม `"AGENTMEMORY_FORCE_PROXY": "1"` ลงใน env block และตั้งค่า `AGENTMEMORY_URL` ไปยัง route ที่ sandbox เข้าถึงได้
OpenCode (`opencode.json`):
```json
{
"mcp": {
"agentmemory": {
"type": "local",
"command": ["npx", "-y", "@agentmemory/mcp"],
"enabled": true
}
},
"plugin": ["./plugins/agentmemory-capture.ts"]
}
```
Copy ไฟล์ plugin จาก repo:
```bash
mkdir -p ~/.config/opencode/plugins
cp plugin/opencode/agentmemory-capture.ts ~/.config/opencode/plugins/
cp plugin/opencode/commands/*.md ~/.config/opencode/commands/
```
---

เริ่มทำงานอัตโนมัติบนพอร์ต `3113` viewer จะโหลด snapshot หนึ่งตัวตอนที่เชื่อมต่อ (`GET /agentmemory/viewer/snapshot`) แล้วจึง apply live stream event ต่อ: memory ใหม่, lesson, observation, audit entry, การเปลี่ยนแปลงของ graph และการอัปเดต health จะปรากฏขึ้นโดยไม่ต้อง polling หรือ reload หน้า คำขออื่น ๆ ที่เหลือมีแค่ action ที่คุณกดเอง, การโหลด "load more" เพิ่ม และการค้นหา เมื่อ stream หลุด viewer จะแสดงว่าตัวเลขเก่าไปแค่ไหน เชื่อมต่อใหม่แบบ backoff และ resync จาก snapshot หนึ่งตัว
- **12 แท็บใน 4 กลุ่ม** พร้อม live count, deep link (`#memories/`, `#sessions/?obs=`, `#graph/`, `#health/consolidation`), คีย์ลัด และเมนูสำหรับมือถือ
- **Memories:** ค้นหาฝั่ง server, filter ตาม project, agent และ type, detail panel พร้อม version chain และ word diff, provenance link, ปุ่ม copy สำหรับ id, MCP call และคำสั่ง curl, แก้ไข (สร้าง version ใหม่), forget พร้อมยืนยัน, bulk forget และ export JSON
- **Sessions:** inline observation timeline พร้อม tool input/output ที่อ่านง่าย, filter และ paging, และ memory/lesson ที่แต่ละเซสชันสร้างขึ้น
- **Graph:** ค้นหา, node detail พร้อม relation และ source, legend ที่ไม่พึ่งสีเพียงอย่างเดียว, และปุ่มควบคุม zoom
- **Health:** เวอร์ชัน live ของ `GET /agentmemory/status` ทุกปัญหามาพร้อมวิธีแก้ บวก state backend, สถานะการ save index, ความคืบหน้าของการ compact graph provenance และคำอธิบาย consolidation พร้อม threshold จริง
- หน้า **Audit, Activity, Profile, Replay, Lessons, Actions และ Crystals** แต่ละหน้ามี empty state ที่บอกว่า section นั้นคืออะไร ทำไมมันว่าง และคำสั่งที่จะเติมมันให้เต็ม พร้อม tooltip อธิบายศัพท์ `?` บนทุกคำและตัวเลข
```bash
open http://localhost:3113
```
viewer server จะ bind กับ `127.0.0.1` โดย default และแนบ server secret ไว้ตอน forward คำขอไปยัง REST API ดังนั้นไม่ต้องตั้งค่าอะไรเพิ่ม endpoint `/agentmemory/viewer` ที่ served จาก REST ปฏิบัติตามกฎ bearer-token ตามปกติ และ redirect browser ที่ไม่มี token ไปยัง viewer port ส่วน header CSP ใช้ script nonce ต่อ response และปิดการใช้ inline handler attribute (`script-src-attr 'none'`)
---
viewer ที่ `:3113` แสดงสิ่งที่ agent ของคุณ **จำได้** [iii console](https://iii.dev/docs/console) แสดงสิ่งที่ agent ของคุณ **ทำ**: memory op ทุกตัวเป็น OpenTelemetry trace, KV entry ทุกตัวแก้ไขได้, function ทุกตัวเรียกใช้ได้, stream ทุกตัว tap ดูได้ สองหน้าต่างของหน่วยความจำเดียวกัน: หนึ่งในรูปแบบของ product หนึ่งในรูปแบบของ engine
ดู `memory_smart_search` ยิงออกไปและดู BM25 scan → embedding lookup → RRF fusion → reranker เป็น waterfall แก้ไข consolidation timer ที่ค้างอยู่ใน KV browser Replay hook `PostToolUse` พร้อม payload ที่ปรับแล้ว Pin WebSocket stream และดู observation เข้ามาแบบสด ๆ
agentmemory มอบสิ่งนี้ให้ฟรี เพราะทุก function call และ trigger ยิงผ่าน iii อยู่แล้ว; ไม่มีอะไรต้องสร้างเอง ไม่มีอะไรต้อง instrument เพิ่ม
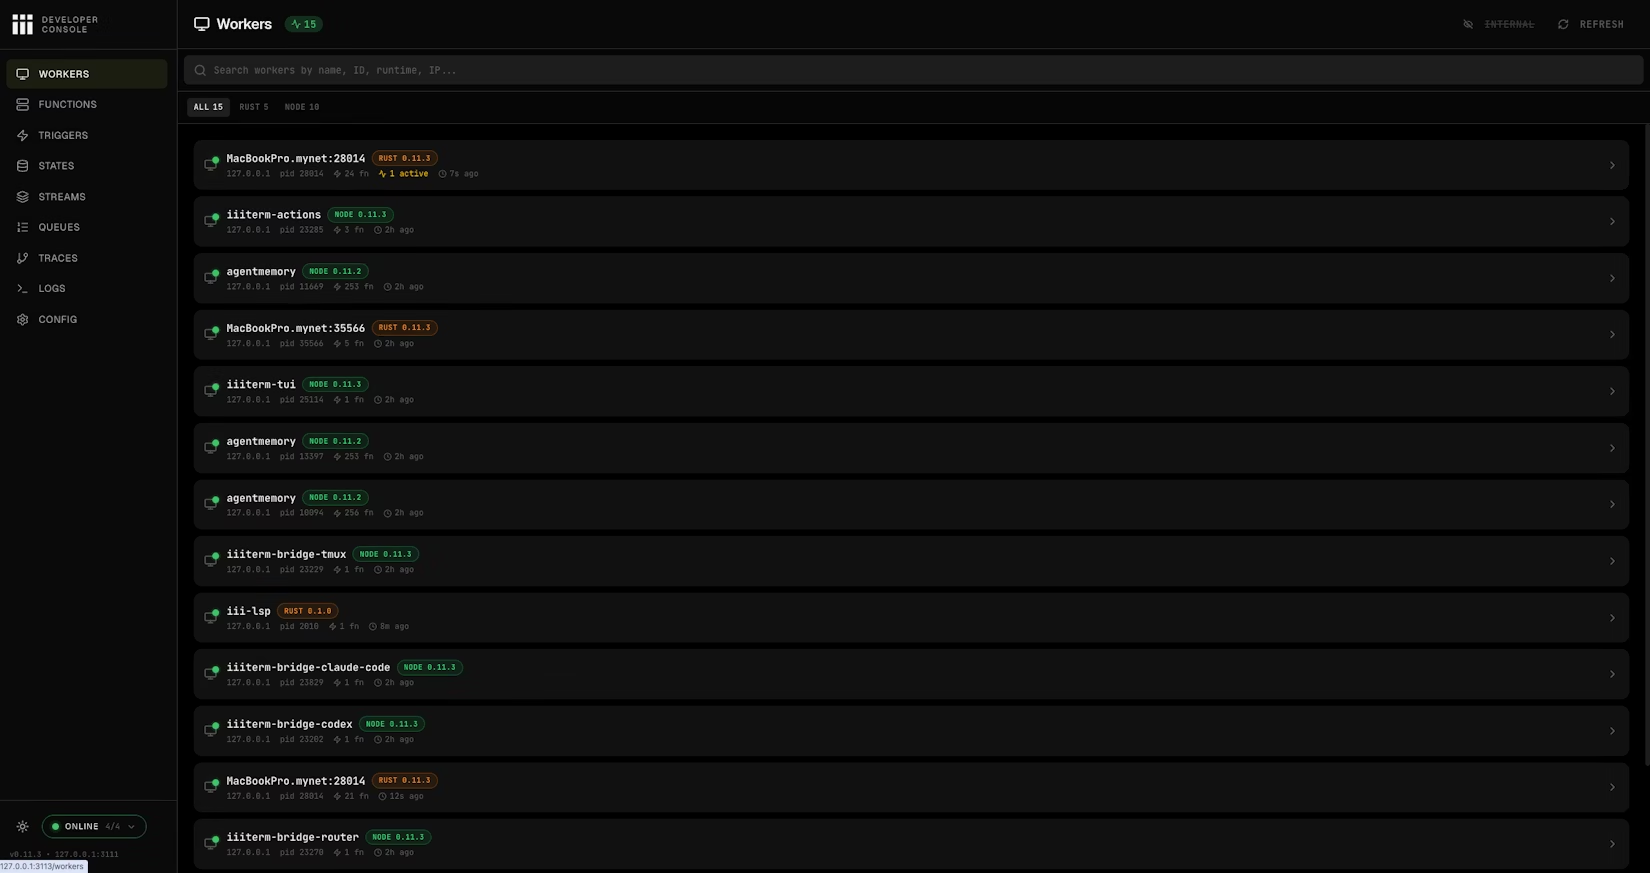
หน้า Workers: worker ที่เชื่อมต่อทุกตัว รวมถึง agentmemory เอง พร้อม PID, จำนวน function, runtime, และ last-seen
**ติดตั้งมาให้แล้ว** console ship มาพร้อม iii engine ที่ pin ไว้ (0.22+); ไม่ต้องติดตั้งอะไรแยก การเปิดครั้งแรกจะดาวน์โหลด console binary ไว้ข้าง ๆ engine
**เปิดใช้งานคู่กับ agentmemory:**
```bash
agentmemory console
```
คำสั่งนี้จะรัน `iii console` ของ engine ที่ pin ไว้ โดยชี้ไปยังพอร์ตที่ agentmemory resolve ไว้ (REST, stream, bridge) และ serve มันที่พอร์ตสูงกว่า viewer หนึ่งพอร์ต คือ `http://localhost:3114` โดย default `--console-port N` เลือกพอร์ตอื่นได้ `--port` และ `--instance` เลือก instance ของ agentmemory แบบเดียวกับที่ใช้กับ `stop`; flag อื่น ๆ ที่เหลือจะถูกส่งผ่านไปตรง ๆ เช่น `--enable-flow` สำหรับหน้า architecture-graph แบบทดลอง
วิธีเดียวกันแบบทำมือ มีประโยชน์เมื่อ `agentmemory` ไม่อยู่ใน PATH:
```bash
~/.agentmemory/bin/iii console --port 3114 \
--engine-port 3111 \
--ws-port 3112 \
--bridge-port 49134
```
**สิ่งที่คุณทำได้จาก console:**
| Page | Use it to |
|------|-----------|
| **Workers** | ดู worker ที่เชื่อมต่ออยู่ทั้งหมดและ metric แบบสดของมัน รวมถึง agentmemory worker เองด้วย |
| **Functions** | เรียก function ของ agentmemory ตัวใดก็ได้ตรง ๆ ด้วย JSON payload; สะดวกสำหรับทดสอบ `memory.recall`, `memory.consolidate`, `graph.query` โดยไม่ต้องเชื่อมต่อ client |
| **Triggers** | Replay trigger แบบ HTTP, cron, event, และ state: ยิง consolidation cron ด้วยมือ, retry HTTP route, ส่ง state change |
| **States** | KV browser ที่ CRUD ได้เต็มรูปแบบบน session, memory slot, lifecycle timer, และ embeddings index; แก้ค่าได้ตรง ๆ |
| **Streams** | monitor WebSocket แบบสดสำหรับ memory write, hook event, และการอัปเดต observation ขณะไหลผ่าน iii stream |
| **Queues** | durable queue topic + การจัดการ dead-letter Replay หรือ drop embedding / compression job ที่ล้มเหลว |
| **Traces** | มุมมอง OpenTelemetry waterfall / flame / service-breakdown filter ด้วย `trace_id` เพื่อดูว่า `memory.search` ครั้งเดียวสร้าง function, DB call, และ embedding request ใดบ้าง |
| **Logs** | OTEL log แบบ structured ที่ filter และเชื่อมโยงกับ trace/span ID |
| **Config** | การตั้งค่า runtime: ดูว่า worker, provider, และพอร์ตใดที่ engine ของคุณกำลังรันอยู่ |
| **Flow** | (Optional, `--enable-flow`) กราฟ architecture แบบโต้ตอบของทุก worker, trigger, และ stream |
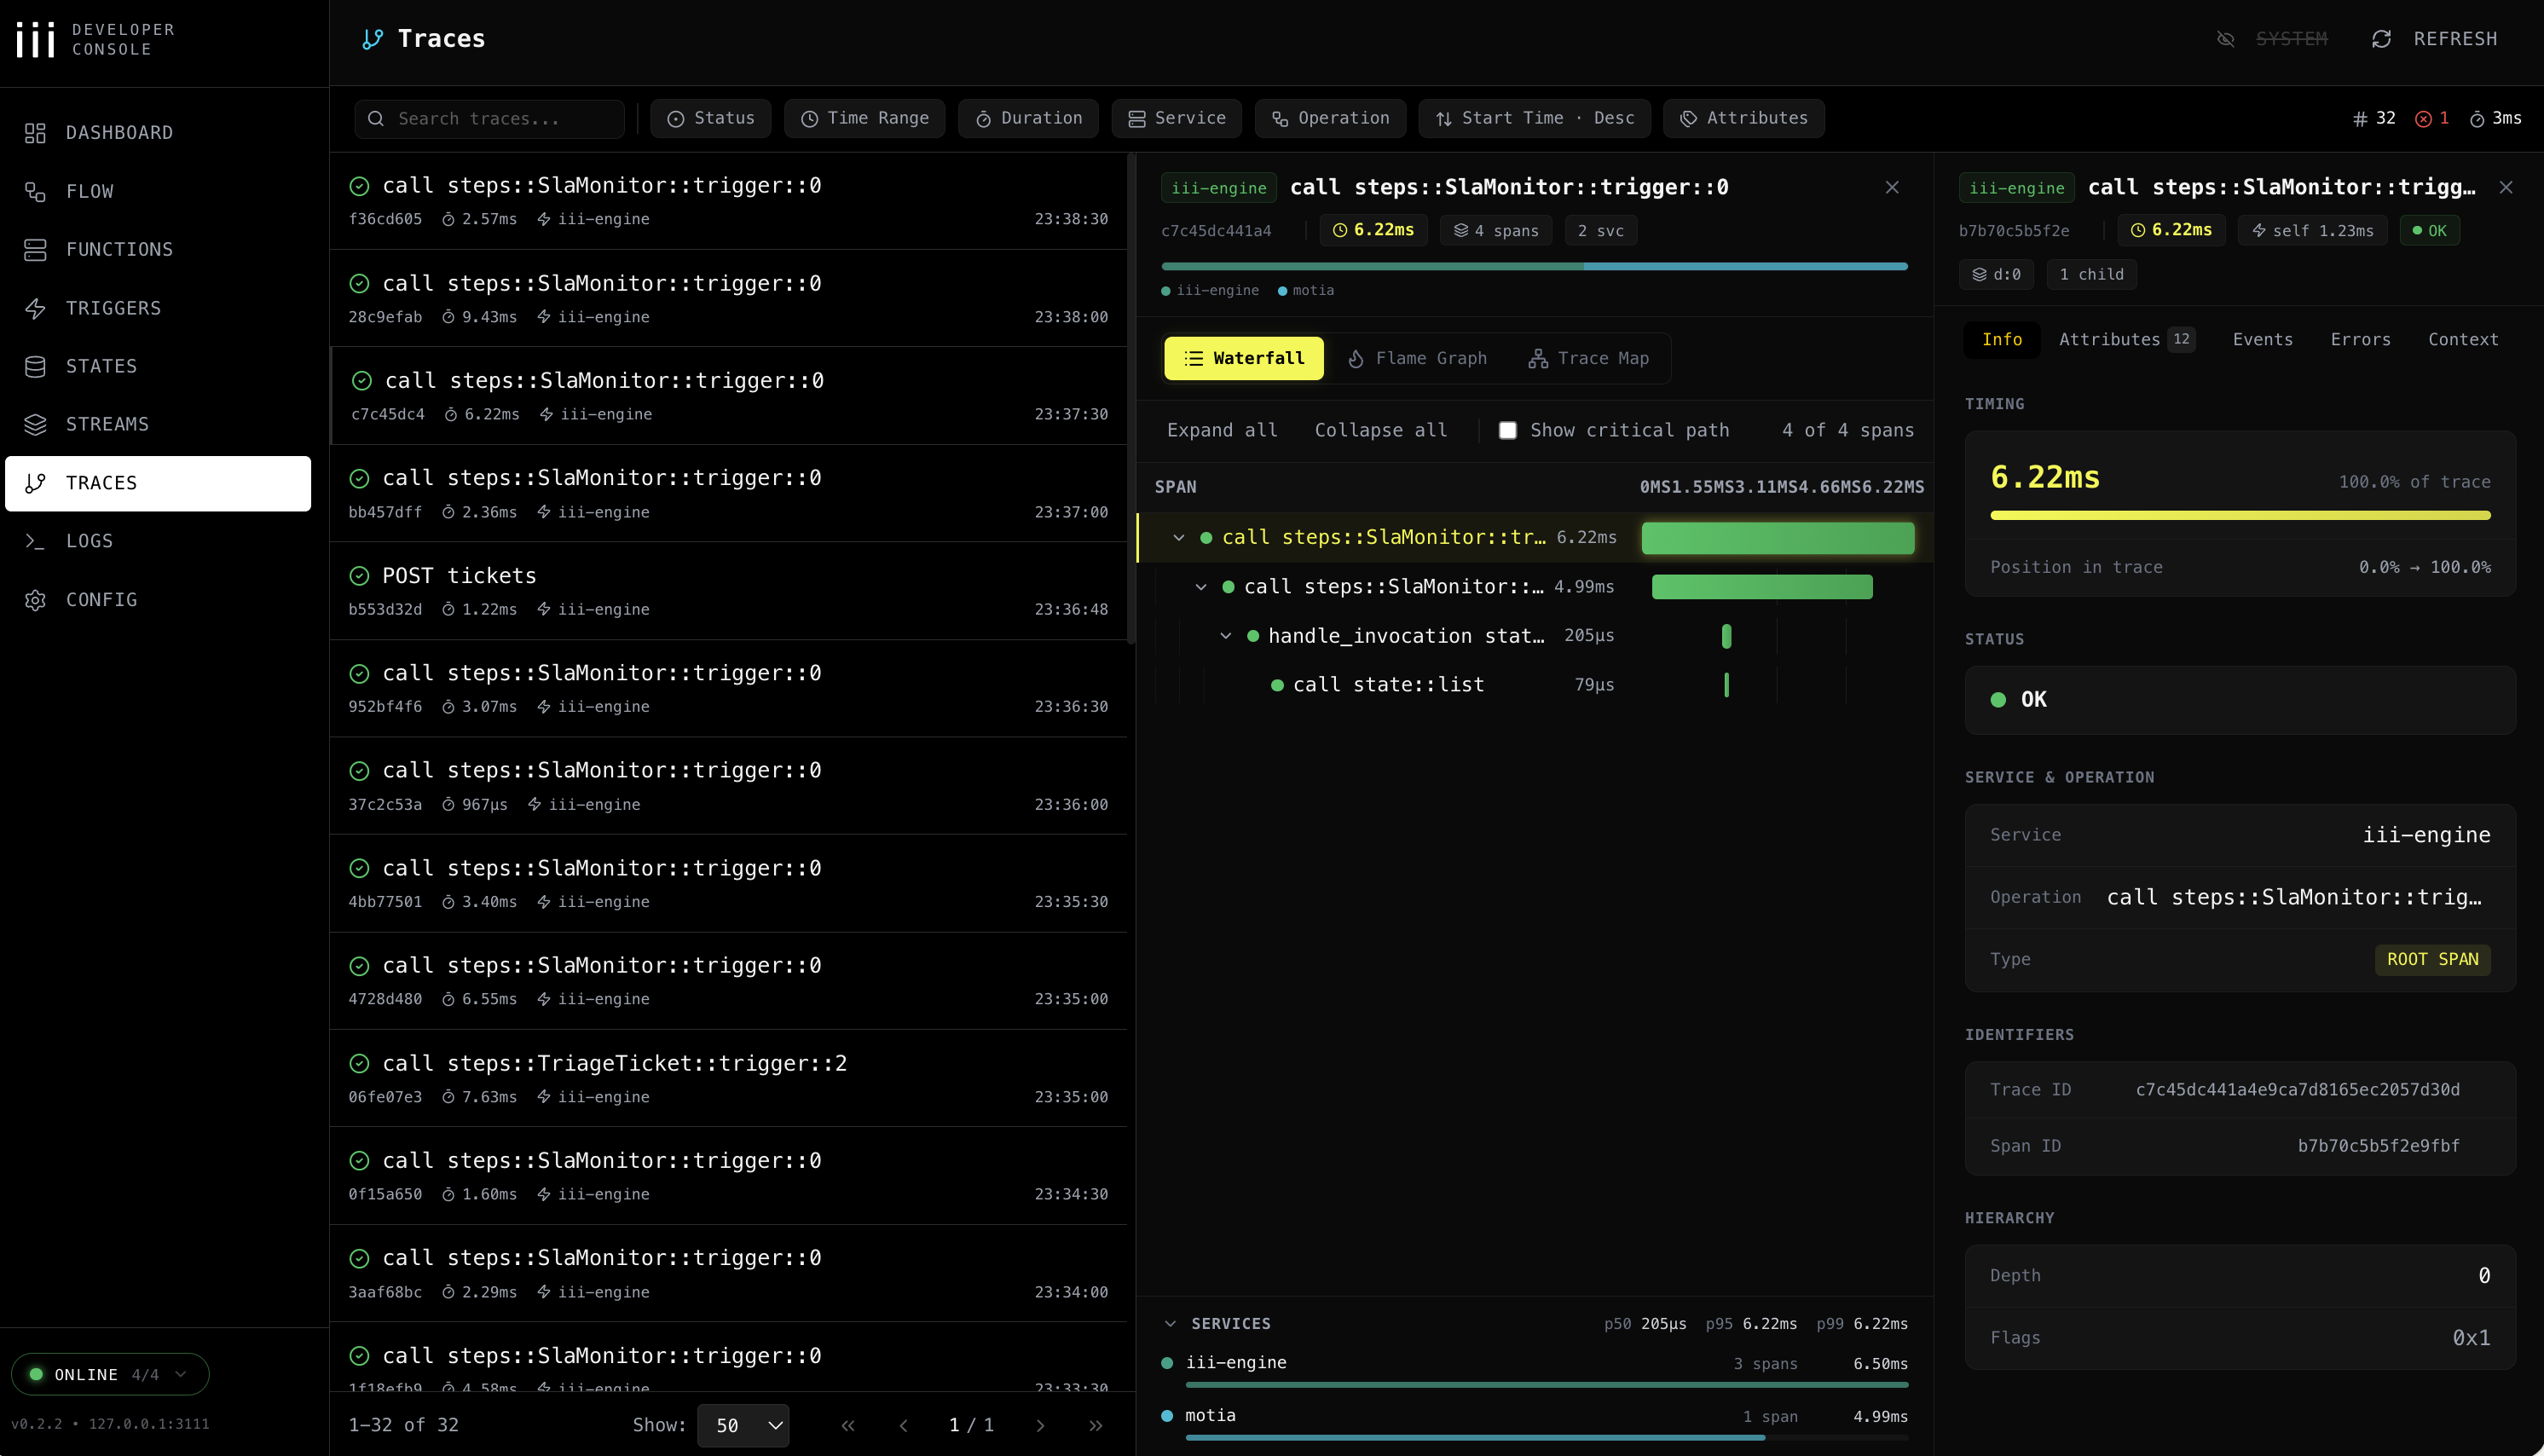
Traces: waterfall / flame / service breakdown สำหรับทุก memory operation
**Trace ถูกเปิดไว้อยู่แล้ว:**
`iii-config.yaml` ship มาพร้อม worker `iii-observability` ที่เปิดใช้งานไว้ (`exporter: memory`, `sampling_ratio: 0.1`, metrics + logs) ไม่ต้องตั้งค่าเพิ่ม ทันทีที่ agentmemory เริ่มทำงาน memory operation ทุกตัวจะปล่อย structured log ที่ console อ่านได้ และหนึ่งในสิบของมัน (`sampling_ratio: 0.1`) จะปล่อย trace span ด้วย
ถ้าต้องการ export ไปยัง Jaeger/Honeycomb/Grafana Tempo แทน ให้เปลี่ยน `exporter: memory` เป็น `exporter: otlp` และตั้งค่า collector endpoint ตามเอกสาร observability ของ iii
> **ข้อควรระวัง:** console เองไม่มีการบังคับใช้ auth เลย ให้ bind มันไว้กับ `127.0.0.1` (ค่า default) และอย่าเปิดให้เข้าถึงจากสาธารณะเด็ดขาด
---

agentmemory คือ **instance ของ [iii](https://iii.dev) ที่กำลังรันอยู่แล้ว** primitive สามตัว (worker, function, trigger) ประกอบกันเป็น runtime; KV state, stream, และ OTEL trace มาจาก worker iii-state, iii-stream, และ iii-observability ที่ ship มากับ iii คุณไม่ได้ติดตั้ง Postgres, Redis, Express, pm2, หรือ Prometheus เลย เพราะ iii มาแทนที่สิ่งเหล่านั้นทั้งหมด
นั่นหมายความว่าแค่อีกคำสั่งเดียวก็ขยาย agentmemory ให้มีความสามารถใหม่ทั้งชุดได้
### Extend agentmemory with more workers
builtin ที่ agentmemory ต้องใช้มีอยู่ใน `iii-config.yaml` แล้วและ boot มาคู่กัน: `iii-state` (KV), `iii-queue` (durable retry สำหรับ event subscriber), `iii-pubsub`, `iii-cron`, `iii-stream`, และ `iii-observability` (OTEL trace, metric และ log บนทุก function) สิ่งอื่น ๆ จาก [iii worker registry](https://workers.iii.dev) เสียบเข้ากับ engine ตัวเดียวกันนี้ได้: copy `iii-config.yaml` ไปที่ `~/.agentmemory/iii-config.yaml` (CLI จะเลือกไฟล์นี้ก่อนไฟล์ที่ bundle มา และยัง render พอร์ตกับ data path ลงไปในไฟล์นี้เหมือนเดิม) เพิ่มรายการเข้าไป ติดตั้ง worker runtime ครั้งเดียวด้วย `~/.agentmemory/bin/iii update worker` แล้ว restart agentmemory
```yaml
workers:
# ...the bundled entries...
- name: database # SQL-backed state adapter when you outgrow the KV defaults
- name: iii-sandbox # run code that came out of memory_recall inside a throwaway VM
- name: mcp # extra MCP servers next to agentmemory's, same engine
```
| Worker | สิ่งที่คุณได้เพิ่มจาก agentmemory |
|---|---|
| [`database`](https://workers.iii.dev/workers/database) | SQL-backed state adapter เมื่อ KV default ในหน่วยความจำไม่พอแล้ว |
| [`iii-sandbox`](https://workers.iii.dev/workers/iii-sandbox) | โค้ดที่มาจาก `memory_recall` รันอยู่ใน VM แบบใช้แล้วทิ้ง ไม่ใช่ shell ของคุณ |
| [`mcp`](https://workers.iii.dev/workers/mcp) | ตั้ง MCP server เพิ่มเติมข้าง ๆ ของ agentmemory ใช้ engine ตัวเดียวกัน |
บน engine 0.22.x ให้คงชื่อที่มี prefix `iii-` ไว้สำหรับ builtin ด้านบน; รายการ `http`, `state`, `queue`, `pubsub` และ `cron` ที่ไม่มี prefix คือ worker จาก registry แบบ standalone ที่ agentmemory จะย้ายไปใช้ตอน migrate เป็น 0.23
Registry แบบเต็ม: [workers.iii.dev](https://workers.iii.dev) worker ทุกตัวที่นั่นประกอบขึ้นผ่าน primitive ตัวเดียวกับที่ agentmemory ใช้ และ agentmemory ที่คุณมีอยู่แล้วก็เป็นหนึ่งในนั้นเอง
### Engine config and bind address
`agentmemory start` จะอ่าน engine config จากไฟล์แรกที่มีอยู่: `AGENTMEMORY_III_CONFIG`, `./iii-config.yaml` ใน directory ปัจจุบัน, `~/.agentmemory/iii-config.yaml`, จากนั้นจึงเป็น `iii-config.yaml` ที่ bundle มา ทุกครั้งที่เริ่มทำงาน มันจะ render ไฟล์นั้น (data path, พอร์ต, state backend) ลงไปที่ `~/.agentmemory/data/iii-config.runtime.yaml` และเริ่ม engine ด้วยไฟล์ที่ render แล้ว ดังนั้นให้แก้ไฟล์ source ไม่ใช่ไฟล์ที่ render ออกมา ค่า `host:` ของไฟล์ source จะถูกเก็บไว้ตามที่เขียนไว้
`iii-config.yaml` ที่ bundle มาตั้งใจ bind `127.0.0.1` และค่า default นั้นก็ใช้กับภายใน container ด้วย CLI ที่เริ่มในคอนเทนเนอร์จะ listen บน loopback ของคอนเทนเนอร์ ดังนั้นพอร์ตที่ publish ออกมาจะเข้าไม่ถึงอะไรเลย หากต้องการ serve CLI ที่อยู่ใน container ผ่านพอร์ตที่ publish ไว้ ให้ตั้งค่า `AGENTMEMORY_III_CONFIG` ไปที่ config ที่ bind `0.0.0.0` `iii-config.docker.yaml` ที่แพ็กเกจมาให้คือหนึ่งในนั้น: มัน bind `iii-http`, `iii-stream` และพอร์ตของ engine ไว้ที่ `0.0.0.0` และเก็บ state ไว้ใต้ `/data` ดังนั้นให้ mount volume ที่เขียนได้ไว้ที่นั่น ตั้งค่า `AGENTMEMORY_SECRET` ไว้เสมอ และ publish แค่พอร์ตที่คุณต้องการ บน `127.0.0.1` หรืออยู่หลัง proxy ที่คุณเชื่อถือได้
`docker-compose.yml` ของ repo นี้ไม่ผ่าน config lookup ของ CLI: มัน mount `iii-config.docker.yaml` ไว้ที่ `/app/config.yaml` และ container `iii-engine` เริ่มด้วย `--config /app/config.yaml` เทมเพลต [deploy](../deploy/) แบบ one-click เขียน config `0.0.0.0` ของตัวเองไว้ใน entrypoint
### Storage backend: file (default) vs redis
`iii-state` และ `iii-stream` ใช้ KV store แบบไฟล์ของ iii-engine เป็น default: หนึ่งไฟล์ JSON ต่อ scope เก็บไว้ในหน่วยความจำของ engine process และเขียนลงดิสก์ตาม timer นั่นคือค่า default ที่เหมาะกับการติดตั้งแบบ single-user ในเครื่อง ส่วน daemon ที่ใช้ร่วมกันโดยมีผู้เขียนหลายคนพร้อมกันจะได้การเขียนต่อ key จริง ๆ จาก Redis แทน โดยแลกมาด้วย network round trip ต่อ operation (ทุก `state::*` call ก็ยัง serialize บน Redis connection เดียวอยู่ดี ดังนั้นนี่คือการแลก lock ของ file store กับ socket ไม่ใช่การแลกเพื่อ parallelism)
ตั้งค่า `AGENTMEMORY_STATE_BACKEND=redis` (พร้อม `AGENTMEMORY_REDIS_URL`) เพื่อสลับทั้งสอง worker ไปใช้ adapter `redis` ในตัวของ iii-engine ซึ่งเก็บแต่ละ key เป็น Redis hash field (`HSET`) แทนการเขียนทั้ง scope ใหม่ทุกครั้งที่เขียน:
```env
# ~/.agentmemory/.env
AGENTMEMORY_STATE_BACKEND=redis
AGENTMEMORY_REDIS_URL=redis://localhost:6379
```
`AGENTMEMORY_STATE_BACKEND` ค่า default คือ `file`; ถ้าไม่ตั้งค่าไว้ พฤติกรรมปัจจุบันจะไม่เปลี่ยนแปลง และค่าที่ไม่รู้จัก (อะไรก็ตามที่ไม่ใช่ `file` หรือ `redis`) จะเป็น startup error ไม่ใช่การ fallback แบบเงียบ ๆ `/agentmemory/status` และหน้า Health ของ viewer (แถว State store) จะรายงานว่า backend ตัวใด active อยู่ และตอบสนองหรือไม่ แต่ไม่รายงาน URL
**รองรับแค่ `redis://` ธรรมดาเท่านั้น** engine ที่ pin ไว้ (0.22.1) build Redis client ของมันมาโดยไม่รองรับ TLS ดังนั้น URL แบบ `rediss://` (Redis ที่ managed ส่วนใหญ่ เช่น Upstash, Redis Cloud, และ ElastiCache ที่เข้ารหัสระหว่างส่ง มักจะ default เป็น TLS-only) จะเชื่อมต่อไม่ได้ การเชื่อมต่อนี้ไม่เข้ารหัส ดังนั้น password ของ Redis และ memory ที่เก็บไว้ทุกตัวจะวิ่งผ่านสายแบบ clear text: ให้ชี้ไปที่ Redis ในเครื่องหรือ Redis บน private network ที่คุณเชื่อถือได้ สำหรับ Redis อื่น ๆ ให้รัน encrypted tunnel (stunnel, SSH, หรือ VPN) บน host ของ agentmemory เพื่อให้ hop แบบ `redis://` ธรรมดาอยู่บน host นั้นเอง และ upstream connection ของ tunnel ถูกเข้ารหัสและยืนยันตัวตนแล้ว ถ้า password ของ Redis มี single quote ให้ percent-encode มัน (`%27`); engine จะขยาย URL เข้าไปใน YAML config ของมันก่อน parse
**Redis server หนึ่งตัวต่อหนึ่ง `--instance`** prefix ของ Redis key ของ engine (`state:`, `stream::`) ถูกตรึงไว้ ดังนั้น agentmemory สอง instance (`--instance 1`, `--instance 2`, ...) ที่ชี้ไปยัง database เดียวกันจะเขียนทับข้อมูลกันเอง database index ที่แยกกัน (`redis://localhost:6379/1`) จะแยกข้อมูลที่เก็บไว้ แต่ engine จะส่ง live viewer event ผ่าน Redis pub/sub channel เดียว (`stream::events`) และ Redis pub/sub จะไม่สนใจ database index ดังนั้น viewer ของแต่ละ instance จะยังเห็น live event ของอีก instance อยู่ดี ให้แต่ละ instance มี Redis server (หรือพอร์ต) ของตัวเองเมื่อคุณรันมากกว่าหนึ่งตัว
**สิ่งที่เหมือนเดิม และสิ่งที่ต่างไป** ทุกฟีเจอร์ของ agentmemory ทำงานได้บน Redis: session, observation, memory (remember, supersede, evolve, forget), การค้นหาและ index bucket, lesson, graph, audit log และ scope รายเดือนของมัน, export และ import, governance delete, สถานะ consolidation, viewer snapshot กับ live stream ของมัน, และ health monitor engine เก็บแต่ละ scope เป็น Redis hash ตัวเดียว (`HSET`/`HGET`/`HGETALL`) และยิง state trigger ตัวเดียวกับที่ file store ใช้ มีความแตกต่างของ engine 3 อย่างที่ agentmemory จัดการให้ภายใน:
- Redis คืน record ของ scope มาแบบไม่มีลำดับที่แน่นอน agentmemory จะเรียงจากเก่าสุดก่อน (ตามเวลาที่สร้างใน record id แล้วตามด้วย timestamp) เพื่อให้ list, paging และ export chunk กลับมาในลำดับเดียวกับบน file store
- engine ทำ partial update บน Redis ผ่าน Lua script ที่เปลี่ยน array ว่างเป็น object ว่าง agentmemory จะ apply update เหล่านั้นด้วยตัวเอง (อ่าน, เปลี่ยน, เขียนภายใต้ lock ต่อ key) บน Redis เพื่อให้ field เช่น `tags: []` ยังคงเป็น array
- การตรวจสอบ audit log แบบเก่าจะอ่าน scope เก่าจาก Redis แทนการมองหาไฟล์ของ file store บนดิสก์
มีความแตกต่างหนึ่งอย่างที่คุณต้องจัดการเอง: **หลัง Redis restart engine จะหยุดส่ง live event** ไปยัง viewer จนกว่า agentmemory จะ restart ข้อมูลยังถูก save และอ่านได้ตามปกติ health monitor จะส่ง test event ผ่าน Redis ทุก 30 วินาที เมื่อมันไม่กลับมา `/agentmemory/status` และหน้า Health ของ viewer จะแสดง "Live updates are not reaching the viewer" พร้อมวิธีแก้: restart agentmemory ถ้า Redis ล้ม status report จะแสดง "The state store is not answering" และวิธีตรวจสอบ (`redis-cli -u "$AGENTMEMORY_REDIS_URL" ping`) การ list scope ขนาดใหญ่มากจะอ่าน hash ทั้งหมดใน `HGETALL` เดียว ซึ่งมีค่าใช้จ่ายเท่ากับที่ file store เก็บมันไว้ในหน่วยความจำ
**ค่า Redis ที่แนะนำ** นโยบาย snapshot default `save 3600 1 300 100 60 10000` อาจทำให้เสีย write ไปหลายนาทีถ้า crash ซึ่งแย่กว่า window การ flush 5 วินาทีของ file store ตั้งค่า `appendonly yes` สำหรับสิ่งที่คุณไม่อยากเสีย ตั้งค่า `maxmemory-policy noeviction`; `allkeys-lru` หรือคล้ายกันจะลบ memory ทิ้งแบบเงียบ ๆ เมื่อ Redis ถึง memory limit
การเริ่มแบบ native (ไม่ใช่ Docker) และเทมเพลต [deploy](../deploy/) แบบ one-click ทุกตัว (ซึ่งเขียนทับ `iii-config.yaml` ที่ bundle มาและเริ่มแบบ native) จะอ่าน `AGENTMEMORY_STATE_BACKEND`/`AGENTMEMORY_REDIS_URL` และ render มันลงไปใน `iii-config` ที่เริ่มทำงาน ตัว URL เองไม่ถูกเขียนลงไฟล์ที่ render แล้วเลย มีแต่การอ้างอิง `${AGENTMEMORY_REDIS_URL}` ที่ engine process จะขยายจาก environment ของมันเองตอน boot มีเพียงเส้นทาง Docker Compose ของ repo นี้เอง (`AGENTMEMORY_USE_DOCKER=1` หรือการ resume engine ที่เริ่มด้วยวิธีนั้นไปแล้ว) ที่ mount `iii-config.docker.yaml` แบบ read-only และไม่ render เลย `agentmemory start` จะเตือนเมื่อตรวจพบ combination นั้น สลับไฟล์นั้นด้วยมือ ตามรูปแบบ `name: redis` / `config: redis_url: ...` เดียวกันตามที่แสดงไว้ใน worker doc ของ [iii-state](https://workers.iii.dev/workers/iii-state) และ [iii-stream](https://workers.iii.dev/workers/iii-stream) แล้วชี้ `redis_url` ไปยัง Redis ที่เข้าถึงได้จาก container `docker-compose.yml` ส่ง `AGENTMEMORY_REDIS_URL` เข้าไปใน engine container ดังนั้น `redis_url: '${AGENTMEMORY_REDIS_URL}'` ใช้ได้ที่นั่นและเก็บ URL ไว้ไม่ให้อยู่ในไฟล์ที่ mount
config ที่ render แล้วจะเก็บ URL ไม่ให้อยู่ใน `~/.agentmemory/data/iii-config.runtime.yaml` แต่ configuration worker ของ engine เองยังคง persist ค่าที่ *ขยายแล้ว* ไปที่ `~/.agentmemory/config/iii-state.yaml` และ `iii-stream.yaml` ทันทีที่มัน boot (การขยาย `${VAR}` ของ iii-engine เกิดขึ้นก่อนที่ worker นั้นจะเก็บ seed ของมัน และมันเก็บค่าที่ resolve แล้ว ไม่ใช่ตัวอ้างอิง) ให้ปฏิบัติกับ directory นั้นเหมือนมันเก็บ credential ไว้: `chmod 700 ~/.agentmemory` บน shared host ใด ๆ และเลือกใช้ Redis ACL user ที่ scope ไว้เท่าที่ agentmemory ต้องการ มากกว่า admin credential ของ database
**การ migrate ไม่เกิดขึ้นอัตโนมัติ** การสลับ `AGENTMEMORY_STATE_BACKEND` จะเริ่มจาก store ที่ว่างเปล่าทั้งสองฝั่ง ไม่มีอะไร copy ข้อมูลเดิมจาก file ไป Redis หรือกลับกันให้เลย export จาก backend ที่คุณกำลังออกจาก แล้ว import เข้า backend ที่คุณกำลังจะไป ขั้นตอนนี้ทำงานเหมือนกันทั้งบน bash และ zsh (รวมถึง `bash -u`) array แบบ `AUTH=(${AGENTMEMORY_SECRET:+-H "Authorization: Bearer $AGENTMEMORY_SECRET"})` ทำงานไม่เหมือนกัน: zsh จะเก็บ header เป็นคำเดียวที่ผิดรูป ในขณะที่ bash จะแยกมันเป็นสองคำ ดังนั้นทั้งสองคำขอจะได้ 401 ทุกครั้งที่ตั้งค่า `AGENTMEMORY_SECRET` ไว้:
```bash
# 0. Use the generated secret when none is exported:
AGENTMEMORY_SECRET="${AGENTMEMORY_SECRET:-$(cat ~/.agentmemory/secret 2>/dev/null)}"
# 1. On the old backend, while agentmemory is still running on it:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" http://localhost:3111/agentmemory/export > backup.json
else
curl -fsS http://localhost:3111/agentmemory/export > backup.json
fi
# 2. Confirm backup.json is a usable export before switching backends:
jq -e '.version and .exportedAt' backup.json > /dev/null || {
echo "backup.json is not a valid export; do not switch backends" >&2
exit 1
}
# 3. Switch AGENTMEMORY_STATE_BACKEND (and AGENTMEMORY_REDIS_URL if needed),
# restart agentmemory against the new backend, then:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
else
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
fi
```
`/agentmemory/export` ยังรับ `?maxSessions=` และ `?offset=` สำหรับแบ่ง corpus ขนาดใหญ่ออกเป็นหลายคำขอ; `strategy` ตอน import คือ `merge` (ปลอดภัยโดย default), `replace`, หรือ `skip`
### What iii replaces
| Traditional stack | agentmemory ใช้ |
|---|---|
| Express.js / Fastify | iii HTTP Triggers |
| SQLite / Postgres + pgvector | iii KV State + vector index ในหน่วยความจำ |
| SSE / Socket.io | iii Streams (WebSocket) |
| pm2 / systemd | iii engine worker supervision |
| Prometheus / Grafana | iii OTEL + health monitor |
| Custom plugin systems | `iii worker add ` |
**219 source file · ~52,000 LOC · 2,500+ การทดสอบ · 311 function · 60 KV scope** ทั้งหมดอยู่บน primitive สามตัว ไม่มี `agentmemory plugin install` ระบบ plugin ก็คือ iii เองนั่นแหละ
---

### LLM Providers
agentmemory ตรวจจับ provider จาก environment ของคุณอัตโนมัติ provider จะทำให้ operation ที่ใช้ LLM พร้อมใช้งาน แต่การตั้งค่า provider เพียงอย่างเดียวไม่เปิดการบีบอัด observation ด้วย LLM เส้นทางนั้นต้องมีทั้ง provider และ `AGENTMEMORY_AUTO_COMPRESS=true`
| Provider | Config | Notes |
|----------|--------|-------|
| **No-op (default)** | ไม่ต้องตั้งค่า | ปิดการ compress/summarize ด้วย LLM synthetic compression และ BM25 recall ยังทำงานอยู่ ดู `AGENTMEMORY_ALLOW_AGENT_SDK` ด้านล่างถ้าคุณเคยพึ่ง Claude-subscription fallback |
| Anthropic API | `ANTHROPIC_API_KEY` | คิดค่าใช้จ่ายตาม token |
| MiniMax | `MINIMAX_API_KEY` | เข้ากันได้กับ Anthropic |
| Gemini | `GEMINI_API_KEY` | เปิด embedding ด้วย |
| OpenRouter | `OPENROUTER_API_KEY` | โมเดลใดก็ได้ |
| OpenAI API | `OPENAI_API_KEY` | default `gpt-5.6-luna`, override ด้วย `OPENAI_MODEL` |
| **Local (Ollama / LM Studio / vLLM / llama.cpp)** | `OPENAI_API_KEY=local` + `OPENAI_BASE_URL=http://localhost:11434/v1` (Ollama) หรือ `http://localhost:1234/v1` (LM Studio) + `OPENAI_MODEL=` | ทุกอย่างที่เข้ากันได้กับ OpenAI API ไม่มีค่าใช้จ่าย รันบน hardware ของคุณเอง ดู [Local models](#local-models-ollama--lm-studio--vllm) ด้านล่าง |
| Claude subscription fallback | `AGENTMEMORY_ALLOW_AGENT_SDK=true` | ต้องเปิดเองเท่านั้น จะ spawn session `@anthropic-ai/claude-agent-sdk`; เคยทำให้เกิด Stop-hook recursion แบบไม่มีขอบเขต จึงไม่ใช่ default อีกต่อไป |
### Local models (Ollama / LM Studio / vLLM)
agentmemory คุยกับ server ใดก็ได้ที่เข้ากันได้กับ OpenAI API ดังนั้นอะไรก็ตามที่ expose `/v1/chat/completions` ใช้งานได้โดยไม่ต้องแก้โค้ดเลย ไม่มี key แบบเสียเงิน ไม่มี cloud ไม่มี rate limit รันทั้งหมดบน hardware ของคุณเอง
**Ollama** (default port `11434`):
```bash
ollama pull qwen3:8b # or qwen3:4b, gpt-oss:20b, qwen3-coder:30b, etc.
ollama serve
```
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=ollama # any non-empty string; Ollama ignores it
OPENAI_BASE_URL=http://localhost:11434/v1
OPENAI_MODEL=qwen3:8b
```
**LM Studio** (default port `1234`):
เปิด LM Studio → แท็บ Local Server → Start Server เลือกโมเดลแชทตัวใดก็ได้จาก picker (Qwen 3, gpt-oss, DeepSeek R1, เป็นต้น)
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=lmstudio # any non-empty string; LM Studio ignores it
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_MODEL=qwen3-8b # match the model name from LM Studio
```
**vLLM / llama.cpp / Text Generation Inference**: รูปแบบเดียวกัน ชี้ `OPENAI_BASE_URL` ไปยัง URL ที่ server ของคุณ expose และตั้งค่า `OPENAI_MODEL` เป็นชื่อที่ server ของคุณยอมรับ
**โมเดลที่แนะนำสำหรับงาน memory**: compression และ summarization เป็นงานสั้น ๆ (input <2K token, output <500 token) ที่โมเดล instruct ขนาด 7B ก็เพียงพอแล้ว คำแนะนำ:
| Model | Size | Why |
|-------|------|-----|
| `qwen3:8b` | ~5.2 GB | default ที่สมดุลดีบนเครื่อง 16 GB แข็งแรงเรื่องการสกัดข้อมูลและข้อความแบบ tool-shaped |
| `qwen3:4b` | ~2.6 GB | ตัวเล็กที่สุดที่ยังใช้งานได้ ใช้กับ compression ได้ดี แต่อ่อนกว่าเรื่อง graph extraction |
| `qwen3-coder:30b` | ~19 GB | ตัวเลือก local ที่ดีที่สุดสำหรับเซสชันที่เป็นโค้ด (30B MoE, active 3.3B) บน hardware 24-32 GB |
| `gpt-oss:20b` | ~14 GB | โมเดลทั่วไปที่แข็งแรงและพอดีกับ RAM 16 GB |
| `deepseek-r1:8b` | ~5.2 GB | reasoning distill; ช้ากว่าแต่ extraction สะอาดกว่า |
โมเดล Qwen 3 จะคิดก่อนตอบโดย default และอาจใช้ token budget ทั้งหมดไปกับการ reasoning ก่อนที่จะมี output ออกมา ตั้งค่า `AGENTMEMORY_LLM_NOTHINK=1` เพื่อต่อท้าย `/no_think` เข้าไปใน prompt ของ graph-extraction และเพิ่ม `MAX_TOKENS` (16384 ใช้ได้ดี) ถ้า extraction กลับมาว่างเปล่า
โมเดลตระกูล reasoning (สไตล์ `o1` ที่มี block ``) อาจคืน `content` ว่างพร้อม field `reasoning` ที่ server ในเครื่องของคุณอาจไม่ expose ให้เห็น ถ้า extraction กลับมาว่าง ให้สลับไปใช้โมเดลที่ไม่ใช่ reasoning ก่อน env `OPENAI_REASONING_EFFORT=none` ยังปิดการคิดได้บนโมเดล thinking ของ Ollama Cloud ที่เลียนแบบ schema reasoning ของ OpenAI ด้วย
Local embedding ship มาเป็น optional dependency แต่ไม่ได้เปิดใช้โดย default ตั้งค่า `EMBEDDING_PROVIDER=local` เพื่อเปิดใช้ `Xenova/all-MiniLM-L6-v2` (384 มิติ) คำขอ embedding ครั้งแรกจะดาวน์โหลดโมเดล หลังจากนั้น inference จะทำงานในเครื่อง ถ้าไม่ได้ตั้งค่านี้หรือไม่มี remote embedding key vector จะปิดอยู่ `mem::search` จะใช้ BM25 และ `smart-search` ยังสามารถเพิ่ม graph match ที่มีอยู่แล้วได้
### Cost-aware model selection
เมื่อเปิดการบีบอัดพื้นหลังด้วย LLM ทั้งที่มี provider และ `AGENTMEMORY_AUTO_COMPRESS=true` มันจะรันบนทุก observation ดังนั้นการเลือกโมเดลมีผลต่อค่าใช้จ่ายรายเดือนอย่างมีนัยสำคัญ ข้อมูล workload ที่จับได้จริง: 635 คำขอ / 888K token / 35 ชั่วโมงของการใช้งานจริง รันเทียบกับโมเดล OpenRouter สามตัวตามราคา ณ วันที่ 2026-05-23
| Tier | Model | Input / 1M | Output / 1M | ค่าใช้จ่ายสำหรับ 35 ชม.ที่จับได้ | Notes |
|------|-------|------------|-------------|---------------------------|-------|
| แนะนำ | `deepseek/deepseek-v4-flash-0731` | $0.07 | $0.14 | ~$0.07 (ประมาณ) | DeepSeek เวอร์ชันล่าสุด; ตัวเลือกที่ถูกที่สุดที่แนะนำสำหรับงาน compression |
| แนะนำ | `deepseek/deepseek-v4-pro` | $0.435 | $0.87 | ~$0.46 | คุณภาพ compression + summarization ที่ดี ในราคาต่ำกว่า Sonnet ประมาณ 10 เท่า |
| แนะนำ | `qwen/qwen3-coder` | $0.45 | $1.80 | ~$0.55 | reasoning เรื่องโค้ดที่แข็งแรงถ้าเซสชันของคุณเน้นโค้ดเป็นหลัก |
| Premium | `anthropic/claude-sonnet-5` | $3.00 | $15.00 | ~$5.02 (ประมาณ) | ราคาหน้า list เดียวกับการรัน Sonnet 4.6 ที่วัดไว้; ราคาเปิดตัว $2/$10 จนถึง 2026-08-31 |
| Premium | `openai/gpt-5.6-sol` | $5.00 | $30.00 | ~$9 (ประมาณ) | ระดับ flagship; แพงเกินไปสำหรับงานพื้นหลังแบบ always-on |
| ควรเลี่ยง | `anthropic/claude-opus-5` | $5.00 | $25.00 | ~$8.40 (ประมาณ) | โมเดลระดับ flagship; overspend สำหรับงาน compression |
แถวที่วัดจริงมาจากการรันที่จับไว้; แถว (ประมาณ) scale ตาม token mix เดียวกันด้วยราคา list ของแต่ละโมเดล
agentmemory จะพิมพ์คำเตือน runtime เมื่อ `OPENROUTER_MODEL` ตรงกับ pattern ของ tier premium ตั้งค่า `AGENTMEMORY_SUPPRESS_COST_WARNING=1` เพื่อปิดเสียงเตือนเมื่อคุณตัดสินใจเลือกแล้วอย่างมีข้อมูล
การแลกระหว่างคุณภาพกับต้นทุนสำหรับงาน memory: compression เป็นงาน summarization ที่มีเกณฑ์คุณภาพค่อนข้างหลวม (agent อ่าน summary กลับ ไม่ใช่ user) DeepSeek V4 Flash / V4 Pro / Qwen3-Coder อยู่ในระดับใกล้เคียง Sonnet มากสำหรับงานนี้ ในขณะที่ค่าใช้จ่ายถูกกว่า 10-70 เท่า เก็บโมเดลระดับ premium ไว้สำหรับคำค้นที่คุณอ่านเองตรง ๆ
ที่มา: [OpenRouter pricing for Claude Sonnet 5](https://openrouter.ai/anthropic/claude-sonnet-5), [DeepSeek V4 Flash](https://openrouter.ai/deepseek/deepseek-v4-flash-0731), [DeepSeek pricing notes](https://api-docs.deepseek.com/quick_start/pricing/)
### Multi-agent memory (`AGENT_ID` + `AGENTMEMORY_AGENT_SCOPE`)
ในระบบ multi-agent ที่หลาย role ใช้ agentmemory server เดียวกัน (architect / developer / reviewer / researcher / support-agent) `AGENT_ID` จะ tag การเขียนทุกครั้งด้วย role ที่ทำมัน `AGENTMEMORY_AGENT_SCOPE` ควบคุมว่า recall จะ filter ตาม tag นั้นหรือไม่
```env
TEAM_ID=company
USER_ID=engineering-team
AGENT_ID=architect
AGENTMEMORY_AGENT_SCOPE=isolated # optional; default "shared"
```
สองโหมด:
| Mode | Tag writes | Filter recall | เมื่อไหร่ที่ควรใช้ |
|------|------------|---------------|-------------|
| `shared` (default) | ใช่ | ไม่ | Context ข้าม agent พร้อม audit trail architect เห็นสิ่งที่ developer บันทึกได้ แต่ทุกแถวจะบันทึกว่าใครเป็นคนพูด |
| `isolated` | ใช่ | ใช่ | แยกกันอย่างเด็ดขาด architect จะไม่เห็น observation / memory / session ของ developer เลย |
สิ่งที่ถูก tag เมื่อตั้งค่า `AGENT_ID`: `Session.agentId`, `RawObservation.agentId`, `CompressedObservation.agentId`, `Memory.agentId` role จะไหลจาก `api::session::start` → `mem::observe` → `mem::compress` → KV
สิ่งที่ถูก filter ในโหมด isolated: `mem::smart-search`, `/agentmemory/memories`, `/agentmemory/observations`, `/agentmemory/sessions` แต่ละ endpoint รับ `?agentId=` เพื่อ override เป็นรายคำขอ และ `?agentId=*` เพื่อขอไม่ใช้ env scope เลย `/memories` ยังรับ `?includeOrphans=true` เพื่อแสดง memory ก่อนยุค AGENT_ID ที่มี `agentId` เป็น undefined
การ override ต่อคำขอที่ระดับ SDK / REST: ทุก mutating endpoint (`/session/start`, `/remember`) รับ field `agentId` ใน request body ที่มีสิทธิ์เหนือ env มีประโยชน์สำหรับ runtime ที่ route หลาย role ผ่าน server process เดียว MCP tool `memory_save` ก็ expose field `agentId` เดียวกัน standalone stdio server forward ทั้ง `agentId` และ `project` และ memory ที่ save ไว้จะพก `agentId` เข้าไปใน search index ด้วย ดังนั้น agent-scoped search จะครอบคลุม memory ไม่ใช่แค่ observation
เมื่อไม่ได้ตั้งค่า `AGENT_ID` memory จะไม่ถูก scope เลย (พฤติกรรมแบบเดิม ไม่มี tag ไม่มี filter)
### Ports
agentmemory + iii-engine bind พอร์ต 4 ตัวโดย default ถ้า restart ล้มเหลวด้วย `port in use` ตารางนี้จะบอกว่าต้องหา process ตัวไหน
| Port | Process | Purpose | Env override |
|------|---------|---------|--------------|
| `3111` | agentmemory | REST API + MCP HTTP + `/agentmemory/health` + `/agentmemory/livez` | `III_REST_PORT` |
| `3112` | iii-engine | Internal streams worker (consumed by agentmemory + viewer) | `III_STREAM_PORT` (preferred) or legacy `III_STREAMS_PORT` |
| `3113` | agentmemory | Real-time viewer (`http://localhost:3113`) | `III_VIEWER_PORT` or `AGENTMEMORY_VIEWER_URL` for the reported URL |
| `49134` | iii-engine | WebSocket; workers register here, OTel telemetry flows over it | `III_ENGINE_PORT` or `III_ENGINE_URL` |
`--port ` จะเปลี่ยน anchor ของ REST และ derive stream เป็น `N+1`, viewer เป็น `N+2`, และ engine WebSocket เป็น `N+46023` เฉพาะตอนที่พอร์ตหรือ URL แบบ explicit ที่ตรงกันด้านบนยังไม่ได้ตั้งค่าไว้ มันไม่ได้สร้าง lifecycle namespace ที่แยกต่างหาก ใช้ `--instance 1` สำหรับ daemon ตัวที่สอง มัน anchor ที่ 3211 ค่า default คือ `3211/3212/3213/49234` และได้ data และ lifecycle directory ชื่อ `instance-1` แยกต่างหาก instance 1 ถึง 50 เป็นไปตาม pattern เดียวกัน
engine ที่ pin ไว้เริ่มด้วย `--no-update-check` (ไม่ lookup update หรือ security-advisory กับ GitHub ตอน boot) และปิด anonymous usage telemetry ของ iii: agentmemory ตั้งค่า `III_TELEMETRY_ENABLED=false` ให้ engine ที่มันสั่งเริ่ม เว้นแต่คุณจะ export ตัวแปรนี้เอง และ compose file ที่ bundle มาก็ทำแบบเดียวกัน
การล้าง stale process เมื่อพอร์ตยัง bind อยู่หลังการรันที่ crash:
```bash
# macOS / Linux — find whatever is on each port and kill it
lsof -i :3111,3112,3113,49134
pkill -f agentmemory || true
pkill -f 'iii ' || true
# Windows
netstat -ano | findstr ":3111 :3112 :3113 :49134"
taskkill /F /PID
```
`agentmemory stop` จะเก็บ worker และ engine pidfile ให้สะอาดตอน shutdown แบบ native graceful ในโหมด Docker มันจะ flush native worker, หยุด engine container ที่ validate แล้วตัวที่ถูก และรักษาทั้ง container กับ mount `/data` ไว้สำหรับการ restart แบบไม่เสียข้อมูล การเริ่มครั้งถัดไปจะ validate และ resume container ตัวเดียวกันนั้น การ uninstall ที่รองรับ Docker ต้องใช้ `agentmemory remove --keep-data`: มันลบไฟล์ที่ agentmemory จัดการอยู่ร่วมกัน ขณะรักษา container ที่ validate แล้ว, mount ข้อมูลของมัน, และ lifecycle record ที่จำเป็นสำหรับการกู้คืน การลบข้อมูล Docker แบบทำลายล้างตั้งใจปล่อยให้ operator ทำเองหลัง backup CLI ยังปฏิเสธที่จะ adopt หรือส่ง signal ไปยัง Docker หรือ VM port holder (Docker backend, vpnkit, colima) ให้เป็น native engine เว้นแต่จะส่ง `--force` การล้างด้วยมือข้างบนมีไว้สำหรับกรณี post-crash ที่ไม่มี pidfile เหลืออยู่เลยเท่านั้น
### Config File
วางการตั้งค่า runtime ของ agentmemory ไว้ใน `~/.agentmemory/.env` แทนการ export ตัวแปรในทุก shell ถ้า viewer แสดง setup hint เช่น `export ANTHROPIC_API_KEY=...` ให้ copy มันลงในไฟล์นี้เป็น `ANTHROPIC_API_KEY=...` โดยไม่มี prefix `export` แล้ว restart agentmemory
Process environment variable ยังทำงานได้เหมือนเดิมและมีสิทธิ์เหนือค่าในไฟล์
บน Windows ไฟล์เดียวกันอยู่ที่ `%USERPROFILE%\.agentmemory\.env`:
```powershell
New-Item -ItemType Directory -Force $HOME\.agentmemory
notepad $HOME\.agentmemory\.env
```
หากต้องการทดสอบด้วย Claude Code Pro/Max subscription แทน API key ให้เปิดใช้งานอย่างชัดเจน:
```env
AGENTMEMORY_ALLOW_AGENT_SDK=true
AGENTMEMORY_AUTO_COMPRESS=true
```
การบีบอัด observation ด้วย LLM ต้องมีทั้งสองบรรทัดนี้: การเข้าถึง LLM provider (รวมถึง subscription fallback แบบชัดเจนนี้) และ `AGENTMEMORY_AUTO_COMPRESS=true` provider เพียงอย่างเดียวจะทิ้งเส้นทาง synthetic compression แบบ default ไว้เหมือนเดิม
Consolidation (graph node, lesson, crystal) เปิดอยู่โดย default ทุกครั้งที่มีการตั้งค่า LLM provider ไว้ ให้ปิดอย่างชัดเจนด้วย `CONSOLIDATION_ENABLED=false` ถ้าต้องการให้ทำงานโดยไม่มี LLM เลย graph extraction เป็น flag แยก:
```env
GRAPH_EXTRACTION_ENABLED=true
# CONSOLIDATION_ENABLED=false # opt out of auto-consolidation
```
### Environment Variables
สร้าง `~/.agentmemory/.env`:
```env
# LLM provider (pick one — default is the no-op provider: no LLM calls)
# ANTHROPIC_API_KEY=sk-ant-...
# ANTHROPIC_BASE_URL=... # Optional: Anthropic-compatible proxy / Azure
# GEMINI_API_KEY=...
# OPENROUTER_API_KEY=...
# MINIMAX_API_KEY=...
# OPENAI_API_KEY=*** # NOTE: this same key auto-activates BOTH the
# # OpenAI LLM provider (here) AND the OpenAI
# # embedding provider (further below). Set
# # OPENAI_API_KEY_FOR_LLM=false to scope it
# # to embeddings only.
# OPENAI_BASE_URL=https://api.openai.com # Optional: override for Azure / vLLM / LM Studio / proxies
# # Azure: https://.openai.azure.com/openai/deployments/
# # Auto-detected from `.openai.azure.com` hostname; uses
# # api-key header + api-version query param.
# OPENAI_API_VERSION=2024-08-01-preview # Optional: Azure api-version query param
# OPENAI_MODEL=gpt-5.6-luna # Optional: default model
# OPENAI_TIMEOUT_MS=60000 # Optional: OpenAI-scoped alias for the outbound fetch
# # timeout. Takes precedence over AGENTMEMORY_LLM_TIMEOUT_MS
# # for back-compat with v0.9.17. New configs should
# # prefer the global AGENTMEMORY_LLM_TIMEOUT_MS below.
# OPENAI_REASONING_EFFORT=none # Optional: "low" | "medium" | "high" | "none"
# # Honored only by OpenAI's reasoning models (o1, o3,
# # gpt-*-reasoning) and providers that mirror that
# # schema (Ollama Cloud thinking models). Standard
# # chat models reject this field with 400. Set to
# # "none" for thinking models that return reasoning
# # but no content.
# OPENAI_API_KEY_FOR_LLM=false # Optional: set to false to skip OpenAI auto-detection
# # for LLM (useful if you only want OpenAI for embeddings)
# Opt-in Claude-subscription fallback (spawns @anthropic-ai/claude-agent-sdk);
# leave OFF unless you understand the Stop-hook recursion risk:
# AGENTMEMORY_ALLOW_AGENT_SDK=true
# Embedding provider (BM25-only when unset; local is an explicit opt-in)
# EMBEDDING_PROVIDER=local
# VOYAGE_API_KEY=...
# OPENAI_API_KEY=sk-...
# OPENAI_BASE_URL=https://api.openai.com # Override for Azure / vLLM / LM Studio / proxies
# OPENAI_EMBEDDING_MODEL=text-embedding-3-small
# OPENAI_EMBEDDING_DIMENSIONS=1536 # Required when the model is not in the known-models table
# OPENAI_EMBEDDING_BASE_URL=https://... # Embeddings only; falls back to OPENAI_BASE_URL
# OPENAI_EMBEDDING_API_KEY=sk-... # Embeddings only; wins over OPENAI_API_KEY when set
# Outbound LLM / embedding timeout
# AGENTMEMORY_LLM_TIMEOUT_MS=60000 # Default: 60 000 ms (60 s). Applies to every
# raw-fetch provider (Gemini, OpenRouter, MiniMax,
# OpenAI LLM, OpenAI/Cohere/Voyage/OpenRouter
# embedding). For the OpenAI LLM path, the
# OpenAI-scoped OPENAI_TIMEOUT_MS alias (above)
# takes precedence when set, for back-compat
# with v0.9.17.
# Increase for slow networks or large batch calls;
# decrease to fail-fast on rate-limit holds.
# Search tuning
# BM25_WEIGHT=0.4
# VECTOR_WEIGHT=0.6
# TOKEN_BUDGET=2000
# Auth (generated into ~/.agentmemory/secret on first start when unset)
# AGENTMEMORY_SECRET=your-secret
# VIEWER_ALLOWED_ORIGINS=https://memory.example.com
# AGENTMEMORY_IMPORT_ROOT=~/projects
# Ports (defaults: 3111 API, 3113 viewer)
# III_REST_PORT=3111
# Engine usage telemetry (iii). Off unless you set it; true opts in.
# III_TELEMETRY_ENABLED=false
# Features
# AGENTMEMORY_AUTO_COMPRESS=false # OFF by default. Requires an LLM
# provider as well. When both are on,
# every PostToolUse hook calls your
# LLM provider to compress the
# observation — expect significant
# token spend on active sessions.
# AGENTMEMORY_SLOTS=false # OFF by default. Editable pinned
# memory slots — persona,
# user_preferences, tool_guidelines,
# project_context, guidance,
# pending_items, session_patterns,
# self_notes. Size-limited; agent
# edits via memory_slot_* tools.
# Pinned slots addressable for
# SessionStart injection.
# AGENTMEMORY_REFLECT=false # OFF by default. Requires SLOTS=on.
# Stop hook fires mem::slot-reflect:
# scans recent observations, auto-
# appends TODOs to pending_items,
# counts patterns in
# session_patterns, records touched
# files in project_context. Fire-
# and-forget; does not block.
# AGENTMEMORY_INJECT_CONTEXT=false # OFF by default. When on:
# - SessionStart may inject ~1-2K
# chars of project context into
# the first turn of each session
# (this is what actually reaches
# the model — Claude Code treats
# SessionStart stdout as context)
# - PreToolUse fires /agentmemory/enrich
# on every file-touching tool call
# (resource cleanup, not a token
# fix — PreToolUse stdout is debug
# log only per Claude Code docs)
# Observations are still captured via
# PostToolUse regardless of this flag.
# GRAPH_EXTRACTION_ENABLED=false
# AGENTMEMORY_LLM_NOTHINK=1 # Local reasoning models only: ask the
# model to skip its hidden thinking pass
# during graph extraction. Faster runs;
# relation quality can drop slightly.
# CONSOLIDATION_ENABLED=false # on by default when an LLM provider is configured
# LESSON_DECAY_ENABLED=true
# OBSIDIAN_AUTO_EXPORT=false
# AGENTMEMORY_EXPORT_ROOT=~/.agentmemory
# CLAUDE_MEMORY_BRIDGE=false
# SNAPSHOT_ENABLED=false
# Storage and durability
# AGENTMEMORY_STATE_BACKEND=file # file (default) or redis; see "Storage backend" below
# AGENTMEMORY_REDIS_URL=redis://localhost:6379 # Required with redis, plain redis:// only
# AGENTMEMORY_STATE_SAVE_INTERVAL_MS=2000 # How often the engine writes file state to disk.
# A hard kill loses at most this window.
# AGENTMEMORY_INDEX_SAVE_INTERVAL_MS=600000 # Minimum time between search index saves;
# shutdown and deletes still save at once.
# AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=true # One-time background trim of oversized graph
# provenance; false skips it
# Sessions
# AGENTMEMORY_SESSION_SWEEP_ENABLED=true # Hourly sweep marks sessions left active past
# the threshold as abandoned. Deletes nothing;
# new activity makes the session active again.
# AGENTMEMORY_SESSION_SWEEP_STALE_HOURS=24
# Capture filters (hooks)
# AGENTMEMORY_CAPTURE_ALLOW= # Comma or space list of tool names or globs;
# when set, only these tools are captured
# AGENTMEMORY_CAPTURE_DENY= # Extra names or globs to skip, added to the
# defaults: memory_*, toolsearch,
# listmcpresources, fetchmcpresource
# AGENTMEMORY_CAPTURE_OUTPUT_MAX=8000 # Max characters of tool output per observation
# AGENTMEMORY_PRE_COMPACT_BUDGET=1500 # Token budget for PreCompact context; 0 disables
# Audit log
# AGENTMEMORY_AUDIT_RETENTION_MONTHS=0 # Drop month scopes older than N months; 0 keeps all
# AGENTMEMORY_AUDIT_INDEX_PERSIST=false # 1 or true records index migration and cleanup
# rows (debugging only)
# Team
# TEAM_ID=
# USER_ID=
# TEAM_MODE=private
# Tool visibility: "all" (54 tools, default) or "core" (8 tools, lean)
# AGENTMEMORY_TOOLS=core
```
---

138 endpoint บนพอร์ต `3111` REST API จะ bind กับ `127.0.0.1` โดย default endpoint ที่ป้องกันไว้ต้องมี `Authorization: Bearer ` และ endpoint ของ mesh sync ต้องตั้งค่า `AGENTMEMORY_SECRET` ไว้อย่างชัดเจนทั้งสองฝั่ง
**Authentication เปิดอยู่โดย default** เมื่อไม่ได้ตั้งค่า `AGENTMEMORY_SECRET` (ทั้งใน shell หรือใน `~/.agentmemory/.env`) server จะสร้าง secret แบบสุ่มตอนเริ่มครั้งแรก และเก็บไว้ที่ `~/.agentmemory/secret` ด้วย mode `0600` client ที่ bundle มาทุกตัวจะอ่านมันจากที่นั่นเมื่อคุยกับ server ในเครื่อง: CLI, viewer, hook ใต้ `plugin/scripts`, MCP server และ shim `@agentmemory/mcp`, config ที่เขียนโดย `agentmemory connect`, และ integration ของ OpenCode, Pi, OpenClaw, Hermes และ filesystem-watcher ที่ bundle มา secret ที่เก็บไว้จะถูกส่งไปที่ loopback URL เท่านั้น (`localhost`, `127.0.0.0/8`, `::1`) `AGENTMEMORY_SECRET` แบบ explicit จะมีสิทธิ์เหนือเสมอ และ client แบบ remote ยังต้องตั้งค่ามันไว้ Docker และ entrypoint ของ [deploy](../deploy/) สร้างและ export secret ของตัวเองไว้แล้ว เรียก API ด้วยมือ:
```bash
curl -H "Authorization: Bearer $(cat ~/.agentmemory/secret)" http://localhost:3111/agentmemory/health
```
**กฎของคำขอสำหรับการเขียน** คำขอ `POST`, `PUT`, `PATCH` และ `DELETE` ไปยัง REST API และ viewer ต้องส่ง `Content-Type: application/json` (พารามิเตอร์ `charset` ใส่ได้) เมื่อมี body และ header `Origin` เมื่อมีอยู่ ต้องเป็น loopback origin ของพอร์ต REST หรือ viewer ที่ตั้งค่าไว้ หรืออยู่ใน `VIEWER_ALLOWED_ORIGINS` (คั่นด้วย comma เช่น `https://memory.example.com`) client ที่ไม่ส่ง header `Origin` เลย (CLI, hook, MCP, curl, server-to-server) ไม่ได้รับผลกระทบ viewer เองก็ยอมรับ origin ของตัวเองด้วย
**File paths** endpoint ที่อ่านหรือเขียนไฟล์ (`/compress-file`, `/replay/import-jsonl`, `/graph/import-graphify`) จะรับเฉพาะ path ที่อยู่ใต้ `~/.agentmemory`, instance data directory, หรือ directory ที่อยู่ใน `AGENTMEMORY_IMPORT_ROOT` (คั่นหลายตัวด้วย `:` หรือ `;` บน Windows) `/replay/import-jsonl` ยังรับ default ของมันคือ `~/.claude/projects` `/obsidian/export` อยู่ภายใน `AGENTMEMORY_EXPORT_ROOT` และ `/migrate` อยู่ภายใน `~/.agentmemory` Symlink จะถูก resolve ก่อนการตรวจสอบทุกครั้ง
**การลบข้อมูล secret** API key, bearer token, PEM private key block และ credential ที่ฝังอยู่ใน URL (`scheme://user:password@host`) จะถูก redact ก่อนจัดเก็บข้อความ บนทุกเส้นทางการเขียน: observation, remember, evolve, slot, lesson, action, sketch, signal, checkpoint, import, jsonl replay, mesh sync, team share, output ของ compression และ summary, crystal และ graph node
Key endpoints
| Method | Path | Description |
|--------|------|-------------|
| `GET` | `/agentmemory/health` | Health check (always public) |
| `GET` | `/agentmemory/status` | อะไรผิดพลาดและวิธีแก้ (HTML สำหรับ browser, JSON กรณีอื่น) |
| `GET` | `/agentmemory/viewer/snapshot` | ทุกอย่างที่ viewer แสดง ในคำตอบเดียว |
| `POST` | `/agentmemory/session/start` | เริ่มเซสชัน + รับ context |
| `POST` | `/agentmemory/session/end` | จบเซสชัน |
| `POST` | `/agentmemory/observe` | บันทึก observation (ดู capture delivery ด้านล่าง) |
| `GET` | `/agentmemory/capture` | Capture inbox, dead letter และ offline spool |
| `POST` | `/agentmemory/capture/retry` | Retry dead-letter capture |
| `POST` | `/agentmemory/capture/drain` | ส่ง offline spool ในเครื่องทันที |
| `POST` | `/agentmemory/smart-search` | ค้นหาแบบ hybrid |
| `POST` | `/agentmemory/context` | สร้าง context |
| `POST` | `/agentmemory/remember` | บันทึกเข้าหน่วยความจำระยะยาว |
| `POST` | `/agentmemory/forget` | ลบ observation |
| `POST` | `/agentmemory/enrich` | context ของไฟล์ + memory + bug |
| `GET` | `/agentmemory/profile` | โปรไฟล์ project |
| `GET` | `/agentmemory/export` | export ข้อมูลทั้งหมด |
| `POST` | `/agentmemory/import` | import จาก JSON |
| `POST` | `/agentmemory/graph/query` | คำค้นหา knowledge graph |
| `POST` | `/agentmemory/graph/compact` | ตัด graph provenance ที่ใหญ่เกินไป |
| `POST` | `/agentmemory/team/share` | แชร์กับทีม |
| `GET` | `/agentmemory/audit` | Audit trail |
รายการ endpoint แบบเต็ม: [`src/triggers/api.ts`](../src/triggers/api.ts)
**Capture delivery** hook จะส่งแต่ละ observation ไปที่ `POST /agentmemory/observe` ครั้งเดียว พร้อม `eventId` มันคือ id ของ host เองสำหรับคำขอนั้นเมื่อ payload มี id อยู่แล้ว (เช่น `tool_use_id` ของ Claude Code) ไม่อย่างนั้นก็เป็น hash ของ session, hook type, tool name, input, output และ host timestamp server จะเขียน event เข้า capture inbox ใน state store, เก็บ observation, แล้วลบรายการ inbox ออก status code จะบอกว่าเกิดอะไรขึ้น:
| Status | `status` field | Meaning |
|---|---|---|
| `201` | `accepted` | บันทึกแล้ว `observationId` คือ observation ตัวใหม่ |
| `202` | `accepted` (`state: "retrying"`) | รับแล้ว แต่การบันทึกล้มเหลว server จะ retry มัน รวมถึงหลัง restart ด้วย |
| `200` | `duplicate` | `eventId` นี้ถูกรับไปแล้ว `observationId` คือ observation ที่มีอยู่แล้ว ไม่มีอะไรถูกบันทึกใหม่ |
| `400` / `422` | `rejected` | payload ไม่ถูกต้อง หรือการบันทึกล้มเหลวแบบถาวร (event จะถูกเก็บไว้เป็น dead letter) |
| `503` | `rejected` (`retryable: true`) | inbox เต็ม (`AGENTMEMORY_CAPTURE_INBOX_MAX`) hook จะ spool event ไว้และส่งทีหลัง |
Event ที่ล้มเหลวจะถูก retry ทุก `AGENTMEMORY_CAPTURE_RETRY_INTERVAL_MS` (10 วินาที) ด้วย backoff แบบทวีคูณ สูงสุด `AGENTMEMORY_CAPTURE_MAX_ATTEMPTS` (5 ครั้ง) Event ที่ยังล้มเหลวอยู่จะค้างอยู่ใน inbox เป็น dead letter ถูก list ไว้บน `/agentmemory/status` และหน้า Health ของ viewer และ retry ได้ด้วย `POST /agentmemory/capture/retry` (`{"eventId": "..."}` หรือ `{"all": true}`) event id ที่ถูกรับแล้วจะถูกจำไว้เป็นเวลา `AGENTMEMORY_CAPTURE_DEDUP_HOURS` (168 ชั่วโมง สูงสุด `AGENTMEMORY_CAPTURE_EVENTS_MAX` id) ดังนั้น hook ที่ replay หลัง timeout หรือ restart จะถูกบันทึกครั้งเดียว ในขณะที่ tool call สองครั้งที่แยกกันโดยมี host id เป็นของตัวเองจะถูกบันทึกสองครั้งแม้เนื้อหาเหมือนกันทุกตัวอักษร เมื่อ observation ถูกลบ (forget, ลบเซสชัน, eviction, auto-forget หรือ import ที่แทนที่ store) event ของมันจะถูก mark ว่าลบแล้วก่อนที่ observation จะถูกลบจริง ดังนั้นการ replay event นั้นในช่วงเวลาเดียวกันจะถูกตอบว่าเป็น duplicate และไม่บันทึกอะไรเลย state store จะเขียนลงดิสก์ทุก 2 วินาที ดังนั้น event ที่ตอบแล้วอาจยังอยู่ในหน่วยความจำเพียงชั่วครู่ เพื่อครอบคลุมกรณีนี้ คำตอบ `2xx` ทุกตัวจะพก `bootId` ของ server (ใหม่ทุกครั้งที่เริ่ม), `acceptedAt` และ `durableAfterMs` (save interval บวก 1.5 วินาทีบน file store, 1.5 วินาทีบน redis ที่ persistence เป็นการตั้งค่าของ operator) hook จะเก็บ event ไว้ใน spool ในเครื่องจนกว่า window นั้นจะผ่านไป แล้วลบมันในคำขอครั้งถัดไปโดยไม่ต้องมีคำขอเพิ่ม ถ้า `bootId` เปลี่ยนไปตอนนั้น แสดงว่า server restart แล้ว ดังนั้น hook จะส่ง event ซ้ำด้วย `eventId` เดิม event ที่ถึงดิสก์ไปแล้วจะไม่ถูกบันทึกซ้ำสองครั้ง server เองก็จะส่ง event แบบนี้ตอนเริ่มและทุก retry interval ด้วย ดังนั้น restart จะไม่เสียอะไรเลยแม้ไม่มี hook รันต่อจากนั้น hook เก่าจะไม่สนใจ field เพิ่มเติมเหล่านี้ และ hook ใหม่ที่คุยกับ server เก่าจะทิ้ง event บน `2xx` เหมือนเดิม
เมื่อ server ล้ม ไม่ตอบทันเวลา หรือคืน 5xx hook จะต่อ observation เข้าไปที่ spool file ในเครื่อง `/capture-spool/-.jsonl` (override folder ด้วย `AGENTMEMORY_CAPTURE_SPOOL_DIR`) ไฟล์นี้เป็นของ user คุณเท่านั้น (mode 600) secret ถูก redact แบบเดียวกับที่ server redact มัน มันเก็บได้สูงสุด `AGENTMEMORY_CAPTURE_SPOOL_MAX_BYTES` (5 MiB) และ drop รายการที่เก่ากว่า `AGENTMEMORY_CAPTURE_SPOOL_MAX_AGE_HOURS` (168 ชั่วโมง) เมื่อเต็ม รายการใหม่จะถูก drop และนับไว้ และ `/agentmemory/status` จะรายงานมัน hook ยัง exit 0 ภายใน time limit ของมันเสมอ และไม่เพิ่มคำขอใด ๆ เมื่อ server ปกติดี spool จะถูกส่งตอนเริ่มครั้งถัดไป และโดย hook ตัวแรกที่เชื่อมต่อกับ server ได้อีกครั้ง ใน background process เพื่อไม่ให้ agent ต้องรอ event id ทำให้สิ่งนี้ปลอดภัย: observation ที่ถึงแล้วก่อน timeout จะไม่ถูกบันทึกซ้ำสองครั้ง `npx @agentmemory/agentmemory capture` จะแสดง spool และ server inbox, `--drain` จะส่ง spool ทันที, และ `GET /agentmemory/capture` คืนค่าแบบเดียวกันเป็น JSON ตั้งค่า `AGENTMEMORY_CAPTURE_SPOOL=false` เพื่อปิด spool
**การ compact graph provenance** node และ edge ของ knowledge graph แต่ละตัวเก็บ id ของ observation ล่าสุด 32 ตัวที่มันมาจาก store ที่เขียนไว้ก่อนมี cap นี้อาจมี id นับพันต่อ hot node หนึ่งตัว ซึ่งทำให้ graph search และ viewer ช้าลงหรือทำให้ worker ล้ม agentmemory แก้ปัญหานี้ให้เอง: ในการเริ่มครั้งแรกหลัง upgrade มันจะตัด node, edge, superseded edge (temporal graph history) และ cached snapshot ทุกตัวให้เหลือตาม cap ในพื้นหลัง เป็น slice เล็ก ๆ พร้อมหยุดพักระหว่างกัน เพื่อให้ search, capture, และ viewer ทำงานต่อไปได้ มันจะบันทึกความคืบหน้า resume ได้หลัง restart และไม่รันอีกเมื่อเสร็จแล้ว `/agentmemory/status` และหน้า Health ของ viewer จะแสดงมันเป็น pending, running (พร้อม scope และตำแหน่งปัจจุบัน), done หรือ failed ตั้งค่า `AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=false` เพื่อปิดมัน
หากต้องการรันด้วยมือ เรียก `POST /agentmemory/graph/compact` มันจะไล่ตาม name และ edge-key index แทนการ list node และ edge ทุกตัว และปลอดภัยที่จะรันซ้ำ เมื่อมันตัด id ออก มันจะเขียน audit entry แบบ `graph_compact`
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{}'
```
บน store ขนาดใหญ่ หรือเมื่อคำขอคืน 504 ให้รันเป็น slice ส่ง `scope` (`nodes`, `edges` หรือ `history`), `offset` และ `limit` แล้วเรียกซ้ำด้วย `nextOffset` ที่คืนมาจนกว่าจะเป็น `null` ทำแบบนี้สำหรับ `nodes`, `edges` และ `history` แล้วปิดท้ายด้วยการเรียก `{"scope":"snapshot"}` หนึ่งครั้ง เพราะการรันแบบ slice จะไม่แตะ cached snapshot
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"nodes","offset":0,"limit":200}'
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"snapshot"}'
```
---

```bash
npm run dev # Hot reload
npm run build # Production build
npm test # 2,500+ tests
npm run test:integration # API tests (requires running services)
```
**ข้อกำหนดเบื้องต้น:** Node.js >= 20 พร้อม npm/npx; [iii-engine](https://iii.dev/docs) v0.22.1 หรือ Docker การติดตั้ง engine แบบอัตโนมัติบน macOS/Linux ยังต้องมี `curl`, POSIX `sh`, และ `tar` ด้วย; native Windows ใช้ `iii.exe` ที่ pin ไว้แบบ manual, WSL2, หรือ Docker Desktop

[Apache-2.0](../LICENSE)


