Votre agent de codage se souvient de tout. Fini de tout réexpliquer.
Construit sur iii engine
Mémoire persistante pour Claude Code, GitHub Copilot CLI, Cursor, Gemini CLI, Codex CLI, Hermes, OpenClaw, pi, OpenCode et tout client MCP.
Le gist étend le motif LLM Wiki de Karpathy avec scoring de confiance, cycle de vie, graphes de connaissances et recherche hybride : agentmemory en est l'implémentation.
---
## Installation
Prérequis :
- Node.js 20 ou plus récent avec npm et npx (`node -v`, `npm -v` et `npx -v`).
- L'installation automatique de iii-engine sur macOS/Linux nécessite aussi `curl`, un `sh` POSIX et `tar`. Les images minimales comme `node:20-slim` peuvent ne pas les inclure.
- Windows natif requiert l'installation manuelle de l'`iii.exe` épinglé à la version iii-engine v0.22.1. WSL2 ou Docker Desktop sont les autres chemins pris en charge.
Commande canonique d'installation initiale :
```bash
npx -y @agentmemory/agentmemory@latest
```
La première exécution est un setup interactif : choisissez les agents à câbler (Claude Code, Cursor, Codex, Gemini CLI, OpenCode, ...), choisissez un fournisseur LLM ou restez sans clé, et il amorce la config, démarre le serveur de mémoire ainsi que son moteur iii épinglé, et propose une installation globale pour que la simple commande `agentmemory` fonctionne ensuite partout. `-y` accepte l'invite de paquet de npx et `@latest` évite une version mise en cache obsolète. Un fournisseur rend les fonctionnalités LLM disponibles, mais la compression d'observation rédigée par LLM ne démarre que lorsque `AGENTMEMORY_AUTO_COMPRESS=true` est aussi défini.
Le mode sans clé désactive les embeddings vectoriels. `memory_recall` (le chemin `mem::search`) utilise BM25, tandis que `memory_smart_search` peut aussi fusionner des correspondances de graphe structurel quand des données de graphe existent déjà. Pour un recall sémantique gratuit sur l'appareil, définissez `EMBEDDING_PROVIDER=local` dans `~/.agentmemory/.env` et redémarrez. La première requête d'embedding télécharge `Xenova/all-MiniLM-L6-v2` ; l'inférence tourne ensuite localement après ce téléchargement initial du modèle.
Le runtime local utilise quatre ports : `3111` pour REST/MCP HTTP, `3112` pour les streams iii, `3113` pour le visualiseur et `49134` pour le WebSocket du worker iii. L'état persistant iii vit dans `~/Library/Application Support/agentmemory` sur macOS, `$XDG_DATA_HOME/agentmemory` ou `~/.local/share/agentmemory` sur Linux, et `%APPDATA%\agentmemory` sur Windows. Utilisez `--data-dir ` ou `AGENTMEMORY_DATA_DIR` pour le remplacer, et réutilisez la même valeur à chaque redémarrage. Pour la compatibilité ascendante, un `./data/state_store.db` ou `./data/iii-config.yaml` existant prime sur le défaut de la plateforme pour l'instance 0 ; un flag ou une variable d'environnement explicite l'emporte toujours.
Prouvez ensuite que le recall fonctionne et donnez ses skills à votre agent :
```bash
npx -y @agentmemory/agentmemory@latest demo # seed sample sessions + exercise recall
npx skills add rohitg00/agentmemory -y # 17 native skills so your agent knows when to reach for memory
```
Les recherches par mot-clé devraient trouver des résultats en mode sans clé par défaut via BM25. La requête `database performance optimization` de la démo est volontairement sémantique et peut renvoyer zéro résultat jusqu'à ce qu'un fournisseur d'embedding soit configuré.
Vous préférez laisser un agent de codage tout faire ? Confiez-lui une seule instruction :
> Retrieve and follow the instructions at: https://raw.githubusercontent.com/rohitg00/agentmemory/main/INSTALL_FOR_AGENTS.md
Câblez d'autres agents à tout moment avec `agentmemory connect ` — 20 adaptateurs listés dans [Compatible avec tous les agents](#works-with-every-agent). Référence complète des commandes dans [Démarrage rapide](#quick-start).
Windows
Le chemin le plus rapide est WSL2. La configuration native du moteur sous Windows nécessite de télécharger le ZIP v0.22.1 épinglé et d'extraire `iii.exe` manuellement ; la CLI ne l'extrait pas automatiquement. Docker Desktop est aussi pris en charge. Voir les [notes Windows](#windows) pour le pas-à-pas.
Installation globale / EACCES
```bash
npm install -g @agentmemory/agentmemory@latest
```
La commande npx ci-dessus reste le chemin canonique d'installation initiale et évite les problèmes de permission liés au préfixe global.
npx sert une ancienne version
npx met en cache par version. Forcez la dernière avec `npx -y @agentmemory/agentmemory@latest`, ou videz le cache une fois avec `rm -rf ~/.npm/_npx` (macOS/Linux ; sur Windows, supprimez `%LOCALAPPDATA%\npm-cache\_npx`).
Vous faites déjà tourner votre propre moteur iii
agentmemory épingle iii-engine v0.22.1 et ne s'attachera pas à une autre version (le worker ne peut pas parler le protocole d'un autre moteur). Arrêtez l'autre moteur, puis lancez `npx -y @agentmemory/agentmemory@latest`. Il installe et exécute le v0.22.1 épinglé dans `~/.agentmemory/bin`, sans toucher à votre propre `iii`.
---
agentmemory fonctionne avec tout agent qui prend en charge les hooks, MCP ou l'API REST. Tous les agents partagent le même serveur de mémoire.
Claude Code plugin natif + 12 hooks + MCP
Codex CLI plugin natif + 6 hooks + MCP
GitHub Copilot CLI MCP + hooks/skills du plugin
Cursor plugin natif + 7 hooks + MCP
OpenCode plugin de capture + MCP
Devin 6 hooks + skills + MCP
OpenClaw plugin natif + MCP
Hermes plugin natif + MCP
pi plugin natif + MCP
OpenHuman backend natif via le trait Memory
Gemini CLI serveur MCP
Antigravity MCP + hooks
Claude Desktop serveur MCP
Warp connect + MCP + skills
Zed serveur MCP
Cline serveur MCP
Continue serveur MCP
Droid serveur MCP
Kiro serveur MCP
Qwen Code serveur MCP
DeepSeek Harness serveur MCP
Roo Code serveur MCP
Kilo Code serveur MCP
Goose serveur MCP
Aider API REST
Fonctionne avec n'importe quel agent qui parle MCP ou HTTP. Un seul serveur, des mémoires partagées entre tous.
---
Vous expliquez la même architecture à chaque session. Vous redécouvrez les mêmes bugs. Vous réenseignez les mêmes préférences. La mémoire intégrée (CLAUDE.md, .cursorrules) plafonne à 200 lignes et devient obsolète. agentmemory règle ce problème. Il capture silencieusement ce que fait votre agent, le compresse dans une mémoire interrogeable, puis injecte le bon contexte au démarrage de la session suivante. Une seule commande. Fonctionne entre agents.
**Ce qui change :** Session 1, vous mettez en place l'authentification JWT. Session 2, vous demandez une limitation de débit. L'agent sait déjà que votre authentification utilise le middleware jose dans `src/middleware/auth.ts`, que vos tests couvrent la validation des tokens, et que vous avez choisi jose plutôt que jsonwebtoken pour la compatibilité Edge, sans réexplication ni copier-coller.
```bash
npx -y @agentmemory/agentmemory@latest
```
Par défaut, agentmemory stocke l'état iii-engine hors du dépôt depuis lequel vous le lancez : `~/Library/Application Support/agentmemory` sur macOS, `$XDG_DATA_HOME/agentmemory` ou `~/.local/share/agentmemory` sur Linux, et `%APPDATA%\agentmemory` sur Windows. Un `./data/state_store.db` ou `./data/iii-config.yaml` legacy existant est réutilisé pour l'instance 0 avant ce défaut de plateforme. Pour choisir un emplacement explicitement, passez `--data-dir ` ou définissez `AGENTMEMORY_DATA_DIR` ; l'un ou l'autre réglage explicite prime sur la découverte legacy :
```bash
npx -y @agentmemory/agentmemory@latest --data-dir ~/.agentmemory-projects/main
AGENTMEMORY_DATA_DIR=~/.agentmemory-projects/main npx -y @agentmemory/agentmemory@latest
```
Les lancements natifs et Docker utilisent ce même répertoire hôte résolu ; Docker le bind-mount sur `/data`. `--instance 1` ajoute `instance-1` au répertoire résolu et sélectionne le quartet de ports par défaut séparé `3211/3212/3213/49234`.
Notes de la dernière version : [CHANGELOG.md](../CHANGELOG.md).
---
### Précision de récupération
**coding-agent-life-v1** (corpus interne, reproductible en sandbox)
| Adaptateur | P@5 | R@5 | Taux de hit top-5 | Latence p50 |
|---|---|---|---|---|
| **agentmemory hybrid** | **0.240** | **1.000** | **15 / 15** | 14 ms |
| Référence grep | 0.227 | 0.967 | 15 / 15 | 0 ms |
100% de taux de hit top-5 au **plafond mathématique du P@5** pour ce corpus (0.240, voir le scorecard). L'hybride récupère chaque session gold ; grep manque 1 des 2 gold sur la requête temporelle multi-session. Le gain porte sur **recall + temporel**, pas sur la précision agrégée. Ce benchmark est petit et pauvre en gold ; le LongMemEval-S plus grand ci-dessous différencie mieux. Ventilation complète par type + note de correction : [`docs/benchmarks/2026-05-20-coding-agent-life-v1.md`](../docs/benchmarks/2026-05-20-coding-agent-life-v1.md).
**LongMemEval-S** (ICLR 2025, 500 questions)
| Système | R@5 | R@10 | MRR |
|---|---|---|---|
| **agentmemory** | **95.2%** | **98.6%** | **88.2%** |
| Repli BM25 seul | 86.2% | 94.6% | 71.5% |
> Modèle d'embedding : `all-MiniLM-L6-v2` (local, gratuit, sans clé d'API). Rapports complets : [`benchmark/LONGMEMEVAL.md`](../benchmark/LONGMEMEVAL.md), [`benchmark/QUALITY.md`](../benchmark/QUALITY.md), [`benchmark/SCALE.md`](../benchmark/SCALE.md). Comparaison avec les concurrents : [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md) couvrant agentmemory vs mem0, Letta, Khoj, supermemory, TencentDB Agent Memory, MemPalace, Zep/Graphiti, Cognee, Hippo.
**Reproduire localement :** [`eval/README.md`](../eval/README.md), un harnais à adaptateurs pluggables pour LongMemEval `_s` (public, 500 questions) + `coding-agent-life-v1` (corpus interne de 15 sessions). Les adaptateurs grep / vectoriel / agentmemory sont notés côte à côte, sortie NDJSON, scorecards publiés dans [`docs/benchmarks/`](../docs/benchmarks/).
**À associer à [codegraph](https://github.com/colbymchenry/codegraph), [Understand Anything](https://github.com/Lum1104/Understand-Anything) et [Graphify](https://github.com/safishamsi/graphify).** Indexation de graphe de code, pipelines de build multi-agents et graphes de connaissances plus larges sur docs / PDF / images / vidéos. agentmemory mémorise le travail ; ces trois projets éclairent le reste de la couche de contexte. Recettes + tableau de routage des questions : [`docs/recipes/pairings.md`](../docs/recipes/pairings.md).
---
agentmemory
mem0 (63K ⭐)
Letta / MemGPT (24K ⭐)
Khoj (36K ⭐)
supermemory (29K ⭐)
TencentDB Agent Memory (22K ⭐)
MemPalace (54K ⭐)
oracleagentmemory
Hippo
Intégré (CLAUDE.md)
Type
Moteur de mémoire + serveur MCP
API de couche mémoire
Runtime d'agent complet
IA personnelle
API mémoire + app
Hub de mémoire d'équipe (proxy LLM)
Mémoire vectorielle (OSS)
Moteur de mémoire (Oracle DB)
Système de mémoire
Fichier statique
R@5 de récupération
95.2%
68.5% (LoCoMo)
83.2% (LoCoMo)
N/A
Auto-déclaré
PersonaMem 76% (auto-déclaré)
~96.6% (auto-déclaré)
94.4% (auto-déclaré)
N/A
N/A (grep)
Capture automatique
12 hooks (zéro effort manuel)
Appels add() manuels
L'agent s'auto-édite
Manuelle
Extraction côté API
Interception par proxy (bascule de base-URL)
Manuelle
Extraction API
Manuelle
Édition manuelle
Recherche
BM25 + Vectoriel + Graphe (fusion RRF)
Vectoriel + Graphe
Vectoriel (archival)
Sémantique
Vectoriel + RAG
4 types d'assets (Chat / Skill / Wiki / CodeGraph)
Vectoriel uniquement
Vectoriel + sémantique
Pondérée par décroissance
Charge tout en contexte
Multi-agents
MCP + REST + leases + signaux
API (sans coordination)
Uniquement dans le runtime Letta
Non
Non
Rôles d'équipe + assets partagés
Non
Scopé seulement
Partagé multi-agents
Fichiers par agent
Verrouillage framework
Aucun (tout client MCP)
Aucun
Élevé (Letta obligatoire)
Autonome
Aucun
Le proxy s'interpose devant chaque appel de modèle
Aucun
Oracle Database
Aucun
Format par agent
Dépendances externes
Aucune (SQLite + iii-engine)
Qdrant / pgvector
Postgres + base vectorielle
Multiples
Cloud managé
Stack Docker (Core + Hub + Proxy)
Store vectoriel
Oracle AI Database
Aucune
Aucune
Cycle de vie mémoire
Consolidation à 4 niveaux + décroissance + oubli automatique
Extraction passive
Géré par l'agent
Manuel
Oubli automatique
Revue manuelle ; auto-routage en cours
Aucun
Non précisé
Décroissance + consolidation
Nettoyage manuel
Efficacité des tokens
~1 900 tokens/session (10 $/an)
Varie selon l'intégration
Mémoire centrale dans le contexte
Varie
Tarification cloud
Non précisé
Pas de budget de tokens
Adossé à un LLM (variable)
Varie
22K+ tokens à 240 observations
Visualiseur temps réel
Oui (port 3113)
Dashboard cloud
Dashboard cloud
UI web
Dashboard cloud
UI web du Hub
Non
Non
Non
Non
Auto-hébergé
Oui (par défaut)
Optionnel
Optionnel
Oui
Non (cloud uniquement)
Oui (Docker)
Oui
Oui (Oracle DB)
Oui
Oui
Note sur le benchmark : seul le R@5 d'agentmemory est notre propre résultat mesuré (LongMemEval-S, reproductible depuis benchmark/COMPARISON.md). Les chiffres de mem0 et Letta sont leurs résultats LoCoMo publiés (un jeu de données différent) ; les chiffres de MemPalace, supermemory, TencentDB (PersonaMem) et oracleagentmemory sont des annonces auto-déclarées par ces éditeurs, que nous n'avons pas reproduites indépendamment (le run d'oracleagentmemory utilisait GPT-5.5 contre une Oracle AI Database). Présentés côte à côte à titre indicatif seulement, pas comme un comparatif direct sur des données identiques. Les comptages d'étoiles sont approximatifs et évoluent avec le temps.
**Nouveaux arrivants** à connaître, comparés en détail dans [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md) :
| Système | ⭐ | Angle |
|--------|---|-------|
| Zep / Graphiti | 30K | Graphe de connaissances temporel ; meilleurs résultats publiés sur les requêtes temporelles (LongMemEval 63.8%), mais le graphe se construit de façon asynchrone donc les faits récents peuvent accuser un retard |
| Cognee | 30K | Ingestion document-vers-graphe-de-connaissances, Python uniquement, conçu pour l'extraction d'entités structurées plutôt que pour la capture de sessions |
Aucun d'entre eux ne capture automatiquement depuis des hooks d'agent de codage, ne fournit de visualiseur local-first, ni ne fonctionne sans clé — la combinaison autour de laquelle agentmemory est construit.
---
Compatibilité : cette version cible `iii-sdk` 0.22.1 et épingle iii-engine v0.22.1.
### Essayez-le en 30 secondes
```bash
# Terminal 1: start the server
npx -y @agentmemory/agentmemory@latest
# Terminal 2: seed sample data and see recall in action
npx -y @agentmemory/agentmemory@latest demo
```
`demo` amorce 3 sessions réalistes (authentification JWT, correction de requête N+1, limitation de débit) et exécute des recherches contre elles. Les installations sans clé désactivent les vecteurs, donc les requêtes par mot-clé `mem::search` devraient trouver des résultats via BM25 tandis que `database performance optimization` peut renvoyer zéro résultat. `smart-search` peut en plus renvoyer des correspondances de graphe structurel quand des données de graphe existent. Pour que la requête sémantique trouve la correction N+1 via les vecteurs, définissez `EMBEDDING_PROVIDER=local`, redémarrez, et laissez le premier téléchargement de modèle se terminer.
Ouvrez `http://localhost:3113` pour regarder la mémoire se construire en direct.
### Valider une installation fraîche et la persistance au redémarrage
Avec le serveur en cours d'exécution, validez REST, la santé, le visualiseur et le statut du runtime adossé à iii :
```bash
curl -fsS http://localhost:3111/agentmemory/livez
curl -fsS http://localhost:3111/agentmemory/health
curl -fsS -o /dev/null http://localhost:3113/
npx -y @agentmemory/agentmemory@latest status
```
Le panneau de disponibilité au démarrage couvre les quatre ports : REST/MCP HTTP sur 3111, streams iii sur 3112, le visualiseur sur 3113, et le WebSocket du worker iii sur 49134. `status` confirme la santé d'agentmemory et le mode fournisseur/embedding actif. Sauvegardez une sonde et confirmez qu'elle est trouvable :
```bash
curl -fsS -X POST http://localhost:3111/agentmemory/remember \
-H 'Content-Type: application/json' \
-d '{"content":"agentmemory restart persistence probe","concepts":["install-check"]}'
curl -fsS -X POST http://localhost:3111/agentmemory/smart-search \
-H 'Content-Type: application/json' \
-d '{"query":"restart persistence probe","limit":5}'
```
Lancez ensuite `npx -y @agentmemory/agentmemory@latest stop`, redémarrez la commande canonique dans le Terminal 1, attendez `/agentmemory/livez`, et répétez la recherche. La sonde doit toujours être retournée. Si vous avez sélectionné un `--data-dir` personnalisé, passez le même répertoire au redémarrage.
### Commandes du quotidien
L'installation et le setup se trouvent dans [Installation](#install) ci-dessus (la première exécution vous guide). Au quotidien :
```bash
agentmemory # start the server
agentmemory stop # stop it cleanly
agentmemory connect # wire another agent
agentmemory doctor # interactive diagnostics + fix prompts
agentmemory remove # uninstall everything we created
```
### Replay de session
Chaque session enregistrée par agentmemory peut être rejouée. Ouvrez le visualiseur, choisissez l'onglet **Replay**, et parcourez la timeline : prompts, appels d'outils, résultats d'outils et réponses s'affichent comme des événements distincts avec lecture/pause, contrôle de vitesse (0.5x à 4x) et raccourcis clavier (espace pour basculer, flèches pour avancer pas à pas).
Pour importer d'anciens transcripts JSONL de Claude Code :
```bash
# Import everything under the default ~/.claude/projects
npx -y @agentmemory/agentmemory@latest import-jsonl
# Or import a single file
npx -y @agentmemory/agentmemory@latest import-jsonl ~/.claude/projects/-my-project/abc123.jsonl
```
Les sessions importées apparaissent dans le sélecteur Replay aux côtés des sessions natives. Sous le capot, chaque entrée passe par les fonctions iii `mem::replay::load`, `mem::replay::sessions` et `mem::replay::import-jsonl`, sans serveur annexe. Chaque transcript importé est indexé pour la recherche, tamponné avec le canal d'origine `import`, et exploité pour produire un cristal de session et des lessons.
> **Important si vous comptez sur `import-jsonl` comme chemin de capture principal :** le `cleanupPeriodDays` de Claude Code (dans `~/.claude/settings.json`, défaut **30**) supprime automatiquement les transcripts JSONL plus anciens que cette fenêtre depuis `~/.claude/projects/`. Si vous installez agentmemory fraîchement sur un historique Claude Code de plusieurs mois, tout ce qui a plus de 30 jours a déjà disparu avant le premier import. Soit vous lancez `import-jsonl` via un cron, soit vous augmentez `cleanupPeriodDays`, soit vous câblez les hooks de capture automatique (le chemin d'installation par défaut du plugin) pour que chaque tour atterrisse dans agentmemory tant que la session est active, et le nettoyage JSONL cesse d'avoir de l'importance.
### Mise à niveau / Maintenance
Utilisez la commande de maintenance quand vous souhaitez intentionnellement mettre à jour votre runtime local :
```bash
npx -y @agentmemory/agentmemory@latest upgrade
```
Avertissement : cette commande modifie l'espace de travail/runtime actuel. Elle peut mettre à jour les dépendances JavaScript et récupérer l'image Docker épinglée `iiidev/iii:0.22.1`. Elle n'installe jamais un moteur iii non épinglé ou plus récent.
Les détails d'implémentation se trouvent dans `src/cli.ts` (voir `runUpgrade` autour de la zone `src/cli.ts:544-595`).
### Claude Code (un bloc, à coller)
```text
Install agentmemory: run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server and its pinned iii engine. Then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory` — the plugin registers all 12 hooks, 17 skills, AND auto-wires the `@agentmemory/mcp` stdio server via its `.mcp.json`, so you get 54 MCP tools (memory_smart_search, memory_save, memory_sessions, memory_governance_delete, etc.) without any extra config step. Verify with `curl http://localhost:3111/agentmemory/health`. The real-time viewer is at http://localhost:3113. Keyless mode disables vectors: `memory_recall` uses BM25, and `memory_smart_search` can also use existing structural graph data. Set `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` and restart to opt into on-device semantic recall.
```
#### Claude Code sans l'installation du plugin (chemin MCP-standalone)
Si vous câblez le serveur MCP d'agentmemory via `~/.claude.json` directement plutôt qu'en utilisant `/plugin install`, Claude Code ne résout jamais `${CLAUDE_PLUGIN_ROOT}` et vous devez pointer les scripts de hooks vers des chemins absolus dans `~/.claude/settings.json`. Ces chemins embarquent typiquement la version d'agentmemory (par ex. `~/.codex/plugins/cache/agentmemory/agentmemory/0.9.22/scripts/…`), donc la prochaine mise à niveau casse silencieusement chaque hook.
Solution de contournement :
```bash
agentmemory connect claude-code --with-hooks
```
Cela fusionne les mêmes commandes de hooks dans `~/.claude/settings.json` avec des chemins absolus résolus vers le répertoire `plugin/` embarqué dans le paquet `@agentmemory/agentmemory` actuellement installé. Relancez la commande après chaque mise à niveau d'agentmemory pour rafraîchir les chemins. Les entrées utilisateur dans le même fichier sont préservées ; seules les entrées agentmemory précédentes sont remplacées. Le chemin `/plugin install` reste l'approche recommandée.
Pour des déploiements distants ou protégés, lancez Claude Code avec `AGENTMEMORY_URL` et `AGENTMEMORY_SECRET` définis. Le plugin transmet les deux valeurs à son serveur MCP embarqué ; quand `AGENTMEMORY_URL` est vide, le shim MCP utilise `http://localhost:3111`.
### Codex CLI (plateforme de plugins Codex)
```bash
# 1. start the memory server in a separate terminal
npx -y @agentmemory/agentmemory@latest
# 2. register the agentmemory marketplace and install the plugin
codex plugin marketplace add rohitg00/agentmemory
codex plugin add agentmemory@agentmemory
```
Le plugin Codex est livré depuis le même répertoire `plugin/` que le plugin Claude Code. Il enregistre :
- Un pont MCP stdio embarqué vers le daemon en cours d'exécution, sans téléchargement npm ni store de fallback. Voir le [guide Codex local](../docs/plugins/codex-local.md) pour tester un build non publié.
- 6 hooks de cycle de vie : `SessionStart`, `UserPromptSubmit`, `PreToolUse`, `PostToolUse`, `PreCompact`, `Stop`
- 9 skills invocables : `/recall`, `/remember`, `/session-history`, `/forget`, `/recap`, `/handoff`, `/lesson`, `/commit-context`, `/commit-history`, plus 8 skills de référence que l'agent charge à la demande (discipline de mémoire, outils MCP, API REST, config, agents, hooks, architecture, et le guide d'écriture de skills)
Le moteur de hooks de Codex injecte `CLAUDE_PLUGIN_ROOT` dans les sous-processus de hooks (selon [`codex-rs/hooks/src/engine/discovery.rs`](https://github.com/openai/codex/blob/main/codex-rs/hooks/src/engine/discovery.rs)), si bien que les mêmes scripts de hooks fonctionnent sur les deux hôtes sans duplication. Les événements Subagent / SessionEnd / Notification / TaskCompleted / PostToolUseFailure sont spécifiques à Claude Code et ne sont pas enregistrés pour Codex.
#### Hooks Codex : confiance et compatibilité
Le déclenchement natif des hooks de plugin est vérifié avec Codex CLI 0.150.1. Faites confiance aux hooks du plugin avant de vous attendre à une capture. Le comportement de Codex Desktop dépend de son runtime embarqué ; vérifiez `/hooks` et confirmez un événement capturé avant d'activer une solution de contournement.
Si votre hôte nécessite des hooks globaux, répliquez les commandes dans le `~/.codex/hooks.json` global. Quand MCP est déjà câblé, l'adaptateur `connect` actuel a besoin de `--force` pour atteindre l'installation des hooks :
```bash
agentmemory connect codex --with-hooks --force
```
Cela fusionne les hooks globaux et réécrit l'entrée MCP d'agentmemory, en préservant les entrées non liées. Vérifiez vos paramètres d'endpoint agentmemory personnalisés avant d'utiliser `--force`. Relancez après une mise à niveau pour rafraîchir les chemins des scripts. Activez soit les hooks natifs du plugin, soit les copies globales, pour éviter une capture en double.
### GitHub Copilot CLI
Pour le mode agent de VS Code, utilisez le [guide MCP et capture automatique de Copilot](../docs/plugins/copilot.md#vs-code-copilot-local-agent-sessions). Le connecteur CLI ne configure pas VS Code.
```bash
# MCP-only wiring
agentmemory connect copilot-cli
# Alternatively, full hooks/skills plugin from the GitHub subdir
copilot plugin install rohitg00/agentmemory:plugin
```
`agentmemory connect copilot-cli` fusionne `mcpServers.agentmemory` dans `~/.copilot/mcp-config.json` (ou `$COPILOT_HOME/mcp-config.json` quand `COPILOT_HOME` est défini) et préserve les serveurs existants. Sur Windows natif, c'est le seul adaptateur `connect` automatisé ; configurez tout autre agent Windows natif manuellement. Le `connect` sous WSL n'est pris en charge que lorsque l'agent cible est aussi installé dans ce même environnement WSL. Copilot prend en compte le serveur MCP au lancement suivant ou après `/mcp`. Installez aussi le plugin quand vous voulez l'expérience complète hooks/skills.
OpenClaw (collez ce prompt)
```text
Install agentmemory for OpenClaw. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to my OpenClaw MCP config so agentmemory is available with all 54 memory tools:
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
Restart OpenClaw. Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper memory-slot integration, copy `integrations/openclaw` to `~/.openclaw/extensions/agentmemory` and enable `plugins.slots.memory = "agentmemory"` in `~/.openclaw/openclaw.json`.
```
Guide complet : [`integrations/openclaw/`](../integrations/openclaw/)
Hermes Agent (collez ce prompt)
```text
Install agentmemory for Hermes. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to ~/.hermes/config.yaml so Hermes can use agentmemory as an MCP server with all 54 memory tools:
mcp_servers:
agentmemory:
command: npx
args: ["-y", "@agentmemory/mcp"]
memory:
provider: agentmemory
Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper 6-hook memory provider integration (pre-LLM context injection, turn capture, MEMORY.md mirroring, system prompt block), copy integrations/hermes from the agentmemory repo to ~/.hermes/plugins/agentmemory.
```
Guide complet : [`integrations/hermes/`](../integrations/hermes/)
### Autres agents
Démarrez le serveur de mémoire : `npx -y @agentmemory/agentmemory@latest`
#### Skills natifs via `npx skills add` (50+ agents)
agentmemory livre 17 skills au format `/SKILL.md` façon Claude Code : 9 skills d'action invocables (`remember`, `recall`, `recap`, `handoff`, `forget`, `lesson`, `commit-context`, `commit-history`, `session-history`) et 8 skills de référence que l'agent charge à la demande (`memory-discipline`, `agentmemory-mcp-tools`, `agentmemory-rest-api`, `agentmemory-config`, `agentmemory-agents`, `agentmemory-hooks`, `agentmemory-architecture`, `write-agentmemory-skill`). Les skills de référence embarquent des tableaux de données générés depuis les sources, donc ils ne dérivent jamais. La CLI [`skills`](https://npmjs.com/package/skills) de vercel-labs les installe automatiquement dans le répertoire de skills natif de l'agent appelant sur 50+ agents (Claude Code, Cursor, Cline, Continue, Droid, Warp, Codex, Antigravity, Kiro, OpenCode, Goose, Roo, Trae, Windsurf, et plus) :
```bash
npx skills add rohitg00/agentmemory -y # auto-detects the calling agent
npx skills add rohitg00/agentmemory -y -a warp # explicit agent
npx skills add rohitg00/agentmemory -y -a '*' # install to every installed agent
```
Ceci est **complémentaire** à `agentmemory connect ` :
- `agentmemory connect ` écrit la config du serveur MCP pour que les outils soient disponibles.
- `npx skills add rohitg00/agentmemory` installe les skills pour que l'agent sache quand les appeler.
Pour les rares agents que la CLI skills ne couvre pas encore (Zed v1.3.x et antérieures), déposez vous-même les 17 fichiers SKILL.md dans le répertoire de skills natif de l'agent ; le même format fonctionne partout.
#### Bloc MCP standard
L'entrée agentmemory est le **même bloc de serveur MCP** sur tous les hôtes qui utilisent la forme `mcpServers` (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI, OpenClaw) :
```json
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "${AGENTMEMORY_URL}",
"AGENTMEMORY_SECRET": "${AGENTMEMORY_SECRET}"
}
}
```
**Fusionnez cette entrée dans l'objet `mcpServers` existant** du fichier de config de l'hôte ; ne remplacez pas le fichier. Si le fichier a déjà d'autres serveurs, ajoutez `agentmemory` à côté d'eux comme une autre clé à l'intérieur de `mcpServers`. Si `mcpServers` est totalement absent, collez le bloc dans `{ "mcpServers": { ... } }`. Les placeholders `${VAR}` héritent de `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` depuis le shell au lancement du serveur MCP ; les variables non définies transmettent des chaînes vides et le shim retombe sur `http://localhost:3111`. Une seule entrée câblée couvre à la fois les déploiements locaux et distants (k8s / derrière un reverse-proxy).
| Agent | Fichier de config | Notes |
|---|---|---|
| **Cursor (MCP uniquement)** | `~/.cursor/mcp.json` | Fusionnez dans `mcpServers`, ou `agentmemory connect cursor`. Un deeplink en un clic est aussi disponible sur le site. |
| **Cursor (plugin complet)** | `.cursor-plugin/` | Listing sur le Cursor Marketplace (soumission en cours de revue) ou Cursor Settings → Plugins → checkout local. Enregistre 7 hooks de capture automatique (sessionStart, beforeSubmitPrompt, preToolUse, postToolUse, postToolUseFailure, stop, sessionEnd) + 17 skills + le serveur MCP, avec `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` gérés dans le dashboard de plugin de Cursor. Fonctionne dans l'IDE Cursor et la CLI `cursor-agent` ; les prompts du mode print de la CLI sont réalimentés depuis le transcript de session en fin de session. |
| **Claude Desktop** | `claude_desktop_config.json` (Application Support) | Fusionnez dans `mcpServers`. Redémarrez Claude Desktop après édition. |
| **Cline / Roo Code / Kilo Code** | Paramètres MCP de Cline (Settings UI → MCP Servers → Edit) | Même bloc `mcpServers`. |
| **Devin CLI (MCP + hooks)** | `~/.config/devin/config.json` | `agentmemory connect devin` fusionne l'entrée MCP ; `--with-hooks` ajoute six hooks natifs de capture automatique (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop, SessionEnd) avec les matchers d'outils en minuscules de Devin. Vérifiez avec `devin mcp list` et `/hooks` dans devin. |
| **Devin CLI (plugin complet)** | `plugin/.devin-plugin/` | `devin plugins install ./plugin` depuis un checkout enregistre les 17 skills comme commandes slash `/agentmemory:` plus le serveur MCP. Les hooks du plugin Devin ne peuvent pas déclencher `SessionStart`/`SessionEnd`, donc associez-le à `connect devin --with-hooks` pour une capture de session complète. |
| **Devin (cloud)** | Settings → Connections → MCP servers | Ajoutez un MCP personnalisé (STDIO) : commande `npx`, args `-y @agentmemory/mcp@latest`, env `AGENTMEMORY_URL` pointant vers un déploiement agentmemory accessible sur le réseau plus `AGENTMEMORY_SECRET` (les sessions cloud ne peuvent pas atteindre localhost — voir [`deploy/`](../deploy/)). Stockez le secret dans Devin Secrets, puis utilisez « Test listing tools » pour vérifier que les 54 outils apparaissent. |
| **Gemini CLI** | `~/.gemini/settings.json` | `gemini mcp add agentmemory npx -y @agentmemory/mcp --scope user` (fusion automatique). |
| **GitHub Copilot CLI (MCP uniquement)** | `~/.copilot/mcp-config.json` | `agentmemory connect copilot-cli` fusionne `mcpServers.agentmemory` ; Copilot le prend en compte au lancement suivant ou via `/mcp`. |
| **GitHub Copilot CLI (plugin complet)** | Installation de plugin Copilot | `copilot plugin install rohitg00/agentmemory:plugin` pour le plugin depuis le sous-répertoire GitHub. |
| **OpenClaw** | Config MCP d'OpenClaw | Même bloc `mcpServers`. Plus poussé : `openclaw plugins install ./integrations/openclaw` revendique le slot de mémoire d'OpenClaw (bascule automatique depuis `memory-core`) ; définissez `plugins.entries.agentmemory.hooks.allowConversationAccess=true` sinon la capture de tour est silencieusement bloquée. Voir [`integrations/openclaw`](../integrations/openclaw/). |
| **Codex CLI (MCP uniquement)** | `.codex/config.toml` | Forme TOML : `codex mcp add agentmemory -- npx -y @agentmemory/mcp`, ou ajoutez `[mcp_servers.agentmemory]` manuellement. |
| **Codex CLI (plugin complet)** | Marketplace de plugins Codex | `codex plugin marketplace add rohitg00/agentmemory` puis `codex plugin add agentmemory@agentmemory`. Enregistre MCP + 6 hooks de cycle de vie + 17 skills. Faites confiance aux hooks et vérifiez la capture dans votre hôte ; voir [Configuration et validation Codex](../docs/plugins/codex-local.md). |
| **OpenCode (MCP uniquement)** | `opencode.json` | Forme différente : clé `mcp` de premier niveau, commande en tableau : `{"mcp": {"agentmemory": {"type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true}}}`. |
| **OpenCode (plugin complet)** | `plugin/opencode/` | 22 hooks de capture automatique couvrant le cycle de vie des sessions, les messages, les outils, les erreurs. L'attribution de projet est par session, donc un processus OpenCode unique couvrant plusieurs dépôts classe chaque session sous son propre projet. Deux commandes slash (`/recall`, `/remember`). Copiez `plugin/opencode/` dans votre espace de travail OpenCode et ajoutez l'entrée du plugin à `opencode.json`. Voir [`plugin/opencode/README.md`](../plugin/opencode/README.md) pour le tableau complet des hooks + l'analyse des écarts. |
| **pi** | `~/.pi/agent/extensions/agentmemory` | `agentmemory connect pi` installe l'extension embarquée dans le répertoire d'auto-découverte de pi (recall au démarrage de l'agent, capture à la fin de l'agent, outils `memory_search` / `memory_save` / `memory_health`, `/agentmemory-status`). `/reload` dans un pi en cours d'exécution la prend en compte. [`integrations/pi`](../integrations/pi/) est aussi un paquet pi (`pi install ./integrations/pi` depuis un checkout). |
| **Hermes Agent** | `~/.hermes/config.yaml` | `cp -r integrations/hermes ~/.hermes/plugins/agentmemory` + `memory.provider: agentmemory` donne le fournisseur de mémoire à 6 hooks (préchargement, capture de tour, fin de session, pré-compression, mise en miroir de MEMORY.md, bloc de prompt système). Validez avec `hermes plugins doctor` et `hermes memory status`. Voir [`integrations/hermes`](../integrations/hermes/). |
| **Qwen Code** | `~/.qwen/settings.json` | `agentmemory connect qwen` écrit le bloc `mcpServers` standard. Le payload des hooks est compatible champ par champ avec Claude Code, donc les 12 scripts de hooks existants fonctionnent sans modification ; câblez-les via la section `hooks` du même `settings.json`. |
| **Antigravity IDE / 2.0** | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity --with-hooks` installe MCP et les hooks de capture dans le répertoire de personnalisation partagé. Voir [Configuration et limites d'Antigravity](../docs/plugins/antigravity.md). |
| **Antigravity CLI** (`agy`) | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity-cli --with-hooks` utilise la même configuration MCP et hooks que les versions actuelles de l'IDE. Les installations existantes doivent se rafraîchir avec `--force` ; voir les [notes de mise à jour](../docs/plugins/antigravity.md). |
| **Kiro** | `~/.kiro/settings/mcp.json` | `agentmemory connect kiro` écrit la config au niveau utilisateur. Les surcharges au niveau du workspace vont dans `.kiro/settings/mcp.json` à côté de votre code. |
| **Warp** | `~/.warp/.mcp.json` | `agentmemory connect warp` écrit le bloc `mcpServers` standard. Warp découvre aussi automatiquement les skills depuis `.claude/skills/` ; une fois le plugin Claude Code installé, les 8 skills agentmemory (`remember`, `recall`, `recap`, `handoff`, `forget`, `commit-context`, `commit-history`, `session-history`) apparaissent nativement dans la palette de commandes slash de Warp. |
| **Cline (CLI)** | `~/.cline/mcp.json` | `agentmemory connect cline` écrit le bloc `mcpServers` standard. Utilisateurs de l'extension VS Code : collez le même bloc via Cline Settings → MCP Servers → Edit JSON. |
| **Continue.dev** | `~/.continue/config.yaml` (préféré) ou `config.json` (legacy) | `agentmemory connect continue` crée `config.yaml` à partir de rien quand aucun des deux n'existe, ou modifie le `config.json` existant. **Si vous avez déjà un `config.yaml`**, l'adaptateur affiche le bloc exact à coller sous `mcpServers:` ; il ne réécrira pas silencieusement votre yaml car préserver les commentaires et les ancres en toute sécurité nécessite un parseur YAML que le paquet n'embarque pas. Continue utilise la forme tableau (pas objet) pour `mcpServers`. |
| **Zed** | `~/.config/zed/settings.json` | `agentmemory connect zed` écrit sous `context_servers` (la clé de Zed, PAS `mcpServers`). Les serveurs MCP distants peuvent être câblés via `{"url": "..."}` à la place. |
| **Droid (Factory.ai)** | `~/.factory/mcp.json` | `agentmemory connect droid` écrit le bloc `mcpServers` standard. Les surcharges au niveau du projet vont dans `/.factory/mcp.json`. Passez `--with-hooks` pour la capture automatique native. |
| **DeepSeek Harness** | `$DSH_HOME/cordis.patch.yml` | `agentmemory connect dsh` ajoute une ligne `@deepseek-ai/dsh-mcp-client` à la couche de patch de niveau home que chaque profil Harness charge ; les outils s'enregistrent comme `mcp__agentmemory__*`. Passez `--with-hooks` pour câbler aussi la capture automatique : les scripts de hooks Claude Code embarqués tournent via le pont natif `@deepseek-ai/dsh-hooks-claude-code` de Harness (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop) via un manifeste écrit dans `$DSH_HOME/agentmemory.hooks.json`. Par défaut `~/.dsh` quand `DSH_HOME` n'est pas défini. |
| **Goose** | UI des paramètres MCP de Goose | Même bloc `mcpServers` ; utilisez `goose configure` → Add Extension → MCP. L'édition YAML directe sur `~/.config/goose/config.yaml` est prise en charge mais le schéma utilise `extensions:` + `cmd` (pas `mcpServers:` + `command`). |
| **Aider** | n/a | Parlez directement à l'API REST : `curl -X POST http://localhost:3111/agentmemory/smart-search -d '{"query": "auth"}'`. |
| **Tout agent (32+)** | n/a | `npx skillkit install agentmemory` détecte automatiquement l'hôte et fusionne. |
**Clients MCP sandboxés** (Flatpak / Snap / conteneurs restrictifs) qui ne peuvent pas atteindre le `localhost` de l'hôte : définissez aussi `"AGENTMEMORY_FORCE_PROXY": "1"` dans le bloc `env`, et pointez `AGENTMEMORY_URL` vers une route que le sandbox peut réellement atteindre (par ex. votre IP LAN).
### Accès programmatique (Python / Rust / Node)
agentmemory enregistre ses opérations centrales comme fonctions iii (`mem::remember`, `mem::observe`, `mem::context`, `mem::smart-search`, `mem::forget`). Tout langage disposant d'un SDK iii peut les appeler directement via `ws://localhost:49134`, sans client REST séparé par langage.
```bash
pip install iii-sdk # Python
cargo add iii-sdk # Rust
npm install iii-sdk # Node
```
```python
from iii import register_worker
iii = register_worker("ws://localhost:49134")
iii.connect()
iii.trigger({
"function_id": "mem::smart-search",
"payload": {"project": "demo", "query": "how do tokens refresh"},
})
```
Exemple travaillé : [`examples/python/`](../examples/python/) (démarrage rapide + flux observation/recall). REST sur `:3111` reste disponible pour les hôtes sans runtime iii.
### Depuis les sources
```bash
git clone https://github.com/rohitg00/agentmemory.git && cd agentmemory
npm install && npm run build && npm start
```
Cela démarre agentmemory avec un `iii-engine` local si le binaire épinglé est déjà installé, ou utilise Docker Compose si sélectionné. REST, streams et le visualiseur se lient à `127.0.0.1` par défaut. Le chemin automatique de binaire macOS/Linux nécessite `curl`, un `sh` POSIX, et `tar`.
Installez `iii-engine` manuellement. **agentmemory épingle actuellement `iii-engine` à `v0.22.1`**, la même version que sa dépendance `iii-sdk` ; le worker parle le protocole réseau de ce moteur, et 0.20.0 a réorganisé la surface du SDK, donc les deux évoluent ensemble dans les versions d'agentmemory. Remplacez avec `AGENTMEMORY_III_VERSION=` si vous faites tourner votre propre moteur et savez qu'il correspond.
- **macOS arm64 :** `mkdir -p ~/.local/bin && curl -fsSLo iii.tar.gz https://github.com/iii-hq/iii/releases/download/iii/v0.22.1/iii-aarch64-apple-darwin.tar.gz && echo "2b309019b909a896cae874dc947e2cdf877b4f3c51dd026b79850af858517fa4 iii.tar.gz" | shasum -a 256 -c - && tar -xzf iii.tar.gz -C ~/.local/bin && chmod +x ~/.local/bin/iii`
- **macOS x64 :** remplacez `aarch64-apple-darwin` par `x86_64-apple-darwin`
- **Linux x64 :** remplacez par `x86_64-unknown-linux-gnu`
- **Linux arm64 :** remplacez par `aarch64-unknown-linux-gnu`
- **Windows :** téléchargez `iii-x86_64-pc-windows-msvc.zip` depuis [iii-hq/iii releases v0.22.1](https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1) et extrayez `iii.exe` vers `%USERPROFILE%\.agentmemory\bin\iii.exe`
Chaque archive a un fichier `.sha256` correspondant sur la page de release ; quand vous changez de plateforme, utilisez le hash de ce fichier dans la vérification ci-dessus (sur Windows : `Get-FileHash`). L'installateur automatique dans `npx @agentmemory/agentmemory` épingle ces hashs et refuse une archive qui ne correspond pas.
Ou utilisez Docker (le `docker-compose.yml` embarqué récupère `iiidev/iii:0.22.1`). Documentation complète : [iii.dev/docs](https://iii.dev/docs).
### Windows
agentmemory fonctionne sur Windows 10/11, mais le paquet Node.js seul ne suffit pas ; vous avez aussi besoin du runtime iii-engine v0.22.1 épinglé comme processus en arrière-plan. La CLI n'extrait pas automatiquement le ZIP Windows, donc les utilisateurs Windows natifs doivent installer `iii.exe` manuellement, utiliser WSL2, ou choisir Docker Desktop.
Le câblage MCP automatisé natif sous Windows ne prend en charge que `agentmemory connect copilot-cli`. Pour Claude Code, Codex, Cursor et tout autre agent Windows natif, copiez le bloc MCP manuel depuis [Autres agents](#other-agents) dans la config Windows de cet agent. Exécuter `connect` sous WSL n'est approprié que lorsque l'agent cible est aussi installé dans ce même environnement WSL ; cela ne modifie pas la config d'un agent hébergé sous Windows.
**Option A : binaire Windows précompilé (recommandé)**
```powershell
# 1. Open https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1 in your browser
# (agentmemory pins the engine to the same release as its iii-sdk;
# v0.22.1 is the current pair)
# 2. Download iii-x86_64-pc-windows-msvc.zip
# (or iii-aarch64-pc-windows-msvc.zip if you're on an ARM machine)
# 3. Extract iii.exe to agentmemory's private engine directory:
New-Item -ItemType Directory -Force "$HOME\.agentmemory\bin"
# Copy iii.exe to $HOME\.agentmemory\bin\iii.exe
# 4. Verify:
& "$HOME\.agentmemory\bin\iii.exe" --version
# Should print: 0.22.1
# 5. Then run agentmemory as usual:
npx -y @agentmemory/agentmemory@latest
```
**Option B : Docker Desktop**
```powershell
# 1. Install Docker Desktop for Windows
# 2. Start Docker Desktop and make sure the engine is running
# 3. Select Docker explicitly and run agentmemory:
$env:AGENTMEMORY_USE_DOCKER = "1"
npx -y @agentmemory/agentmemory@latest
```
**Option C : MCP standalone uniquement (sans moteur).** Si vous avez seulement besoin des outils MCP pour votre agent et n'avez pas besoin de l'API REST, du visualiseur ou des tâches cron, ignorez complètement le moteur :
```powershell
npx -y @agentmemory/agentmemory@latest mcp
# or via the shim package:
npx -y @agentmemory/mcp
```
**Diagnostics pour Windows :** si `npx -y @agentmemory/agentmemory@latest` échoue, relancez-la avec `--verbose` pour voir le stderr réel du moteur. Modes d'échec courants :
| Symptôme | Correctif |
|---|---|
| `The engine process started but the REST API never responded.` | Confirmez que les quatre ports dérivés sont libres, vérifiez que l'`iii.exe` épinglé est resté actif, puis relancez avec `--verbose` et examinez le stderr du moteur capturé |
| `Could not start iii-engine` | Ni `iii.exe` ni Docker ne sont installés. Voir l'Option A ou B ci-dessus |
| Conflit de port | `netstat -ano \| findstr :3111` pour voir ce qui est lié, puis tuez-le ou utilisez `--port ` |
| Repli sur Docker ignoré même si Docker est installé | Assurez-vous que Docker Desktop est réellement en cours d'exécution (icône dans la barre système) |
> Remarque : le **moteur** iii est un binaire précompilé, pas une crate cargo, donc n'essayez pas de faire `cargo install` dessus. (Les **SDK** iii sont publiés sur crates.io, npm et PyPI, mais agentmemory n'en a pas besoin.) Les méthodes d'installation du moteur prises en charge sont toutes épinglées à v0.22.1 : le binaire précompilé ci-dessus, le chemin d'auto-installation macOS/Linux d'agentmemory (`curl`, `sh` POSIX, et `tar` requis), et l'image Docker `iiidev/iii:0.22.1`. Un `install.sh | sh` amont nu installe le dernier moteur, que agentmemory ne prend pas en charge. Utilisez `npx -y @agentmemory/agentmemory@latest` ; sur macOS/Linux il récupère le moteur épinglé dans `~/.agentmemory/bin`.
---
Déploiement
Des templates en un clic pour les hébergeurs managés. Chacun livre un
Dockerfile autonome qui récupère `@agentmemory/agentmemory` depuis npm et
copie le binaire du moteur iii depuis l'image Docker Hub officielle
`iiidev/iii` ; aucune image agentmemory pré-construite n'est requise. Le
stockage persistant se monte sur `/data` ; le point d'entrée du premier
démarrage remplace la config iii embarquée dans npm (qui se lie à
`127.0.0.1`) par une config adaptée au déploiement qui se lie à
`0.0.0.0` et utilise des chemins `/data` absolus, génère le secret
HMAC, puis abandonne les privilèges de `root` vers `node` via
`gosu` avant d'exécuter la CLI agentmemory.
Le bouton de déploiement en un clic de Render nécessite un `render.yaml` à la racine du dépôt, que nous gardons volontairement propre. Utilisez le flux Render Blueprint documenté dans [`deploy/render/`](.././deploy/render/README.md) pour pointer manuellement vers le blueprint du dépôt.
Les détails complets de configuration (capture HMAC, tunnel SSH du
visualiseur, rotation, sauvegarde, planchers de coût) se trouvent dans
[`deploy/`](.././deploy/README.md) :
- [`deploy/fly`](.././deploy/fly/README.md) : machine unique avec
`auto_stop_machines = "stop"` ; le plus économique en veille.
- [`deploy/railway`](.././deploy/railway/README.md) : forfait Hobby,
volume dans le dashboard.
- [`deploy/render`](.././deploy/render/README.md) : flux Blueprint,
snapshots automatiques du disque sur les plans payants.
- [`deploy/coolify`](.././deploy/coolify/README.md) : auto-hébergé sur
votre propre VPS via [Coolify](https://coolify.io/self-hosted) ; même
stack Docker Compose, vous possédez l'hôte et les données.
Seul le port `3111` est publié. Le visualiseur sur `3113` reste lié à
loopback à l'intérieur du conteneur ; le README de chaque template
documente le motif de tunnel SSH pour l'atteindre.
---
Chaque agent de codage oublie tout quand la session se termine, et chaque nouvelle session commence avec vous qui réexpliquez votre stack. agentmemory tourne en arrière-plan et supprime cette étape.
```text
Session 1: "Add auth to the API"
Agent writes code, runs tests, fixes bugs
agentmemory silently captures every tool use
Session ends -> observations compressed into structured memory
Session 2: "Now add rate limiting"
Agent already knows:
- Auth uses JWT middleware in src/middleware/auth.ts
- Tests in test/auth.test.ts cover token validation
- You chose jose over jsonwebtoken for Edge compatibility
Zero re-explaining. Starts working immediately.
```
### vs la mémoire intégrée de l'agent
Chaque agent de codage IA est livré avec une mémoire intégrée : Claude Code a `MEMORY.md`, Cursor a des notepads, Cline a une memory bank. Elles fonctionnent comme des post-it. agentmemory est la base de données interrogeable derrière les post-it.
| | Intégré (CLAUDE.md) | agentmemory |
|---|---|---|
| Échelle | Plafond de 200 lignes | Illimité |
| Recherche | Charge tout en contexte | BM25 + vectoriel + graphe (top-K seulement) |
| Coût en tokens | 22K+ à 240 observations | ~1 900 tokens (92% de moins) |
| Entre agents | Fichiers par agent | MCP + REST (tout agent) |
| Coordination | Aucune | Leases, signaux, actions, routines |
| Observabilité | Lire les fichiers manuellement | Visualiseur temps réel sur :3113 |
---
### Pipeline de mémoire
```text
PostToolUse hook fires
-> SHA-256 dedup (5min window)
-> Privacy filter (strip secrets, API keys)
-> Store raw observation
-> Synthetic compression by default
(LLM-written compression only with a provider + AGENTMEMORY_AUTO_COMPRESS=true)
-> Vector embedding when an embedding provider is active
-> Index in BM25, plus vectors when enabled
Stop / SessionEnd hook fires
-> Summarize session
-> Knowledge graph extraction (if GRAPH_EXTRACTION_ENABLED=true)
-> Slot reflection (if SLOT_REFLECT_ENABLED=true)
SessionStart hook fires
-> Load project profile (top concepts, files, patterns)
-> Hybrid search (BM25 + vector + graph)
-> Token budget (default: 2000 tokens)
-> Inject into conversation
```
### Consolidation de mémoire à 4 niveaux
Modélisé sur la façon dont les cerveaux humains traitent la mémoire, y compris la consolidation pendant le sommeil.
| Niveau | Quoi | Analogie |
|------|------|---------|
| **Working** | Observations brutes issues de l'usage des outils | Mémoire à court terme |
| **Episodic** | Résumés de session compressés | « Ce qui s'est passé » |
| **Semantic** | Faits et patterns extraits | « Ce que je sais » |
| **Procedural** | Workflows et patterns de décision | « Comment faire » |
Les mémoires se dégradent avec le temps (courbe d'Ebbinghaus). Les mémoires fréquemment consultées se renforcent. Les mémoires obsolètes sont évincées automatiquement. Les contradictions sont détectées et résolues.
### Ce qui est capturé
| Hook | Capture |
|------|----------|
| `SessionStart` | Chemin du projet, ID de session |
| `UserPromptSubmit` | Prompts utilisateur (filtrés pour la confidentialité) |
| `PreToolUse` | Patterns d'accès aux fichiers + contexte enrichi |
| `PostToolUse` | Nom de l'outil, entrée, sortie |
| `PostToolUseFailure` | Contexte d'erreur |
| `PreCompact` | Réinjecte la mémoire avant la compaction |
| `SubagentStart/Stop` | Cycle de vie des sous-agents |
| `Stop` | Résumé de fin de session |
| `SessionEnd` | Marqueur de session terminée |
### Capacités clés
| Capacité | Description |
|---|---|
| **Capture automatique** | Chaque usage d'outil enregistré via des hooks, aucun effort manuel |
| **Recherche sémantique** | BM25 + vectoriel + graphe de connaissances avec fusion RRF |
| **Évolution de la mémoire** | Versioning, supersession, graphes de relations |
| **Hygiène de recall** | Les versions de mémoire supersédées quittent les index de recherche ; la chaîne de versions en KV conserve l'historique complet |
| **Indices de quasi-doublon** | Les sauvegardes signalent une correspondance consultative `similarTo` quand un nouveau contenu ressemble fortement à une mémoire existante |
| **Scoping par agent** | `agentId` traverse la sauvegarde et le recall à travers REST, MCP, et l'index de recherche, en mode partagé ou isolé |
| **Provenance à l'écriture** | Chaque observation et chaque mémoire porte un canal d'origine immuable (user, agent, tool, import, ou shared) tamponné à la capture, la sauvegarde et l'import |
| **Oubli automatique** | Expiration TTL, détection de contradiction, éviction par importance |
| **Confidentialité d'abord** | Clés API, secrets, tags `` retirés avant le stockage |
| **Auto-réparation** | Circuit breaker, chaîne de repli de fournisseur, surveillance de santé |
| **Pont Claude** | Synchronisation bidirectionnelle avec MEMORY.md |
| **Graphe de connaissances** | Extraction d'entités + parcours BFS |
| **Mémoire d'équipe** | Partagée + privée, namespacée entre les membres de l'équipe |
| **Provenance des citations** | Retracer toute mémoire jusqu'à ses observations source |
| **Snapshots Git** | Versionner, revenir en arrière et diffuser l'état de la mémoire |
---
Récupération à triple flux combinant trois signaux :
| Flux | Ce qu'il fait | Quand |
|---|---|---|
| **BM25** | Correspondance de mots-clés avec stemming et expansion de synonymes | Toujours actif |
| **Vectoriel** | Similarité cosinus sur des embeddings denses | Fournisseur d'embedding configuré |
| **Graphe** | Parcours du graphe de connaissances via correspondance d'entités | Entités détectées dans la requête |
Fusionné avec la Reciprocal Rank Fusion (RRF, k=60) et diversifié par session (max 3 résultats par session).
Quand un index vectoriel est peuplé, `mem::search` (derrière `memory_recall`) utilise le ranker hybride BM25 + vectoriel. Sans embeddings, il utilise BM25. `smart-search` peut en plus fusionner des correspondances de graphe structurel quand des données de graphe existent, y compris en mode sans clé. Le recall de lessons tourne sur un index BM25 en mémoire dédié plutôt que de scanner tout le corpus à chaque requête. Les versions de mémoire supersédées sont exclues de tout chemin de recall ; la chaîne de versions conserve leur historique.
Les vecteurs survivent à un crash ou à un force-kill. L'index vectoriel est sauvegardé par lots au plus toutes les `AGENTMEMORY_INDEX_SAVE_INTERVAL_MS` (10 minutes). Chaque vecteur ajouté ou retiré entre-temps est aussi écrit immédiatement dans un petit journal en attente dans le state store, et le prochain démarrage le rejoue sans appeler le fournisseur d'embedding. Chaque sauvegarde réussie vide le journal. Les documents qui n'ont toujours pas de vecteur après le replay sont réembarqués en arrière-plan par lots de `AGENTMEMORY_VECTOR_BACKFILL_MAX` (500) jusqu'à épuisement, et un backfill arrêté reprend au démarrage suivant. `/agentmemory/status` et le visualiseur affichent la taille du journal en attente et l'état du backfill. Les installations sans clé n'écrivent rien.
BM25 tokenise le grec, le cyrillique, l'hébreu, l'arabe et le latin accentué nativement. Pour les mémoires en chinois / japonais / coréen, installez les segmenteurs optionnels (`npm install @node-rs/jieba tiny-segmenter`) pour découper les suites CJK en tokens au niveau mot ; sans eux, agentmemory retombe en douceur sur une tokenisation en bloc complet et affiche un indice ponctuel sur stderr.
### Fournisseurs d'embedding
Les installations sans clé désactivent les embeddings vectoriels : `mem::search` utilise BM25, tandis que `smart-search` peut aussi utiliser des données de graphe structurel existantes. Pour opter pour des embeddings sémantiques gratuits sur l'appareil, ajoutez ceci à `~/.agentmemory/.env` et redémarrez agentmemory :
```env
EMBEDDING_PROVIDER=local
```
L'installation npm normale inclut le runtime optionnel `@huggingface/transformers`. La première requête d'embedding télécharge `Xenova/all-MiniLM-L6-v2`, donc elle nécessite un accès réseau et peut prendre plus de temps ; l'inférence suivante tourne sur l'appareil. Les fournisseurs distants sont auto-détectés depuis leurs clés sauf si `EMBEDDING_PROVIDER` les remplace.
| Fournisseur | Modèle | Coût | Notes |
|---|---|---|---|
| **Local (opt-in recommandé)** | `all-MiniLM-L6-v2` | Gratuit | Sur l'appareil après le premier téléchargement de modèle, +8pp de recall par rapport à BM25 seul |
| Gemini | `gemini-embedding-001` | Palier gratuit | 100+ langues, 768/1536/3072 dims (MRL), entrée de 2048 tokens. Remplace `text-embedding-004` ([obsolète, arrêt le 14 janvier 2026](https://ai.google.dev/gemini-api/docs/deprecations)) |
| OpenAI | `text-embedding-3-small` | 0.02 $/1M | Meilleure qualité |
| Voyage AI | `voyage-code-3` | Payant | Optimisé pour le code |
| Cohere | `embed-english-v3.0` | Essai gratuit | Usage général |
| OpenRouter | N'importe quel modèle | Variable | Proxy multi-modèle |
---
54 outils, 6 ressources, 3 prompts et 17 skills.
> **Shim MCP vs serveur complet :** le paquet publié `@agentmemory/mcp` est un shim léger. Il expose la surface complète de 54 outils **uniquement quand il peut joindre un serveur agentmemory en cours d'exécution** via `AGENTMEMORY_URL` (mode proxy). Sans serveur joignable, le shim retombe sur un jeu local de 7 outils (`memory_save`, `memory_recall`, `memory_smart_search`, `memory_sessions`, `memory_export`, `memory_audit`, `memory_governance_delete`). La variable d'env `AGENTMEMORY_TOOLS=core|all` est un drapeau *côté serveur* ; la définir dans le bloc `env` du shim n'a aucun effet. Si vous ne voyez que 7 outils dans Cursor / OpenCode / Gemini CLI, démarrez `npx -y @agentmemory/agentmemory@latest` (ou la stack Docker) et définissez `AGENTMEMORY_URL=http://localhost:3111`.
### 54 outils
Trois surfaces d'outils, de la plus petite à la plus grande : `AGENTMEMORY_TOOLS=core` réduit la visibilité à 8 essentiels (`memory_save`, `memory_recall`, `memory_consolidate`, `memory_smart_search`, `memory_sessions`, `memory_diagnose`, `memory_lesson_save`, `memory_reflect`) ; le jeu de base ci-dessous est constitué des 14 outils fondamentaux du registre ; le défaut (`AGENTMEMORY_TOOLS=all`) expose les 54.
Outils de base (14)
| Outil | Description |
|------|-------------|
| `memory_recall` | Rechercher dans les observations passées |
| `memory_compress_file` | Compresser des fichiers markdown en préservant la structure |
| `memory_save` | Sauvegarder un insight, une décision ou un pattern |
| `memory_file_history` | Observations passées sur des fichiers spécifiques |
| `memory_patterns` | Détecter les patterns récurrents |
| `memory_sessions` | Lister les sessions récentes |
| `memory_smart_search` | Recherche hybride sémantique + mot-clé |
| `memory_vision_search` | Rechercher dans les observations d'images |
| `memory_timeline` | Observations chronologiques |
| `memory_profile` | Profil de projet (concepts, fichiers, patterns) |
| `memory_export` | Exporter toutes les données de mémoire |
| `memory_relations` | Interroger le graphe de relations |
| `memory_commit_lookup` | Sessions derrière un commit git |
| `memory_commits` | Commits enregistrés pour une session |
Outils étendus (54 au total, la surface par défaut)
| Outil | Description |
|------|-------------|
| `memory_patterns` | Détecter les patterns récurrents |
| `memory_timeline` | Observations chronologiques |
| `memory_relations` | Interroger le graphe de relations |
| `memory_graph_query` | Parcours du graphe de connaissances |
| `memory_consolidate` | Lancer la consolidation à 4 niveaux |
| `memory_claude_bridge_sync` | Synchroniser avec MEMORY.md |
| `memory_team_share` | Partager avec les membres de l'équipe |
| `memory_team_feed` | Éléments partagés récents |
| `memory_audit` | Piste d'audit des opérations |
| `memory_governance_delete` | Supprimer avec piste d'audit |
| `memory_snapshot_create` | Snapshot versionné par Git |
| `memory_action_create` | Créer des tâches avec dépendances |
| `memory_action_update` | Mettre à jour le statut d'une tâche |
| `memory_frontier` | Tâches non bloquées classées par priorité |
| `memory_next` | La prochaine tâche la plus importante |
| `memory_lease` | Leases exclusifs sur les tâches (multi-agent) |
| `memory_routine_run` | Instancier des routines de workflow |
| `memory_signal_send` | Messagerie inter-agent |
| `memory_signal_read` | Lire les messages avec accusés de réception |
| `memory_checkpoint` | Barrières de condition externe |
| `memory_mesh_sync` | Synchronisation P2P entre instances |
| `memory_sentinel_create` | Observateurs pilotés par événements |
| `memory_sentinel_trigger` | Déclencher des sentinels en externe |
| `memory_sketch_create` | Graphes de tâches éphémères |
| `memory_sketch_promote` | Promouvoir en permanent |
| `memory_crystallize` | Compacter des chaînes de tâches |
| `memory_diagnose` | Vérifications de santé |
| `memory_heal` | Corriger automatiquement un état bloqué |
| `memory_facet_tag` | Tags dimension:valeur |
| `memory_facet_query` | Interroger par tags de facette |
| `memory_verify` | Retracer la provenance |
### 6 ressources · 3 prompts · 17 skills
| Type | Nom | Description |
|------|------|-------------|
| Ressource | `agentmemory://status` | Santé, nombre de sessions, nombre de mémoires |
| Ressource | `agentmemory://project/{name}/profile` | Intelligence par projet |
| Ressource | `agentmemory://project/{name}/recent` | Observations récentes pour un projet |
| Ressource | `agentmemory://memories/latest` | Les 10 dernières mémoires actives |
| Ressource | `agentmemory://graph/stats` | Statistiques du graphe de connaissances |
| Ressource | `agentmemory://team/{id}/profile` | Profil d'équipe partagé |
| Prompt | `recall_context` | Rechercher + retourner des messages de contexte |
| Prompt | `session_handoff` | Données de transfert entre agents |
| Prompt | `detect_patterns` | Analyser les patterns récurrents |
| Skill | `/recall` | Rechercher dans la mémoire |
| Skill | `/remember` | Sauvegarder en mémoire long terme |
| Skill | `/session-history` | Résumés de sessions récentes |
| Skill | `/forget` | Supprimer des observations/sessions |
Le tableau montre les quatre skills de base. Le jeu complet compte 9 skills invocables plus 8 skills de référence ; voir la section Skills natifs ci-dessus.
### MCP standalone
Fonctionne sans le serveur complet, pour tout client MCP. L'une ou l'autre de ces commandes fonctionne :
```bash
npx -y @agentmemory/agentmemory@latest mcp # canonical (always available)
npx -y @agentmemory/mcp # shim package alias
```
Ou ajoutez à la config MCP de votre agent :
La plupart des agents (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI) :
```json
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
```
Fusionnez l'entrée `agentmemory` dans l'objet `mcpServers` existant de votre hôte plutôt que de remplacer le fichier. Pour les clients sandboxés qui ne peuvent pas atteindre le `localhost` de l'hôte, ajoutez `"AGENTMEMORY_FORCE_PROXY": "1"` au bloc env et définissez `AGENTMEMORY_URL` sur une route que le sandbox peut atteindre.
OpenCode (`opencode.json`) :
```json
{
"mcp": {
"agentmemory": {
"type": "local",
"command": ["npx", "-y", "@agentmemory/mcp"],
"enabled": true
}
},
"plugin": ["./plugins/agentmemory-capture.ts"]
}
```
Copiez le fichier du plugin depuis le dépôt :
```bash
mkdir -p ~/.config/opencode/plugins
cp plugin/opencode/agentmemory-capture.ts ~/.config/opencode/plugins/
cp plugin/opencode/commands/*.md ~/.config/opencode/commands/
```
---
Démarre automatiquement sur le port `3113`. Le visualiseur charge un snapshot à la connexion (`GET /agentmemory/viewer/snapshot`) puis applique les événements de stream en direct : nouvelles mémoires, lessons, observations, entrées d'audit, changements de graphe et mises à jour de santé apparaissent sans polling ni rechargement de page. Les seules autres requêtes sont les actions que vous cliquez, les pages « load more » et les recherches. Quand le stream se coupe, le visualiseur affiche l'ancienneté de ses chiffres, se reconnecte avec un backoff et se resynchronise depuis un snapshot.
- **12 onglets en quatre groupes** avec compteurs en direct, deep links (`#memories/`, `#sessions/?obs=`, `#graph/`, `#health/consolidation`), raccourcis clavier et un menu mobile.
- **Memories :** recherche côté serveur, filtres par projet, agent et type, un panneau de détail avec la chaîne de versions et un diff mot à mot, liens de provenance, boutons de copie pour l'id, l'appel MCP et une commande curl, édition (une nouvelle version), forget avec confirmation, forget en masse et export JSON.
- **Sessions :** une timeline d'observations en ligne avec entrée/sortie d'outil lisibles, filtres et pagination, et les mémoires et lessons produites par chaque session.
- **Graph :** recherche, détail de nœud avec relations et sources, une légende qui ne repose pas uniquement sur la couleur, et des contrôles de zoom.
- **Health :** la version en direct de `GET /agentmemory/status`. Chaque problème vient avec son correctif, plus le backend d'état, l'état de sauvegarde de l'index, la progression de la compaction de provenance du graphe et un explicatif de consolidation avec les vrais seuils.
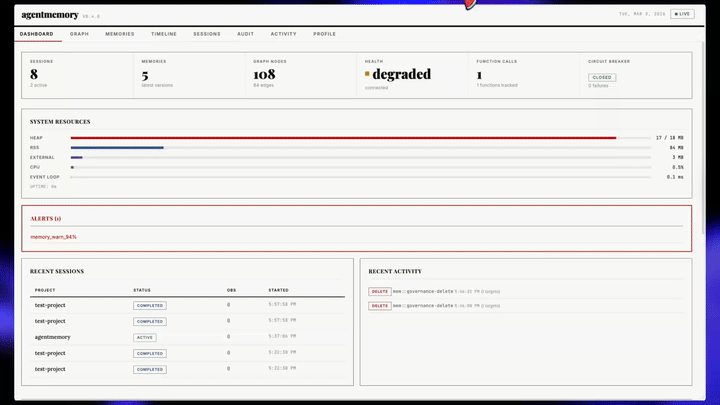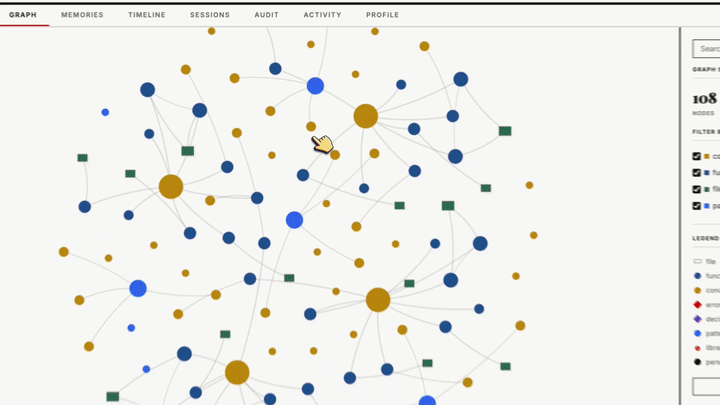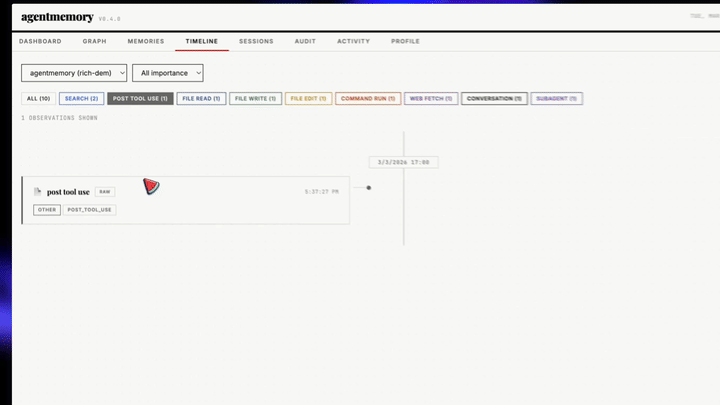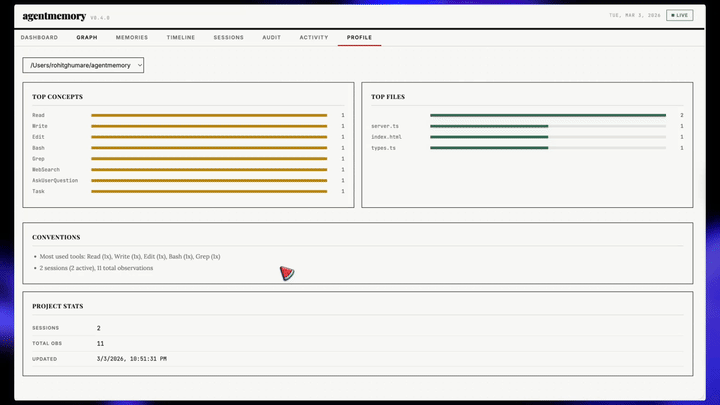
- Pages **Audit, Activity, Profile, Replay, Lessons, Actions et Crystals**, chacune avec un état vide qui indique ce qu'est la section, pourquoi elle est vide et la commande qui la remplit, et une infobulle `?` de glossaire sur chaque terme et chaque chiffre.
```bash
open http://localhost:3113
```
Le serveur du visualiseur se lie à `127.0.0.1` par défaut et attache le secret serveur quand il relaie des requêtes vers l'API REST, donc il ne nécessite aucune configuration. L'endpoint `/agentmemory/viewer` servi par REST suit les règles normales de bearer-token et redirige les navigateurs sans token vers le port du visualiseur. Les en-têtes CSP utilisent un nonce de script par réponse et désactivent les attributs de handler inline (`script-src-attr 'none'`).
---
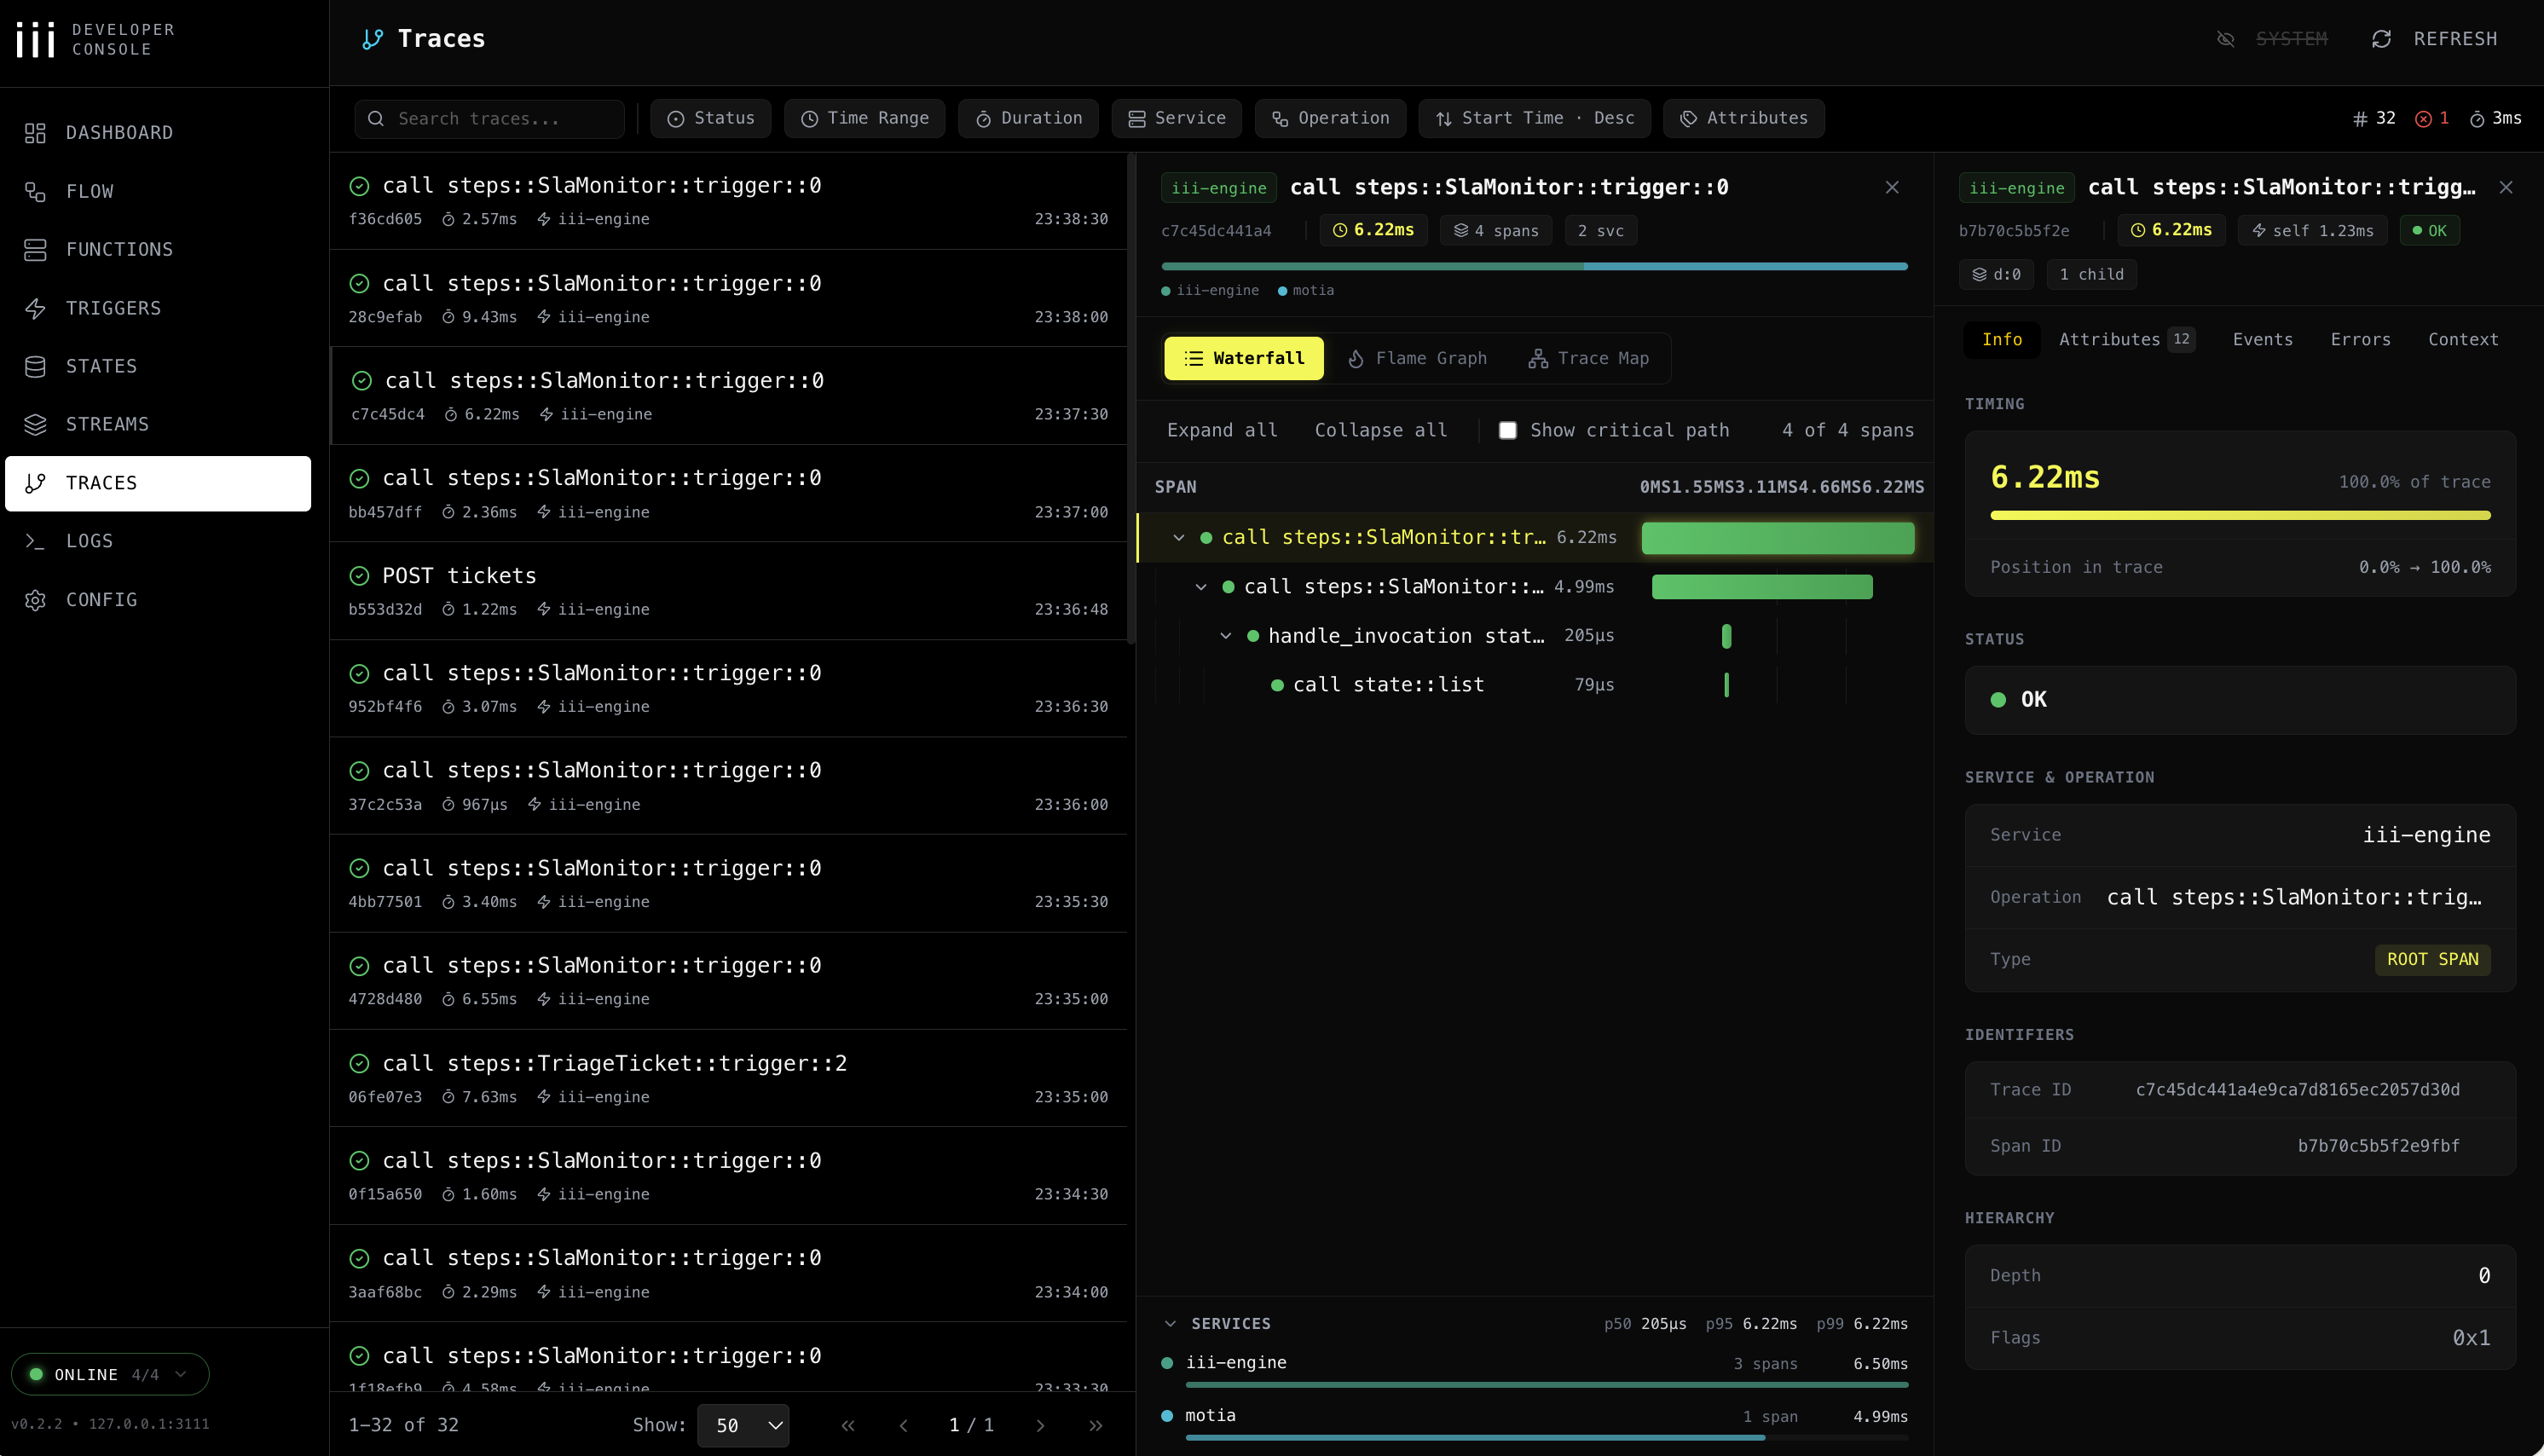
Le visualiseur sur `:3113` montre ce que votre agent **a retenu**. La [console iii](https://iii.dev/docs/console) montre ce que votre agent **a fait** : chaque opération de mémoire comme une trace OpenTelemetry, chaque entrée KV éditable, chaque fonction invocable, chaque stream observable. Deux fenêtres sur la même mémoire : une orientée produit, l'autre orientée moteur.
Observez un `memory_smart_search` se déclencher et voyez le scan BM25 → la recherche d'embedding → la fusion RRF → le reranker sous forme de waterfall. Modifiez un timer de consolidation bloqué dans le navigateur KV. Rejouez un hook `PostToolUse` avec un payload modifié. Épinglez le stream WebSocket et regardez les observations arriver en direct.
agentmemory fournit tout cela gratuitement car chaque appel de fonction et chaque trigger passe par iii ; rien de custom, rien à instrumenter.
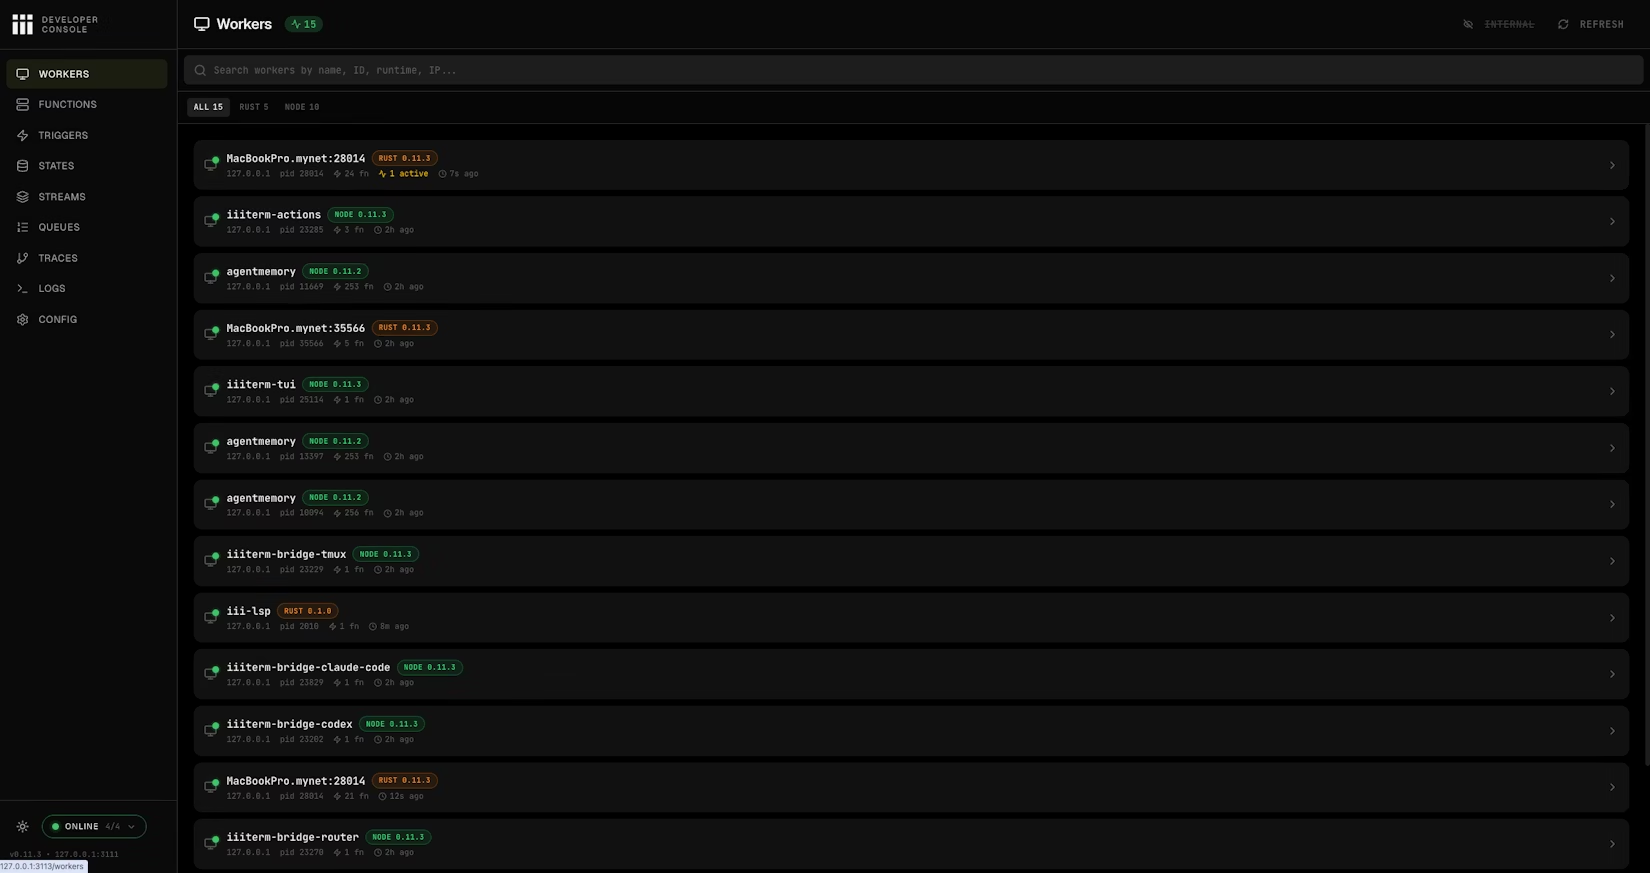
Page Workers : chaque worker connecté, y compris agentmemory lui-même, avec PID, nombre de fonctions, runtime et dernière activité.
**Déjà installée.** La console est livrée avec le moteur `iii` épinglé (0.22+) ; rien de séparé à installer. Le premier lancement télécharge le binaire de la console à côté du moteur.
**Lancer en même temps qu'agentmemory :**
```bash
agentmemory console
```
Cela exécute la `iii console` du moteur épinglé contre les ports résolus par agentmemory (REST, streams, bridge) et la sert un port au-dessus du visualiseur, `http://localhost:3114` par défaut. `--console-port N` choisit un autre port ; `--port` et `--instance` sélectionnent l'instance agentmemory de la même façon que pour `stop` ; tout autre flag est transmis, par exemple `--enable-flow` pour la page expérimentale de graphe d'architecture.
La même chose à la main, utile quand `agentmemory` n'est pas dans le PATH :
```bash
~/.agentmemory/bin/iii console --port 3114 \
--engine-port 3111 \
--ws-port 3112 \
--bridge-port 49134
```
**Ce que vous pouvez faire depuis la console :**
| Page | Utilisez-la pour |
|------|-----------|
| **Workers** | Voir chaque worker connecté et ses métriques en direct, y compris le worker agentmemory lui-même. |
| **Functions** | Invoquer directement n'importe quelle fonction d'agentmemory avec un payload JSON ; pratique pour tester `memory.recall`, `memory.consolidate`, `graph.query` sans câbler un client. |
| **Triggers** | Rejouer des triggers HTTP, cron, événement et état : déclencher manuellement le cron de consolidation, réessayer une route HTTP, émettre un changement d'état. |
| **States** | Navigateur KV avec CRUD complet sur les sessions, les slots de mémoire, les timers de cycle de vie et l'index d'embeddings ; éditez les valeurs sur place. |
| **Streams** | Moniteur WebSocket en direct pour les écritures de mémoire, les événements de hooks et les mises à jour d'observation au fil de leur passage dans les streams iii. |
| **Queues** | Topics de queue durables + gestion des dead-letter. Rejouer ou abandonner les jobs d'embedding / compression échoués. |
| **Traces** | Vues waterfall / flame / répartition par service OpenTelemetry. Filtrez par `trace_id` pour voir exactement quelles fonctions, appels DB et requêtes d'embedding un seul `memory.search` a produit. |
| **Logs** | Logs OTEL structurés, filtrés et corrélés aux IDs de trace/span. |
| **Config** | Configuration runtime : voir exactement avec quels workers, fournisseurs et ports votre moteur fonctionne. |
| **Flow** | (Optionnel, `--enable-flow`) Graphe d'architecture interactif de chaque worker, trigger et stream. |
Traces : waterfall / flame / répartition par service pour chaque opération de mémoire.
**Les traces sont déjà activées :**
`iii-config.yaml` est livré avec le worker `iii-observability` activé (`exporter: memory`, `sampling_ratio: 0.1`, métriques + logs). Aucune configuration supplémentaire nécessaire ; dès qu'agentmemory démarre, chaque opération de mémoire émet un log structuré que la console peut lire, et une sur dix (`sampling_ratio: 0.1`) émet aussi un span de trace.
Si vous voulez exporter vers Jaeger/Honeycomb/Grafana Tempo à la place, changez `exporter: memory` en `exporter: otlp` et définissez l'endpoint du collecteur selon la documentation observability d'iii.
> **Important :** aucune authentification n'est appliquée sur la console elle-même ; gardez-la liée à `127.0.0.1` (le défaut) et ne l'exposez jamais publiquement.
---
agentmemory est **déjà une instance [iii](https://iii.dev) en cours d'exécution**. Trois primitives (worker, fonction, trigger) composent le runtime ; l'état KV, les streams et les traces OTEL viennent des workers iii-state, iii-stream et iii-observability livrés avec iii. Vous n'avez pas installé Postgres, Redis, Express, pm2 ou Prometheus, parce que iii les remplace.
Cela signifie qu'une seule commande supplémentaire étend agentmemory avec une toute nouvelle capacité.
### Étendre agentmemory avec plus de workers
Les builtins dont agentmemory a besoin sont déjà dans `iii-config.yaml` et démarrent avec lui : `iii-state` (KV), `iii-queue` (retries durables pour les abonnés aux événements), `iii-pubsub`, `iii-cron`, `iii-stream`, et `iii-observability` (traces, métriques et logs OTEL sur chaque fonction). Tout le reste depuis le [registre de workers iii](https://workers.iii.dev) se branche sur le même moteur : copiez `iii-config.yaml` vers `~/.agentmemory/iii-config.yaml` (la CLI préfère ce fichier au fichier embarqué et y rend quand même les ports et les chemins de données), ajoutez l'entrée, installez le runtime du worker une fois avec `~/.agentmemory/bin/iii update worker`, et redémarrez agentmemory.
```yaml
workers:
# ...the bundled entries...
- name: database # SQL-backed state adapter when you outgrow the KV defaults
- name: iii-sandbox # run code that came out of memory_recall inside a throwaway VM
- name: mcp # extra MCP servers next to agentmemory's, same engine
```
| Worker | Ce que vous obtenez en plus d'agentmemory |
|---|---|
| [`database`](https://workers.iii.dev/workers/database) | Adaptateur d'état adossé à SQL quand vous dépassez les défauts KV en mémoire |
| [`iii-sandbox`](https://workers.iii.dev/workers/iii-sandbox) | Le code issu de `memory_recall` tourne dans une VM jetable, pas dans votre shell |
| [`mcp`](https://workers.iii.dev/workers/mcp) | Monter des serveurs MCP supplémentaires à côté de celui d'agentmemory, partageant le même moteur |
Sur le moteur 0.22.x, gardez les noms préfixés `iii-` pour les builtins ci-dessus ; les entrées sans préfixe `http`, `state`, `queue`, `pubsub` et `cron` sont les workers du registre standalone vers lesquels agentmemory migre avec la 0.23.
Registre complet : [workers.iii.dev](https://workers.iii.dev). Chaque worker qui y figure se compose via les mêmes primitives qu'utilise agentmemory, et l'agentmemory que vous avez déjà en est un.
### Configuration du moteur et adresse de liaison
`agentmemory start` lit la config du moteur depuis le premier fichier existant : `AGENTMEMORY_III_CONFIG`, `./iii-config.yaml` dans le répertoire courant, `~/.agentmemory/iii-config.yaml`, puis le `iii-config.yaml` embarqué. À chaque démarrage, il rend ce fichier (chemins de données, ports, backend d'état) dans `~/.agentmemory/data/iii-config.runtime.yaml` et lance le moteur avec la copie rendue, donc éditez le fichier source, pas le fichier rendu. Les valeurs `host:` du fichier source sont conservées telles qu'écrites.
Le `iii-config.yaml` embarqué se lie à `127.0.0.1` intentionnellement, et ce défaut s'applique aussi à l'intérieur d'un conteneur. Une CLI démarrée dans un conteneur écoute sur le loopback du conteneur, donc les ports publiés n'atteignent rien. Pour servir une CLI conteneurisée via des ports publiés, définissez `AGENTMEMORY_III_CONFIG` vers une config qui se lie à `0.0.0.0`. Le `iii-config.docker.yaml` packagé en est une : il lie `iii-http`, `iii-stream` et le port du moteur à `0.0.0.0` et stocke l'état sous `/data`, donc montez un volume accessible en écriture là. Gardez `AGENTMEMORY_SECRET` défini, et ne publiez que les ports dont vous avez besoin, sur `127.0.0.1` ou derrière un proxy de confiance.
Le `docker-compose.yml` de ce dépôt ne passe pas par la recherche de config de la CLI : il monte `iii-config.docker.yaml` sur `/app/config.yaml`, et le conteneur `iii-engine` démarre avec `--config /app/config.yaml`. Les [templates de déploiement](../deploy/) en un clic écrivent leur propre config `0.0.0.0` dans leurs points d'entrée.
### Backend de stockage : fichier (défaut) vs redis
`iii-state` et `iii-stream` utilisent par défaut le store KV embarqué d'iii-engine basé sur fichiers : un fichier JSON par scope, maintenu en mémoire dans le processus du moteur et réécrit sur disque à intervalle régulier. C'est le bon défaut pour une installation locale mono-utilisateur ; un daemon partagé avec plusieurs écrivains concurrents obtient de vraies écritures par clé depuis Redis à la place, au prix d'un aller-retour réseau par opération (chaque appel `state::*` se sérialise toujours sur une connexion Redis, donc cela échange le verrou du store fichier contre un socket, pas contre du parallélisme).
Définissez `AGENTMEMORY_STATE_BACKEND=redis` (plus `AGENTMEMORY_REDIS_URL`) pour faire passer les deux workers à l'adaptateur `redis` intégré d'iii-engine, qui stocke chaque clé comme un champ de hash Redis (`HSET`) plutôt que de réécrire tout un scope à chaque écriture :
```env
# ~/.agentmemory/.env
AGENTMEMORY_STATE_BACKEND=redis
AGENTMEMORY_REDIS_URL=redis://localhost:6379
```
`AGENTMEMORY_STATE_BACKEND` a pour défaut `file` ; le laisser non défini garde le comportement actuel inchangé, et une valeur non reconnue (autre que `file` ou `redis`) est une erreur de démarrage plutôt qu'un repli silencieux. `/agentmemory/status` et la page Health du visualiseur (la ligne State store) indiquent quel backend est actif et s'il répond, jamais l'URL.
**Uniquement `redis://` en clair.** Le moteur épinglé (0.22.1) construit son client Redis sans support TLS, donc une URL `rediss://` (la plupart des offres Redis managées, comme Upstash, Redis Cloud, et ElastiCache avec chiffrement en transit, sont TLS uniquement par défaut) échoue à se connecter. La connexion n'est pas chiffrée, donc le mot de passe Redis et chaque mémoire stockée traversent le réseau en clair : pointez vers un Redis local ou sur un réseau privé de confiance. Pour tout autre Redis, exécutez un tunnel chiffré (stunnel, SSH, ou un VPN) sur l'hôte agentmemory, pour que le hop `redis://` en clair reste sur cet hôte et que la connexion amont du tunnel soit chiffrée et authentifiée. Si un mot de passe Redis contient une apostrophe, encodez-la en pourcentage (`%27`) ; le moteur développe l'URL dans sa config YAML avant de la parser.
**Un serveur Redis par `--instance`.** Les préfixes de clé Redis du moteur (`state:`, `stream::`) sont fixes, donc deux instances agentmemory (`--instance 1`, `--instance 2`, ...) pointant vers la même base de données écrasent mutuellement leurs données. Un index de base de données séparé (`redis://localhost:6379/1`) garde les données stockées séparées, mais le moteur relaie les événements du visualiseur en direct sur un seul canal pub/sub Redis (`stream::events`), et le pub/sub Redis ignore l'index de base de données, donc le visualiseur de chaque instance afficherait toujours les événements en direct de l'autre. Donnez à chaque instance son propre serveur Redis (ou port) quand vous en faites tourner plus d'une.
**Ce qui reste identique, et ce qui diffère.** Chaque fonctionnalité d'agentmemory fonctionne sur Redis : sessions, observations, mémoires (remember, supersede, evolve, forget), recherche et les buckets d'index, lessons, le graphe, le journal d'audit et ses scopes mensuels, export et import, suppressions de gouvernance, statut de consolidation, le snapshot du visualiseur et son stream en direct, et le moniteur de santé. Le moteur stocke chaque scope comme un seul hash Redis (`HSET`/`HGET`/`HGETALL`) et déclenche les mêmes triggers d'état que le store fichier. Trois différences du moteur sont gérées à l'intérieur d'agentmemory :
- Redis retourne les enregistrements d'un scope sans ordre fixe. agentmemory les trie du plus ancien au plus récent (par l'heure de création dans l'id de l'enregistrement, puis son timestamp) pour que les listes, la pagination et les chunks d'export reviennent dans le même ordre que sur le store fichier.
- Le moteur applique les mises à jour partielles sur Redis dans un script Lua qui transforme les tableaux vides en objets vides. agentmemory applique lui-même ces mises à jour (lire, modifier, écrire sous un verrou par clé) sur Redis, pour que des champs comme `tags: []` restent des tableaux.
- La vérification du journal d'audit legacy lit l'ancien scope depuis Redis au lieu de chercher le fichier du store fichier sur disque.
Une différence demande votre attention : **après un redémarrage de Redis, le moteur arrête de relayer les événements en direct** vers le visualiseur jusqu'à ce qu'agentmemory redémarre. Les données sont toujours sauvegardées et lues normalement. Le moniteur de santé envoie un événement de test via Redis toutes les 30 secondes ; quand il ne revient pas, `/agentmemory/status` et la page Health du visualiseur affichent « Les mises à jour en direct n'atteignent pas le visualiseur » avec le correctif : redémarrer agentmemory. Si Redis est en panne, le rapport de statut affiche « Le state store ne répond pas » et comment le vérifier (`redis-cli -u "$AGENTMEMORY_REDIS_URL" ping`). Lister un très grand scope lit tout le hash en un seul `HGETALL`, le même coût que le store fichier le gardant en mémoire.
**Réglages Redis recommandés.** La politique de snapshot par défaut `save 3600 1 300 100 60 10000` peut perdre des minutes d'écritures en cas de crash, pire que la fenêtre de flush de 5s du store fichier. Définissez `appendonly yes` pour tout ce que vous regretteriez de perdre. Définissez `maxmemory-policy noeviction` ; `allkeys-lru` ou similaire abandonne silencieusement des mémoires une fois que Redis atteint sa limite mémoire.
Un démarrage natif (non-Docker), et chaque [template de déploiement](../deploy/) en un clic (ils remplacent le `iii-config.yaml` embarqué et démarrent nativement), lisent `AGENTMEMORY_STATE_BACKEND`/`AGENTMEMORY_REDIS_URL` et les rendent dans la `iii-config` lancée. L'URL elle-même n'est jamais écrite dans ce fichier rendu, seulement une référence `${AGENTMEMORY_REDIS_URL}` que le processus moteur développe depuis son propre environnement au démarrage. Seul le chemin Docker Compose de ce dépôt (`AGENTMEMORY_USE_DOCKER=1`, ou la reprise d'un moteur déjà démarré ainsi) monte `iii-config.docker.yaml` en lecture seule et ne rend jamais ; `agentmemory start` avertit quand il détecte cette combinaison. Changez ce fichier à la main, en suivant la même forme `name: redis` / `config: redis_url: ...` montrée dans la documentation des workers [iii-state](https://workers.iii.dev/workers/iii-state) et [iii-stream](https://workers.iii.dev/workers/iii-stream), et pointez `redis_url` vers un Redis accessible depuis le conteneur. `docker-compose.yml` transmet `AGENTMEMORY_REDIS_URL` au conteneur du moteur, donc `redis_url: '${AGENTMEMORY_REDIS_URL}'` y fonctionne et garde l'URL hors du fichier monté.
La config rendue garde l'URL hors de `~/.agentmemory/data/iii-config.runtime.yaml`, mais le worker de configuration du moteur lui-même persiste quand même la valeur *développée* dans `~/.agentmemory/config/iii-state.yaml` et `iii-stream.yaml` une fois démarré (l'expansion `${VAR}` d'iii-engine se produit avant que ce worker ne stocke sa graine, et il stocke la valeur résolue, pas la référence). Traitez ce répertoire comme contenant une credential : `chmod 700 ~/.agentmemory` sur tout hôte partagé, et préférez un utilisateur ACL Redis scopé à ce dont agentmemory a besoin plutôt que les credentials admin de la base de données.
**La migration n'est pas automatique.** Changer `AGENTMEMORY_STATE_BACKEND` démarre d'un store vide des deux côtés ; rien ne copie les données existantes du fichier vers Redis ou inversement. Exportez depuis le backend que vous quittez et importez dans celui vers lequel vous allez. Ceci fonctionne identiquement sous bash et zsh (y compris `bash -u`). Un tableau comme `AUTH=(${AGENTMEMORY_SECRET:+-H "Authorization: Bearer $AGENTMEMORY_SECRET"})` ne fonctionne pas : zsh garde l'en-tête comme un seul mot malformé là où bash le scinde en deux, donc les deux requêtes reçoivent 401 chaque fois que `AGENTMEMORY_SECRET` est défini :
```bash
# 0. Use the generated secret when none is exported:
AGENTMEMORY_SECRET="${AGENTMEMORY_SECRET:-$(cat ~/.agentmemory/secret 2>/dev/null)}"
# 1. On the old backend, while agentmemory is still running on it:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" http://localhost:3111/agentmemory/export > backup.json
else
curl -fsS http://localhost:3111/agentmemory/export > backup.json
fi
# 2. Confirm backup.json is a usable export before switching backends:
jq -e '.version and .exportedAt' backup.json > /dev/null || {
echo "backup.json is not a valid export; do not switch backends" >&2
exit 1
}
# 3. Switch AGENTMEMORY_STATE_BACKEND (and AGENTMEMORY_REDIS_URL if needed),
# restart agentmemory against the new backend, then:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
else
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
fi
```
`/agentmemory/export` accepte aussi `?maxSessions=` et `?offset=` pour fragmenter un gros corpus sur plusieurs appels ; `strategy` à l'import vaut `merge` (sûr par défaut), `replace`, ou `skip`.
### Ce que iii remplace
| Stack traditionnelle | agentmemory utilise |
|---|---|
| Express.js / Fastify | iii HTTP Triggers |
| SQLite / Postgres + pgvector | iii KV State + index vectoriel en mémoire |
| SSE / Socket.io | iii Streams (WebSocket) |
| pm2 / systemd | Supervision des workers du moteur iii |
| Prometheus / Grafana | iii OTEL + moniteur de santé |
| Systèmes de plugins custom | `iii worker add ` |
**219 fichiers sources · ~52,000 LOC · 2,500+ tests · 311 fonctions · 60 scopes KV**, tout sur trois primitives. Pas de `agentmemory plugin install`. Le système de plugins, c'est iii lui-même.
---
### Fournisseurs LLM
agentmemory auto-détecte les fournisseurs depuis votre environnement. Un fournisseur rend disponibles les opérations adossées à un LLM, mais la seule configuration d'un fournisseur n'active pas la compression d'observation rédigée par LLM. Ce chemin requiert à la fois un fournisseur et `AGENTMEMORY_AUTO_COMPRESS=true`.
| Fournisseur | Config | Notes |
|----------|--------|-------|
| **No-op (défaut)** | Aucune config nécessaire | La compression/synthèse adossée à un LLM est désactivée. La compression synthétique et le recall BM25 fonctionnent toujours. Voir `AGENTMEMORY_ALLOW_AGENT_SDK` ci-dessous si vous comptiez sur le repli par abonnement Claude. |
| API Anthropic | `ANTHROPIC_API_KEY` | Facturation au token |
| MiniMax | `MINIMAX_API_KEY` | Compatible Anthropic |
| Gemini | `GEMINI_API_KEY` | Active aussi les embeddings |
| OpenRouter | `OPENROUTER_API_KEY` | N'importe quel modèle |
| API OpenAI | `OPENAI_API_KEY` | Défaut `gpt-5.6-luna`, remplacer avec `OPENAI_MODEL` |
| **Local (Ollama / LM Studio / vLLM / llama.cpp)** | `OPENAI_API_KEY=local` + `OPENAI_BASE_URL=http://localhost:11434/v1` (Ollama) ou `http://localhost:1234/v1` (LM Studio) + `OPENAI_MODEL=` | Tout ce qui est compatible avec l'API OpenAI. Coût nul, tourne sur votre matériel. Voir [Modèles locaux](#local-models-ollama--lm-studio--vllm) ci-dessous. |
| Repli par abonnement Claude | `AGENTMEMORY_ALLOW_AGENT_SDK=true` | Opt-in uniquement. Lance des sessions `@anthropic-ai/claude-agent-sdk` ; cela provoquait auparavant une récursion illimitée du hook Stop, donc ce n'est plus le défaut. |
### Modèles locaux (Ollama / LM Studio / vLLM)
agentmemory parle à n'importe quel serveur compatible API OpenAI, donc tout ce qui expose `/v1/chat/completions` fonctionne sans changement de code. Pas de clés payantes, pas de cloud, pas de limites de débit ; tourne entièrement sur votre matériel.
**Ollama** (port par défaut `11434`) :
```bash
ollama pull qwen3:8b # or qwen3:4b, gpt-oss:20b, qwen3-coder:30b, etc.
ollama serve
```
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=ollama # any non-empty string; Ollama ignores it
OPENAI_BASE_URL=http://localhost:11434/v1
OPENAI_MODEL=qwen3:8b
```
**LM Studio** (port par défaut `1234`) :
Ouvrez LM Studio → onglet Local Server → Start Server. Choisissez n'importe quel modèle de chat dans le sélecteur (Qwen 3, gpt-oss, DeepSeek R1, etc.).
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=lmstudio # any non-empty string; LM Studio ignores it
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_MODEL=qwen3-8b # match the model name from LM Studio
```
**vLLM / llama.cpp / Text Generation Inference** : même forme. Pointez `OPENAI_BASE_URL` vers l'URL exposée par votre serveur et définissez `OPENAI_MODEL` avec un nom que votre serveur acceptera.
**Choix de modèle pour le travail de mémoire** : la compression et la synthèse sont des tâches courtes (<2K tokens en entrée, <500 tokens en sortie) où un modèle instruct de 7B suffit largement. Recommandations :
| Modèle | Taille | Pourquoi |
|-------|------|-----|
| `qwen3:8b` | ~5.2 Go | Défaut équilibré sur une machine à 16 Go ; solide en extraction et en texte orienté outils |
| `qwen3:4b` | ~2.6 Go | Plus petite option raisonnable ; bien pour la compression, plus faible pour l'extraction de graphe |
| `qwen3-coder:30b` | ~19 Go | Meilleur choix local pour les sessions orientées code (30B MoE, 3.3B actifs) sur du matériel 24-32 Go |
| `gpt-oss:20b` | ~14 Go | Modèle général solide qui tient dans 16 Go de RAM |
| `deepseek-r1:8b` | ~5.2 Go | Distillation de raisonnement ; plus lent mais extractions plus propres |
Les modèles Qwen 3 réfléchissent par défaut et peuvent consommer tout le budget de tokens en raisonnement avant toute sortie. Définissez `AGENTMEMORY_LLM_NOTHINK=1` pour ajouter `/no_think` aux prompts d'extraction de graphe, et augmentez `MAX_TOKENS` (16384 fonctionne) si les extractions reviennent vides.
Les modèles de la classe raisonnement (style `o1` avec blocs ``) peuvent retourner un `content` vide avec un champ `reasoning` que votre serveur local peut ne pas exposer. Si les extractions reviennent vides, basculez d'abord vers un modèle non-raisonnement. La variable d'env `OPENAI_REASONING_EFFORT=none` peut aussi désactiver le thinking sur les modèles de réflexion d'Ollama Cloud qui reflètent le schéma de raisonnement OpenAI.
Les embeddings locaux sont livrés comme dépendance optionnelle mais ne sont pas activés par défaut. Définissez `EMBEDDING_PROVIDER=local` pour opter pour `Xenova/all-MiniLM-L6-v2` (384 dims). La première requête d'embedding télécharge le modèle ; l'inférence se fait ensuite sur l'appareil. Sans ce réglage ni une clé d'embedding distante, les vecteurs restent désactivés, `mem::search` utilise BM25, et `smart-search` peut toujours ajouter des correspondances de graphe existantes.
### Sélection de modèle sensible au coût
Quand la compression en arrière-plan rédigée par LLM est activée avec à la fois un fournisseur et `AGENTMEMORY_AUTO_COMPRESS=true`, elle tourne sur chaque observation, donc le choix du modèle change significativement la dépense mensuelle. Données de charge capturées : 635 requêtes / 888K tokens / 35 heures d'usage actif, exécutées contre trois modèles OpenRouter au tarif du 2026-05-23.
| Palier | Modèle | Entrée / 1M | Sortie / 1M | Coût pour les 35h capturées | Notes |
|------|-------|------------|-------------|---------------------------|-------|
| Recommandé | `deepseek/deepseek-v4-flash-0731` | 0.07 $ | 0.14 $ | ~0.07 $ (est.) | DeepSeek le plus récent ; choix recommandé le moins cher pour les workloads de compression. |
| Recommandé | `deepseek/deepseek-v4-pro` | 0.435 $ | 0.87 $ | ~0.46 $ | Qualité solide de compression + synthèse à ~10× moins cher que Sonnet. |
| Recommandé | `qwen/qwen3-coder` | 0.45 $ | 1.80 $ | ~0.55 $ | Raisonnement code solide si vos sessions sont fortement orientées code. |
| Premium | `anthropic/claude-sonnet-5` | 3.00 $ | 15.00 $ | ~5.02 $ (est.) | Même tarif catalogue que le run Sonnet 4.6 mesuré ; tarif de lancement 2 $/10 $ jusqu'au 2026-08-31. |
| Premium | `openai/gpt-5.6-sol` | 5.00 $ | 30.00 $ | ~9 $ (est.) | Palier flagship ; coûteux pour du travail en arrière-plan permanent. |
| À éviter | `anthropic/claude-opus-5` | 5.00 $ | 25.00 $ | ~8.40 $ (est.) | Modèle de classe flagship ; surdimensionné pour la compression. |
Les lignes mesurées viennent du run capturé ; les lignes (est.) extrapolent le même mix de tokens selon le tarif catalogue de chaque modèle.
agentmemory affiche un avertissement runtime quand `OPENROUTER_MODEL` correspond à un pattern de palier premium. Définissez `AGENTMEMORY_SUPPRESS_COST_WARNING=1` pour le faire taire une fois votre choix fait en connaissance de cause.
Compromis qualité/coût pour le travail de mémoire : la compression est une tâche de synthèse avec des barres de qualité relativement souples (l'agent relit le résumé, pas l'utilisateur). DeepSeek V4 Flash / V4 Pro / Qwen3-Coder atterrissent à la marge d'erreur de Sonnet sur cette tâche en coûtant 10-70× moins. Gardez les modèles de palier premium pour les requêtes que vous lisez directement.
Sources : [tarif OpenRouter pour Claude Sonnet 5](https://openrouter.ai/anthropic/claude-sonnet-5), [DeepSeek V4 Flash](https://openrouter.ai/deepseek/deepseek-v4-flash-0731), [notes de tarification DeepSeek](https://api-docs.deepseek.com/quick_start/pricing/).
### Mémoire multi-agent (`AGENT_ID` + `AGENTMEMORY_AGENT_SCOPE`)
Dans les configurations multi-agents où plusieurs rôles partagent un seul serveur agentmemory (architecte / développeur / reviewer / chercheur / agent-support), `AGENT_ID` marque chaque écriture avec le rôle qui l'a faite. `AGENTMEMORY_AGENT_SCOPE` contrôle si le recall filtre par ce tag.
```env
TEAM_ID=company
USER_ID=engineering-team
AGENT_ID=architect
AGENTMEMORY_AGENT_SCOPE=isolated # optional; default "shared"
```
Deux modes :
| Mode | Marque les écritures | Filtre le recall | Quand l'utiliser |
|------|------------|---------------|-------------|
| `shared` (défaut) | oui | non | Contexte inter-agent avec piste d'audit. L'architecte peut voir ce que le développeur a noté, mais chaque ligne enregistre qui l'a dit. |
| `isolated` | oui | oui | Séparation stricte. L'architecte ne voit jamais les observations / mémoires / sessions du développeur. |
Ce qui est marqué quand `AGENT_ID` est défini : `Session.agentId`, `RawObservation.agentId`, `CompressedObservation.agentId`, `Memory.agentId`. Le rôle circule depuis `api::session::start` → `mem::observe` → `mem::compress` → KV.
Ce qui est filtré en mode isolé : `mem::smart-search`, `/agentmemory/memories`, `/agentmemory/observations`, `/agentmemory/sessions`. Chaque endpoint accepte `?agentId=` pour surcharger par requête, et `?agentId=*` pour sortir complètement du scope de l'env. `/memories` accepte aussi `?includeOrphans=true` pour faire apparaître les mémoires pré-AGENT_ID dont `agentId` est indéfini.
Surcharge par appel au niveau SDK / REST : chaque endpoint de mutation (`/session/start`, `/remember`) accepte un champ `agentId` dans le corps de requête qui prime sur l'env. Utile pour les runtimes qui font passer plusieurs rôles par un seul processus serveur. L'outil MCP `memory_save` expose le même champ `agentId`, le serveur stdio standalone transmet à la fois `agentId` et `project`, et les mémoires sauvegardées portent `agentId` dans l'index de recherche, donc la recherche scopée par agent couvre les mémoires aussi bien que les observations.
Quand `AGENT_ID` n'est pas défini, la mémoire reste non scopée (comportement legacy, pas de tags, pas de filtres).
### Ports
agentmemory + iii-engine lient quatre ports par défaut. Si un redémarrage échoue avec `port in use`, ce tableau vous indique quel processus chercher.
| Port | Processus | Usage | Surcharge via env |
|------|---------|---------|--------------|
| `3111` | agentmemory | API REST + MCP HTTP + `/agentmemory/health` + `/agentmemory/livez` | `III_REST_PORT` |
| `3112` | iii-engine | Worker interne de streams (consommé par agentmemory + le visualiseur) | `III_STREAM_PORT` (préféré) ou `III_STREAMS_PORT` (legacy) |
| `3113` | agentmemory | Visualiseur temps réel (`http://localhost:3113`) | `III_VIEWER_PORT` ou `AGENTMEMORY_VIEWER_URL` pour l'URL rapportée |
| `49134` | iii-engine | WebSocket ; les workers s'y enregistrent, la télémétrie OTel y circule | `III_ENGINE_PORT` ou `III_ENGINE_URL` |
`--port ` change l'ancre REST et dérive streams `N+1`, visualiseur `N+2`, et WebSocket du moteur `N+46023` uniquement là où le port ou l'URL explicite correspondant ci-dessus n'est pas défini. Cela ne crée pas un namespace de cycle de vie isolé. Utilisez `--instance 1` pour un second daemon ; il utilise l'ancre 3211, par défaut `3211/3212/3213/49234`, et reçoit un répertoire de données et de cycle de vie `instance-1` séparé. Les instances 1 à 50 suivent le même modèle.
Le moteur épinglé démarre avec `--no-update-check` (aucune recherche de mise à jour ou d'avis de sécurité contre GitHub au démarrage) et avec la télémétrie d'usage anonyme d'iii désactivée : agentmemory définit `III_TELEMETRY_ENABLED=false` pour le moteur qu'il lance sauf si vous exportez la variable vous-même, et le fichier compose embarqué fait de même.
Nettoyage des processus périmés quand les ports restent liés après une exécution plantée :
```bash
# macOS / Linux — find whatever is on each port and kill it
lsof -i :3111,3112,3113,49134
pkill -f agentmemory || true
pkill -f 'iii ' || true
# Windows
netstat -ano | findstr ":3111 :3112 :3113 :49134"
taskkill /F /PID
```
`agentmemory stop` récupère proprement à la fois le worker et le pidfile du moteur lors d'un arrêt natif propre. En mode Docker, il vide le worker natif, arrête exactement le conteneur du moteur validé, et préserve à la fois le conteneur et son montage `/data` pour un redémarrage sans perte ; le prochain démarrage valide et reprend ce même conteneur. La désinstallation adossée à Docker requiert `agentmemory remove --keep-data` : elle supprime les fichiers partagés gérés par agentmemory tout en préservant le conteneur validé, son montage de données, et l'enregistrement de cycle de vie nécessaire pour les récupérer. La suppression destructive des données Docker est intentionnellement laissée à l'opérateur après une sauvegarde. La CLI refuse aussi d'adopter ou de signaler les détenteurs de port Docker ou VM (backend Docker, vpnkit, colima) comme le moteur natif sauf si `--force` est passé. Le nettoyage manuel ci-dessus ne concerne que le cas post-crash où aucun des deux pidfiles n'a été laissé.
### Fichier de config
Placez la configuration runtime d'agentmemory dans `~/.agentmemory/.env` plutôt que d'exporter des variables dans chaque shell. Si le visualiseur affiche un indice de setup comme `export ANTHROPIC_API_KEY=...`, copiez-le dans ce fichier sous la forme `ANTHROPIC_API_KEY=...` sans le préfixe `export`, puis redémarrez agentmemory.
Les variables d'environnement du processus fonctionnent toujours et priment sur les valeurs du fichier.
Sur Windows, le même fichier se trouve à `%USERPROFILE%\.agentmemory\.env` :
```powershell
New-Item -ItemType Directory -Force $HOME\.agentmemory
notepad $HOME\.agentmemory\.env
```
Pour tester avec un abonnement Claude Code Pro/Max plutôt qu'une clé API, optez-y explicitement :
```env
AGENTMEMORY_ALLOW_AGENT_SDK=true
AGENTMEMORY_AUTO_COMPRESS=true
```
La compression d'observation rédigée par LLM requiert les deux lignes : l'accès à un fournisseur LLM (y compris ce repli d'abonnement explicite) et `AGENTMEMORY_AUTO_COMPRESS=true`. Un fournisseur seul laisse en place le chemin de compression synthétique par défaut.
La consolidation (nœuds de graphe, lessons, crystals) est activée par défaut dès qu'un fournisseur LLM est configuré. Désactivez-la explicitement avec `CONSOLIDATION_ENABLED=false` si vous voulez un fonctionnement sans LLM. L'extraction de graphe est un flag séparé :
```env
GRAPH_EXTRACTION_ENABLED=true
# CONSOLIDATION_ENABLED=false # opt out of auto-consolidation
```
### Variables d'environnement
Créez `~/.agentmemory/.env` :
```env
# LLM provider (pick one — default is the no-op provider: no LLM calls)
# ANTHROPIC_API_KEY=sk-ant-...
# ANTHROPIC_BASE_URL=... # Optional: Anthropic-compatible proxy / Azure
# GEMINI_API_KEY=...
# OPENROUTER_API_KEY=...
# MINIMAX_API_KEY=...
# OPENAI_API_KEY=*** # NOTE: this same key auto-activates BOTH the
# # OpenAI LLM provider (here) AND the OpenAI
# # embedding provider (further below). Set
# # OPENAI_API_KEY_FOR_LLM=false to scope it
# # to embeddings only.
# OPENAI_BASE_URL=https://api.openai.com # Optional: override for Azure / vLLM / LM Studio / proxies
# # Azure: https://.openai.azure.com/openai/deployments/
# # Auto-detected from `.openai.azure.com` hostname; uses
# # api-key header + api-version query param.
# OPENAI_API_VERSION=2024-08-01-preview # Optional: Azure api-version query param
# OPENAI_MODEL=gpt-5.6-luna # Optional: default model
# OPENAI_TIMEOUT_MS=60000 # Optional: OpenAI-scoped alias for the outbound fetch
# # timeout. Takes precedence over AGENTMEMORY_LLM_TIMEOUT_MS
# # for back-compat with v0.9.17. New configs should
# # prefer the global AGENTMEMORY_LLM_TIMEOUT_MS below.
# OPENAI_REASONING_EFFORT=none # Optional: "low" | "medium" | "high" | "none"
# # Honored only by OpenAI's reasoning models (o1, o3,
# # gpt-*-reasoning) and providers that mirror that
# # schema (Ollama Cloud thinking models). Standard
# # chat models reject this field with 400. Set to
# # "none" for thinking models that return reasoning
# # but no content.
# OPENAI_API_KEY_FOR_LLM=false # Optional: set to false to skip OpenAI auto-detection
# # for LLM (useful if you only want OpenAI for embeddings)
# Opt-in Claude-subscription fallback (spawns @anthropic-ai/claude-agent-sdk);
# leave OFF unless you understand the Stop-hook recursion risk:
# AGENTMEMORY_ALLOW_AGENT_SDK=true
# Embedding provider (BM25-only when unset; local is an explicit opt-in)
# EMBEDDING_PROVIDER=local
# VOYAGE_API_KEY=...
# OPENAI_API_KEY=sk-...
# OPENAI_BASE_URL=https://api.openai.com # Override for Azure / vLLM / LM Studio / proxies
# OPENAI_EMBEDDING_MODEL=text-embedding-3-small
# OPENAI_EMBEDDING_DIMENSIONS=1536 # Required when the model is not in the known-models table
# OPENAI_EMBEDDING_BASE_URL=https://... # Embeddings only; falls back to OPENAI_BASE_URL
# OPENAI_EMBEDDING_API_KEY=sk-... # Embeddings only; wins over OPENAI_API_KEY when set
# Outbound LLM / embedding timeout
# AGENTMEMORY_LLM_TIMEOUT_MS=60000 # Default: 60 000 ms (60 s). Applies to every
# raw-fetch provider (Gemini, OpenRouter, MiniMax,
# OpenAI LLM, OpenAI/Cohere/Voyage/OpenRouter
# embedding). For the OpenAI LLM path, the
# OpenAI-scoped OPENAI_TIMEOUT_MS alias (above)
# takes precedence when set, for back-compat
# with v0.9.17.
# Increase for slow networks or large batch calls;
# decrease to fail-fast on rate-limit holds.
# Search tuning
# BM25_WEIGHT=0.4
# VECTOR_WEIGHT=0.6
# TOKEN_BUDGET=2000
# Auth (generated into ~/.agentmemory/secret on first start when unset)
# AGENTMEMORY_SECRET=your-secret
# VIEWER_ALLOWED_ORIGINS=https://memory.example.com
# AGENTMEMORY_IMPORT_ROOT=~/projects
# Ports (defaults: 3111 API, 3113 viewer)
# III_REST_PORT=3111
# Engine usage telemetry (iii). Off unless you set it; true opts in.
# III_TELEMETRY_ENABLED=false
# Features
# AGENTMEMORY_AUTO_COMPRESS=false # OFF by default. Requires an LLM
# provider as well. When both are on,
# every PostToolUse hook calls your
# LLM provider to compress the
# observation — expect significant
# token spend on active sessions.
# AGENTMEMORY_SLOTS=false # OFF by default. Editable pinned
# memory slots — persona,
# user_preferences, tool_guidelines,
# project_context, guidance,
# pending_items, session_patterns,
# self_notes. Size-limited; agent
# edits via memory_slot_* tools.
# Pinned slots addressable for
# SessionStart injection.
# AGENTMEMORY_REFLECT=false # OFF by default. Requires SLOTS=on.
# Stop hook fires mem::slot-reflect:
# scans recent observations, auto-
# appends TODOs to pending_items,
# counts patterns in
# session_patterns, records touched
# files in project_context. Fire-
# and-forget; does not block.
# AGENTMEMORY_INJECT_CONTEXT=false # OFF by default. When on:
# - SessionStart may inject ~1-2K
# chars of project context into
# the first turn of each session
# (this is what actually reaches
# the model — Claude Code treats
# SessionStart stdout as context)
# - PreToolUse fires /agentmemory/enrich
# on every file-touching tool call
# (resource cleanup, not a token
# fix — PreToolUse stdout is debug
# log only per Claude Code docs)
# Observations are still captured via
# PostToolUse regardless of this flag.
# GRAPH_EXTRACTION_ENABLED=false
# AGENTMEMORY_LLM_NOTHINK=1 # Local reasoning models only: ask the
# model to skip its hidden thinking pass
# during graph extraction. Faster runs;
# relation quality can drop slightly.
# CONSOLIDATION_ENABLED=false # on by default when an LLM provider is configured
# LESSON_DECAY_ENABLED=true
# OBSIDIAN_AUTO_EXPORT=false
# AGENTMEMORY_EXPORT_ROOT=~/.agentmemory
# CLAUDE_MEMORY_BRIDGE=false
# SNAPSHOT_ENABLED=false
# Storage and durability
# AGENTMEMORY_STATE_BACKEND=file # file (default) or redis; see "Storage backend" below
# AGENTMEMORY_REDIS_URL=redis://localhost:6379 # Required with redis, plain redis:// only
# AGENTMEMORY_STATE_SAVE_INTERVAL_MS=2000 # How often the engine writes file state to disk.
# A hard kill loses at most this window.
# AGENTMEMORY_INDEX_SAVE_INTERVAL_MS=600000 # Minimum time between search index saves;
# shutdown and deletes still save at once.
# AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=true # One-time background trim of oversized graph
# provenance; false skips it
# Sessions
# AGENTMEMORY_SESSION_SWEEP_ENABLED=true # Hourly sweep marks sessions left active past
# the threshold as abandoned. Deletes nothing;
# new activity makes the session active again.
# AGENTMEMORY_SESSION_SWEEP_STALE_HOURS=24
# Capture filters (hooks)
# AGENTMEMORY_CAPTURE_ALLOW= # Comma or space list of tool names or globs;
# when set, only these tools are captured
# AGENTMEMORY_CAPTURE_DENY= # Extra names or globs to skip, added to the
# defaults: memory_*, toolsearch,
# listmcpresources, fetchmcpresource
# AGENTMEMORY_CAPTURE_OUTPUT_MAX=8000 # Max characters of tool output per observation
# AGENTMEMORY_PRE_COMPACT_BUDGET=1500 # Token budget for PreCompact context; 0 disables
# Audit log
# AGENTMEMORY_AUDIT_RETENTION_MONTHS=0 # Drop month scopes older than N months; 0 keeps all
# AGENTMEMORY_AUDIT_INDEX_PERSIST=false # 1 or true records index migration and cleanup
# rows (debugging only)
# Team
# TEAM_ID=
# USER_ID=
# TEAM_MODE=private
# Tool visibility: "all" (54 tools, default) or "core" (8 tools, lean)
# AGENTMEMORY_TOOLS=core
```
---
138 endpoints sur le port `3111`. L'API REST se lie à `127.0.0.1` par défaut. Les endpoints protégés requièrent `Authorization: Bearer `, et les endpoints de mesh sync requièrent un `AGENTMEMORY_SECRET` explicitement défini sur les deux pairs.
**L'authentification est activée par défaut.** Quand `AGENTMEMORY_SECRET` n'est pas défini (dans le shell ou dans `~/.agentmemory/.env`), le serveur génère un secret aléatoire au premier démarrage et le stocke dans `~/.agentmemory/secret` avec le mode `0600`. Chaque client embarqué le lit depuis là quand il parle à un serveur local : la CLI, le visualiseur, les hooks sous `plugin/scripts`, le serveur MCP et le shim `@agentmemory/mcp`, les configs écrites par `agentmemory connect`, et les intégrations embarquées OpenCode, Pi, OpenClaw, Hermes et filesystem-watcher. Le secret stocké n'est envoyé qu'à des URLs loopback (`localhost`, `127.0.0.0/8`, `::1`). Un `AGENTMEMORY_SECRET` explicite prime toujours, et les clients distants en ont toujours besoin. Docker et les points d'entrée `deploy/` génèrent et exportent déjà leur propre secret. Pour appeler l'API à la main :
```bash
curl -H "Authorization: Bearer $(cat ~/.agentmemory/secret)" http://localhost:3111/agentmemory/health
```
**Règles de requête pour les écritures.** Les requêtes `POST`, `PUT`, `PATCH` et `DELETE` vers l'API REST et le visualiseur doivent envoyer `Content-Type: application/json` (un paramètre `charset` est acceptable) chaque fois qu'elles portent un corps, et un en-tête `Origin`, quand présent, doit être une origine loopback pour le port REST ou visualiseur configuré, ou être listé dans `VIEWER_ALLOWED_ORIGINS` (séparé par des virgules, par ex. `https://memory.example.com`). Les clients qui n'envoient aucun en-tête `Origin` (CLI, hooks, MCP, curl, serveur-à-serveur) ne sont pas affectés. Le visualiseur accepte aussi sa propre origine.
**Chemins de fichiers.** Les endpoints qui lisent ou écrivent des fichiers (`/compress-file`, `/replay/import-jsonl`, `/graph/import-graphify`) n'acceptent que des chemins sous `~/.agentmemory`, le répertoire de données de l'instance, ou un répertoire listé dans `AGENTMEMORY_IMPORT_ROOT` (séparez-en plusieurs avec `:`, ou `;` sous Windows). `/replay/import-jsonl` accepte aussi son défaut `~/.claude/projects`. `/obsidian/export` reste à l'intérieur de `AGENTMEMORY_EXPORT_ROOT` et `/migrate` à l'intérieur de `~/.agentmemory`. Les symlinks sont résolus avant chaque vérification.
**Épuration des secrets.** Les clés API, tokens bearer, blocs de clés privées PEM et credentials embarqués dans des URLs (`scheme://user:password@host`) sont expurgés avant que le texte ne soit stocké, sur chaque chemin d'écriture : observations, remember, evolve, slots, lessons, actions, sketches, signals, checkpoints, imports, replay jsonl, mesh sync, partages d'équipe, sortie de compression et de résumé, crystals et nœuds de graphe.
Endpoints clés
| Méthode | Chemin | Description |
|--------|------|-------------|
| `GET` | `/agentmemory/health` | Vérification de santé (toujours publique) |
| `GET` | `/agentmemory/status` | Ce qui ne va pas et comment le corriger (HTML pour les navigateurs, JSON sinon) |
| `GET` | `/agentmemory/viewer/snapshot` | Tout ce que le visualiseur affiche, en une seule réponse |
| `POST` | `/agentmemory/session/start` | Démarrer une session + obtenir le contexte |
| `POST` | `/agentmemory/session/end` | Terminer une session |
| `POST` | `/agentmemory/observe` | Capturer une observation (voir la livraison de capture ci-dessous) |
| `GET` | `/agentmemory/capture` | Boîte de réception de capture, dead letters et spool hors ligne |
| `POST` | `/agentmemory/capture/retry` | Réessayer les captures en dead-letter |
| `POST` | `/agentmemory/capture/drain` | Envoyer le spool hors ligne local maintenant |
| `POST` | `/agentmemory/smart-search` | Recherche hybride |
| `POST` | `/agentmemory/context` | Générer le contexte |
| `POST` | `/agentmemory/remember` | Sauvegarder en mémoire long terme |
| `POST` | `/agentmemory/forget` | Supprimer des observations |
| `POST` | `/agentmemory/enrich` | Contexte de fichier + mémoires + bugs |
| `GET` | `/agentmemory/profile` | Profil de projet |
| `GET` | `/agentmemory/export` | Exporter toutes les données |
| `POST` | `/agentmemory/import` | Importer depuis JSON |
| `POST` | `/agentmemory/graph/query` | Requête de graphe de connaissances |
| `POST` | `/agentmemory/graph/compact` | Réduire la provenance de graphe surdimensionnée |
| `POST` | `/agentmemory/team/share` | Partager avec l'équipe |
| `GET` | `/agentmemory/audit` | Piste d'audit |
Liste complète des endpoints : [`src/triggers/api.ts`](../src/triggers/api.ts)
**Livraison de capture.** Les hooks envoient chaque observation une fois à `POST /agentmemory/observe` avec un `eventId`. C'est l'id propre de l'hôte pour l'appel quand le payload en a un (par exemple le `tool_use_id` de Claude Code), sinon un hash de la session, du type de hook, du nom d'outil, de l'entrée, de la sortie et du timestamp de l'hôte. Le serveur écrit l'événement dans une boîte de réception de capture du state store, stocke l'observation, puis retire l'entrée de la boîte de réception. Le code de statut indique ce qui s'est passé :
| Statut | Champ `status` | Signification |
|---|---|---|
| `201` | `accepted` | Stocké. `observationId` est la nouvelle observation. |
| `202` | `accepted` (`state: "retrying"`) | Accepté, mais le stockage a échoué. Le serveur le réessaie, aussi après un redémarrage. |
| `200` | `duplicate` | Cet `eventId` a déjà été accepté. `observationId` est l'observation existante ; rien de nouveau n'est stocké. |
| `400` / `422` | `rejected` | Payload invalide, ou le stockage a échoué définitivement (l'événement est conservé comme dead letter). |
| `503` | `rejected` (`retryable: true`) | La boîte de réception est pleine (`AGENTMEMORY_CAPTURE_INBOX_MAX`). Les hooks mettent l'événement en spool et l'envoient plus tard. |
Les événements échoués sont réessayés toutes les `AGENTMEMORY_CAPTURE_RETRY_INTERVAL_MS` (10 s) avec un backoff qui double, jusqu'à `AGENTMEMORY_CAPTURE_MAX_ATTEMPTS` (5). Les événements qui échouent encore restent dans la boîte de réception comme dead letters, sont listés sur `/agentmemory/status` et la page Health du visualiseur, et peuvent être réessayés avec `POST /agentmemory/capture/retry` (`{"eventId": "..."}` ou `{"all": true}`). Les ids d'événements acceptés sont mémorisés pendant `AGENTMEMORY_CAPTURE_DEDUP_HOURS` (168 heures, au plus `AGENTMEMORY_CAPTURE_EVENTS_MAX` ids), donc un hook rejoué après un timeout ou un redémarrage est stocké une fois, tandis que deux appels d'outil séparés avec leurs propres ids d'hôte sont stockés deux fois même quand leur contenu est identique. Quand une observation est supprimée (forget, suppression de session, éviction, oubli automatique ou un import qui remplace le store), son événement est marqué comme supprimé avant que l'observation ne soit retirée, donc un replay de cet événement dans la même fenêtre reçoit une réponse de doublon et ne stocke rien. Le state store écrit sur disque toutes les 2 secondes, donc un événement ayant reçu une réponse peut encore n'exister qu'en mémoire pendant un instant. Pour couvrir cela, chaque réponse `2xx` porte aussi le `bootId` du serveur (nouveau à chaque démarrage), `acceptedAt` et `durableAfterMs` (l'intervalle de sauvegarde plus 1.5 s sur le store fichier, 1.5 s sur redis, où la persistance est le réglage de l'opérateur). Les hooks gardent l'événement dans le spool local jusqu'à ce que cette fenêtre soit passée et le suppriment lors d'un appel ultérieur sans nouvelle requête. Si le `bootId` a changé entre-temps, le serveur a redémarré, donc le hook renvoie l'événement avec le même `eventId` ; un événement qui a bien atteint le disque n'est pas stocké deux fois. Le serveur envoie aussi lui-même de tels événements au démarrage et à chaque intervalle de réessai, donc un redémarrage ne perd rien même si aucun hook ne tourne ensuite. Les anciens hooks ignorent les champs supplémentaires, et les nouveaux hooks contre un ancien serveur abandonnent l'événement sur `2xx` comme avant.
Quand le serveur est en panne, ne répond pas à temps ou retourne un 5xx, le hook ajoute l'observation à un fichier de spool local, `/capture-spool/-.jsonl` (surchargez le dossier avec `AGENTMEMORY_CAPTURE_SPOOL_DIR`). Le fichier est privé à votre utilisateur (mode 600), les secrets sont expurgés de la même façon que le serveur les expurge, il contient au plus `AGENTMEMORY_CAPTURE_SPOOL_MAX_BYTES` (5 Mio) et abandonne les entrées plus anciennes que `AGENTMEMORY_CAPTURE_SPOOL_MAX_AGE_HOURS` (168). Quand il est plein, les nouvelles entrées sont abandonnées et comptées, et `/agentmemory/status` le rapporte. Le hook sort toujours avec 0 dans sa limite de temps et n'ajoute aucune requête quand le serveur est sain. Le spool est envoyé au démarrage suivant et par le premier hook qui atteint à nouveau le serveur, dans un processus en arrière-plan pour que l'agent n'attende pas. Les ids d'événements rendent cela sûr : une observation qui est bien arrivée avant un timeout n'est pas stockée deux fois. `npx @agentmemory/agentmemory capture` affiche le spool et la boîte de réception du serveur, `--drain` envoie le spool maintenant, et `GET /agentmemory/capture` retourne la même chose en JSON. Définissez `AGENTMEMORY_CAPTURE_SPOOL=false` pour désactiver le spool.
**Compaction de la provenance de graphe.** Chaque nœud et arête du graphe de connaissances garde les ids des 32 observations les plus récentes dont il provient. Les stores écrits avant ce plafond peuvent contenir des milliers d'ids par nœud chaud, ce qui ralentit la recherche de graphe et le visualiseur ou fait planter le worker. agentmemory corrige cela de lui-même : au premier démarrage après une mise à niveau, il réduit chaque nœud, arête, arête supersédée (l'historique temporel du graphe) et le snapshot mis en cache au plafond en arrière-plan, en petites tranches avec une pause entre elles, pour que la recherche, la capture et le visualiseur continuent de fonctionner. Il sauvegarde sa progression, reprend après un redémarrage et ne se relance jamais une fois terminé. `/agentmemory/status` et la page Health du visualiseur l'affichent comme en attente, en cours (avec le scope et la position actuels), terminé ou échoué. Définissez `AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=false` pour le désactiver.
Pour le lancer à la main, appelez `POST /agentmemory/graph/compact`. Il parcourt les index de nom et de clé d'arête plutôt que de lister chaque nœud et arête, et peut être relancé en toute sécurité. Quand il réduit des ids, il écrit une entrée d'audit `graph_compact`.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{}'
```
Sur un gros store, ou quand l'appel retourne 504, lancez-le en tranches. Envoyez `scope` (`nodes`, `edges` ou `history`), `offset` et `limit`, puis rappelez avec le `nextOffset` retourné jusqu'à ce qu'il soit `null`. Faites cela pour `nodes`, `edges` et `history`, et terminez par un seul appel `{"scope":"snapshot"}`, car une exécution en tranches ne touche pas le snapshot mis en cache.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"nodes","offset":0,"limit":200}'
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"snapshot"}'
```
---
```bash
npm run dev # Hot reload
npm run build # Production build
npm test # 2,500+ tests
npm run test:integration # API tests (requires running services)
```
**Prérequis :** Node.js >= 20 avec npm/npx ; [iii-engine](https://iii.dev/docs) v0.22.1 ou Docker. L'installation automatique du moteur sur macOS/Linux nécessite aussi `curl`, un `sh` POSIX, et `tar` ; Windows natif utilise l'`iii.exe` épinglé manuel, WSL2, ou Docker Desktop.