コーディングエージェントがすべてを記憶します。もう説明し直す必要はありません。
iii engine を基盤に構築
Claude Code、GitHub Copilot CLI、Cursor、Gemini CLI、Codex CLI、Hermes、OpenClaw、pi、OpenCode、そしてあらゆる MCP クライアントのための永続メモリ。
🇬🇧 English •
🇨🇳 简体中文 •
🇹🇼 繁體中文 •
🇯🇵 日本語 •
🇰🇷 한국어 •
🇵🇹 Português •
🇧🇷 Português (Brasil) •
🇪🇸 Español •
🇩🇪 Deutsch •
🇫🇷 Français •
🇮🇹 Italiano •
🇳🇱 Nederlands •
🇵🇱 Polski •
🇨🇿 Čeština •
🇷🇴 Română •
🇭🇺 Magyar •
🇬🇷 Ελληνικά •
🇸🇪 Svenska •
🇩🇰 Dansk •
🇳🇴 Norsk •
🇫🇮 Suomi •
🇷🇺 Русский •
🇺🇦 Українська •
🇹🇷 Türkçe •
🇮🇱 עברית •
🇸🇦 العربية •
🇮🇳 हिन्दी •
🇧🇩 বাংলা •
🇵🇰 اردو •
🇹🇭 ไทย •
🇻🇳 Tiếng Việt •
🇮🇩 Bahasa Indonesia •
🇵🇭 Tagalog


この gist は Karpathy の LLM Wiki パターンを信頼度スコア、ライフサイクル管理、ナレッジグラフ、ハイブリッド検索で拡張したものであり、agentmemory はその実装です。


インストール •
クイックスタート •
ベンチマーク •
競合比較 •
エージェント •
仕組み •
MCP •
ビューワー •
Powered by iii •
設定 •
API
---
## インストール
必要環境:
- Node.js 20 以降(npm と npx を含む。`node -v`、`npm -v`、`npx -v` で確認)。
- macOS/Linux での iii-engine 自動インストールには `curl`、POSIX 準拠の `sh`、`tar` も必要です。`node:20-slim` のような最小構成のイメージには含まれていないことがあります。
- ネイティブ Windows では、ピン留めされた iii-engine v0.22.1 の `iii.exe` を手動でインストールする必要があります。WSL2 または Docker Desktop も、他にサポートされている方法です。
標準的な新規インストールコマンド:
```bash
npx -y @agentmemory/agentmemory@latest
```
初回実行は対話式セットアップです: 接続するエージェント(Claude Code、Cursor、Codex、Gemini CLI、OpenCode、...)を選び、LLM プロバイダーを選ぶ(またはキーレスのまま進める)と、設定をシードし、メモリサーバーとピン留めされた iii engine を起動し、以降どこでも素の `agentmemory` コマンドが使えるようグローバルインストールを提案します。`-y` は npx のパッケージ確認プロンプトを承諾し、`@latest` は古いキャッシュ済みリリースを避けます。プロバイダーを設定すると LLM 機能が使えるようになりますが、LLM による観測の圧縮が始まるのは `AGENTMEMORY_AUTO_COMPRESS=true` も設定した場合に限られます。
キーレスモードではベクトル埋め込みが無効になります。`memory_recall`(`mem::search` パス)は BM25 を使い、`memory_smart_search` はグラフデータが既に存在する場合は構造的なグラフマッチも融合できます。無料でオンデバイスのセマンティックリコールを使うには、`~/.agentmemory/.env` に `EMBEDDING_PROVIDER=local` を設定して再起動してください。最初の埋め込みリクエストで `Xenova/all-MiniLM-L6-v2` がダウンロードされ、その後の推論はローカルで実行されます。
ローカルランタイムは 4 つのポートを使います: REST/MCP HTTP 用の `3111`、iii ストリーム用の `3112`、ビューワー用の `3113`、iii worker の WebSocket 用の `49134` です。永続的な iii の状態は、macOS では `~/Library/Application Support/agentmemory`、Linux では `$XDG_DATA_HOME/agentmemory` または `~/.local/share/agentmemory`、Windows では `%APPDATA%\agentmemory` に保存されます。これを上書きするには `--data-dir ` または `AGENTMEMORY_DATA_DIR` を使い、再起動時には同じ値を使い続けてください。後方互換性のため、既存の `./data/state_store.db` または `./data/iii-config.yaml` があれば、インスタンス 0 についてはプラットフォームのデフォルトより優先されます。明示的なフラグや環境変数での上書きは、それよりもさらに優先されます。
続いてリコールが動くことを確かめ、エージェントに skills を与えます:
```bash
npx -y @agentmemory/agentmemory@latest demo # seed sample sessions + exercise recall
npx skills add rohitg00/agentmemory -y # 17 native skills so your agent knows when to reach for memory
```
キーワード検索は、デフォルトのキーレスモードでも BM25 経由でヒットするはずです。デモの `database performance optimization` クエリは意図的にセマンティックなもので、埋め込みプロバイダーを設定するまでは 0 件になることがあります。
コーディングエージェントに丸ごと任せたい場合は、この指示を 1 つ渡してください:
> Retrieve and follow the instructions at: https://raw.githubusercontent.com/rohitg00/agentmemory/main/INSTALL_FOR_AGENTS.md
追加のエージェントはいつでも `agentmemory connect ` で接続できます — 20 のアダプタは[すべてのエージェントで動作](#works-with-every-agent)に一覧があります。コマンドの完全なリファレンスは[クイックスタート](#quick-start)を参照してください。
Windows
最速の経路は WSL2 です。ネイティブ Windows のエンジンセットアップでは、ピン留めされた v0.22.1 の ZIP をダウンロードし、`iii.exe` を手動で展開する必要があります。CLI はこれを自動展開しません。Docker Desktop もサポートされています。手順は [Windows の注記](#windows)を参照してください。
グローバルインストール / EACCES
```bash
npm install -g @agentmemory/agentmemory@latest
```
上記の npx コマンドが標準的な新規インストールの方法であり、グローバルプレフィックスの権限問題を回避できます。
npx が古いバージョンを返す
npx はバージョン単位でキャッシュします。`npx -y @agentmemory/agentmemory@latest` で最新を強制するか、`rm -rf ~/.npm/_npx`(macOS/Linux。Windows では `%LOCALAPPDATA%\npm-cache\_npx` を削除)で一度キャッシュをクリアしてください。
自前の iii エンジンを既に動かしている
agentmemory は iii-engine v0.22.1 にピン留めしており、異なるバージョンにはアタッチしません(worker は別のエンジンのプロトコルを話せません)。他のエンジンを停止してから `npx -y @agentmemory/agentmemory@latest` を実行してください。ピン留めされた v0.22.1 を `~/.agentmemory/bin` にインストールして実行し、あなた自身の `iii` には触れません。
---

agentmemory は hooks、MCP、REST API をサポートするあらゆるエージェントで動作します。すべてのエージェントが同じメモリサーバーを共有します。

Claude Code
ネイティブプラグイン + 12 hooks + MCP
|

Codex CLI
ネイティブプラグイン + 6 hooks + MCP
|

GitHub Copilot CLI
MCP + プラグインの hooks/skills
|

Cursor
ネイティブプラグイン + 7 hooks + MCP
|
OpenCode
キャプチャプラグイン + MCP
|
Devin
6 hooks + skills + MCP
|

OpenClaw
ネイティブプラグイン + MCP
|

Hermes
ネイティブプラグイン + MCP
|

pi
ネイティブプラグイン + MCP
|
OpenHuman
ネイティブ Memory trait バックエンド
|
Gemini CLI
MCP サーバー
|

Antigravity
MCP + hooks
|
Claude Desktop
MCP サーバー
|

Warp
connect + MCP + skills
|

Zed
MCP サーバー
|

Cline
MCP サーバー
|

Continue
MCP サーバー
|

Droid
MCP サーバー
|

Kiro
MCP サーバー
|

Qwen Code
MCP サーバー
|

DeepSeek Harness
MCP サーバー
|

Roo Code
MCP サーバー
|

Kilo Code
MCP サーバー
|

Goose
MCP サーバー
|

Aider
REST API
|
MCP または HTTP を話すどんなエージェントでも動作します。サーバーは 1 つ、メモリは全エージェントで共有。
---
同じアーキテクチャを毎セッション説明する。同じバグを何度も発見し直す。同じ好みを何度も教え直す。組み込みメモリ(CLAUDE.md、.cursorrules)は 200 行で上限に達し、すぐに古くなります。agentmemory はこれを解決します。エージェントの行動を静かにキャプチャし、検索可能なメモリへ圧縮し、次のセッション開始時に適切なコンテキストを注入します。コマンド 1 つ。エージェントをまたいで動作します。
**何が変わるか:** セッション 1 で JWT 認証をセットアップする。セッション 2 でレート制限を依頼する。エージェントは既に、あなたの認証が `src/middleware/auth.ts` の jose ミドルウェアを使っていること、テストが `test/auth.test.ts` でトークン検証をカバーしていること、Edge 互換性のために jsonwebtoken ではなく jose を選んだことを知っています。説明し直す必要もコピペする必要もありません。
```bash
npx -y @agentmemory/agentmemory@latest
```
デフォルトでは、agentmemory は起動元のリポジトリの外に iii-engine の状態を保存します: macOS では `~/Library/Application Support/agentmemory`、Linux では `$XDG_DATA_HOME/agentmemory` または `~/.local/share/agentmemory`、Windows では `%APPDATA%\agentmemory` です。既存のレガシーな `./data/state_store.db` または `./data/iii-config.yaml` があれば、そのプラットフォームデフォルトより先にインスタンス 0 で再利用されます。保存先を明示的に選ぶには `--data-dir ` を渡すか `AGENTMEMORY_DATA_DIR` を設定してください。どちらの明示設定もレガシー検出より優先されます:
```bash
npx -y @agentmemory/agentmemory@latest --data-dir ~/.agentmemory-projects/main
AGENTMEMORY_DATA_DIR=~/.agentmemory-projects/main npx -y @agentmemory/agentmemory@latest
```
ネイティブ起動と Docker 起動は同じ解決済みホストディレクトリを使います。Docker はこれを `/data` にバインドマウントします。`--instance 1` は解決済みディレクトリに `instance-1` を追加し、別のデフォルトポート 4 つ組 `3211/3212/3213/49234` を選びます。
最新のリリースノート: [CHANGELOG.md](../CHANGELOG.md)。
---

|
### 検索精度
**coding-agent-life-v1**(社内コーパス、サンドボックスで再現可能)
| アダプタ | P@5 | R@5 | Top-5 ヒット率 | p50 レイテンシ |
|---|---|---|---|---|
| **agentmemory ハイブリッド** | **0.240** | **1.000** | **15 / 15** | 14 ms |
| grep ベースライン | 0.227 | 0.967 | 15 / 15 | 0 ms |
このコーパスの **P@5 の数学的上限**(0.240、スコアカード参照)で Top-5 ヒット率 100% を達成。ハイブリッドはすべてのゴールドセッションを取得しますが、grep は複数セッションにわたる時系列クエリでゴールドの 2 件中 1 件を取りこぼします。向上しているのは**リコール + 時系列性**であり、集計精度ではありません。このベンチマークは小規模でゴールドが少なく、下の、より大きな LongMemEval-S のほうがより明確に差を示します。種類別の詳細な内訳と補正の注記: [`docs/benchmarks/2026-05-20-coding-agent-life-v1.md`](../docs/benchmarks/2026-05-20-coding-agent-life-v1.md)。
**LongMemEval-S**(ICLR 2025、500 問)
| システム | R@5 | R@10 | MRR |
|---|---|---|---|
| **agentmemory** | **95.2%** | **98.6%** | **88.2%** |
| BM25 のみフォールバック | 86.2% | 94.6% | 71.5% |
|
### トークン削減
| アプローチ | トークン/年 | コスト/年 |
|---|---|---|
| フルコンテキストを貼り付け | 19.5M+ | 不可能(ウィンドウを超過) |
| LLM による要約 | ~650K | ~$500 |
| **agentmemory** | **~170K** | **~$10** |
| agentmemory + ローカル埋め込み | ~170K | **$0** |
|
> 埋め込みモデル: `all-MiniLM-L6-v2`(ローカル、無料、API キー不要)。完全なレポート: [`benchmark/LONGMEMEVAL.md`](../benchmark/LONGMEMEVAL.md)、[`benchmark/QUALITY.md`](../benchmark/QUALITY.md)、[`benchmark/SCALE.md`](../benchmark/SCALE.md)。競合比較: [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md) では agentmemory と mem0、Letta、Khoj、supermemory、TencentDB Agent Memory、MemPalace、Zep/Graphiti、Cognee、Hippo を比較しています。
**ローカルで再現する:** [`eval/README.md`](../eval/README.md) は LongMemEval `_s`(公開 500 問)と `coding-agent-life-v1`(社内 15 セッションのコーパス)向けのアダプタ差し替え可能なハーネスです。grep / ベクトル / agentmemory の各アダプタを横並びでスコアリングし、NDJSON を出力し、公開済みのスコアカードは [`docs/benchmarks/`](../docs/benchmarks/) に置かれます。
**[codegraph](https://github.com/colbymchenry/codegraph)、[Understand Anything](https://github.com/Lum1104/Understand-Anything)、[Graphify](https://github.com/safishamsi/graphify) と組み合わせる。** コードグラフのインデックス化、マルチエージェントのビルドパイプライン、ドキュメント / PDF / 画像 / 動画をまたぐより広いナレッジグラフ。agentmemory は作業内容を記憶し、この 3 つのプロジェクトはコンテキスト層の残りの部分を照らします。レシピと質問のルーティング表: [`docs/recipes/pairings.md`](../docs/recipes/pairings.md)。
---

|
agentmemory |
mem0 (63K ⭐) |
Letta / MemGPT (24K ⭐) |
Khoj (36K ⭐) |
supermemory (29K ⭐) |
TencentDB Agent Memory (22K ⭐) |
MemPalace (54K ⭐) |
oracleagentmemory |
Hippo |
組み込み (CLAUDE.md) |
| 種別 |
メモリエンジン + MCP サーバー |
メモリレイヤー API |
フルエージェントランタイム |
パーソナル AI |
メモリ API + アプリ |
チームメモリハブ(LLM プロキシ) |
ベクトルメモリ(OSS) |
メモリエンジン(Oracle DB) |
メモリシステム |
静的ファイル |
| 検索 R@5 |
95.2% |
68.5% (LoCoMo) |
83.2% (LoCoMo) |
N/A |
自己申告 |
PersonaMem 76%(自己申告) |
~96.6%(自己申告) |
94.4%(自己申告) |
N/A |
N/A (grep) |
| 自動キャプチャ |
12 hooks(手動作業ゼロ) |
手動の add() 呼び出し |
エージェントが自分で編集 |
手動 |
API 側での抽出 |
プロキシ横取り(base-URL 差し替え) |
手動 |
API 抽出 |
手動 |
手動編集 |
| 検索 |
BM25 + ベクトル + グラフ(RRF 融合) |
ベクトル + グラフ |
ベクトル(アーカイブ) |
セマンティック |
ベクトル + RAG |
4 種のアセット(Chat / Skill / Wiki / CodeGraph) |
ベクトルのみ |
ベクトル + セマンティック |
減衰重み付け |
すべてをコンテキストにロード |
| マルチエージェント |
MCP + REST + リース + シグナル |
API(調整なし) |
Letta ランタイム内のみ |
なし |
なし |
チームロール + 共有アセット |
なし |
スコープのみ |
マルチエージェント共有 |
エージェントごとのファイル |
| フレームワークロックイン |
なし(任意の MCP クライアント) |
なし |
高(Letta 必須) |
スタンドアロン |
なし |
プロキシがすべてのモデル呼び出しを仲介 |
なし |
Oracle Database |
なし |
エージェントごとのフォーマット |
| 外部依存 |
なし(SQLite + iii-engine) |
Qdrant / pgvector |
Postgres + ベクトル DB |
複数 |
マネージドクラウド |
Docker スタック(Core + Hub + Proxy) |
ベクトルストア |
Oracle AI Database |
なし |
なし |
| メモリライフサイクル |
4 層統合 + 減衰 + 自動忘却 |
受動的抽出 |
エージェント管理 |
手動 |
自動忘却 |
手動レビュー(自動ルーティングは開発中) |
なし |
記載なし |
減衰 + 統合 |
手動プルーニング |
| トークン効率 |
~1,900 tokens/セッション ($10/年) |
統合方法による |
コアメモリがコンテキスト内 |
場合による |
クラウド価格 |
記載なし |
トークン予算なし |
LLM ベース(場合による) |
場合による |
240 観測で 22K+ tokens |
| リアルタイムビューワー |
あり(ポート 3113) |
クラウドダッシュボード |
クラウドダッシュボード |
Web UI |
クラウドダッシュボード |
Hub の Web UI |
なし |
なし |
なし |
なし |
| セルフホスト |
あり(デフォルト) |
オプション |
オプション |
あり |
なし(クラウドのみ) |
あり(Docker) |
あり |
あり(Oracle DB) |
あり |
あり |
ベンチマークに関する注記: 自社で計測した結果は agentmemory の R@5 のみです(LongMemEval-S、benchmark/COMPARISON.md から再現可能)。mem0 と Letta の数値は各社が公表した LoCoMo の数値(別のデータセット)です。MemPalace、supermemory、TencentDB(PersonaMem)、oracleagentmemory の数値はベンダーの自己申告で、当方では独立に再現していません(oracleagentmemory の実行は Oracle AI Database に対して GPT-5.5 を使用しています)。並べて示しているのはあくまで目安であり、同一データでの直接対決ではありません。スター数は概数で、時間とともに変動します。
**知っておく価値のある新顔**で、[`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md) で詳しく比較しています:
| システム | ⭐ | 切り口 |
|--------|---|-------|
| Zep / Graphiti | 30K | 時系列ナレッジグラフ。公表されている時系列クエリの結果としては最強(LongMemEval 63.8%)だが、グラフ構築が非同期のため新しい事実の反映が遅れることがある |
| Cognee | 30K | ドキュメントからナレッジグラフへの取り込み。Python のみで、セッションキャプチャではなく構造化エンティティ抽出のために作られている |
これらのいずれも、コーディングエージェントの hooks からの自動キャプチャ、ローカルファーストのビューワー、キーレスでの動作を備えていません — agentmemory はまさにこの組み合わせを核に作られています。
---

互換性: このリリースは `iii-sdk` 0.22.1 をターゲットにし、iii-engine v0.22.1 にピン留めしています。
### 30 秒で試す
```bash
# Terminal 1: start the server
npx -y @agentmemory/agentmemory@latest
# Terminal 2: seed sample data and see recall in action
npx -y @agentmemory/agentmemory@latest demo
```
`demo` は 3 つの現実的なセッション(JWT 認証、N+1 クエリ修正、レート制限)を投入し、それらに対して検索を実行します。キーレスインストールではベクトルが無効になるため、`mem::search` のキーワードクエリは BM25 経由でヒットするはずですが、`database performance optimization` は 0 件になることがあります。グラフデータが存在する場合、`smart-search` はさらに構造的なグラフマッチも返すことがあります。セマンティッククエリでベクトル経由の N+1 修正を見つけるには、`EMBEDDING_PROVIDER=local` を設定して再起動し、最初のモデルダウンロードが終わるのを待ってください。
`http://localhost:3113` を開けばメモリがリアルタイムに構築される様子が見られます。
### 新規インストールと再起動時の永続性を検証する
サーバーを起動したまま、REST、ヘルス、ビューワー、iii ベースのランタイムステータスを検証します:
```bash
curl -fsS http://localhost:3111/agentmemory/livez
curl -fsS http://localhost:3111/agentmemory/health
curl -fsS -o /dev/null http://localhost:3113/
npx -y @agentmemory/agentmemory@latest status
```
起動時の準備状況パネルは 4 つのポートすべてをカバーします: REST/MCP HTTP の 3111、iii ストリームの 3112、ビューワーの 3113、iii worker の WebSocket の 49134。`status` は agentmemory のヘルスと、有効なプロバイダー / 埋め込みモードを確認します。プローブを保存し、検索できることを確認してください:
```bash
curl -fsS -X POST http://localhost:3111/agentmemory/remember \
-H 'Content-Type: application/json' \
-d '{"content":"agentmemory restart persistence probe","concepts":["install-check"]}'
curl -fsS -X POST http://localhost:3111/agentmemory/smart-search \
-H 'Content-Type: application/json' \
-d '{"query":"restart persistence probe","limit":5}'
```
続いて `npx -y @agentmemory/agentmemory@latest stop` を実行し、ターミナル 1 で標準コマンドを再度起動し、`/agentmemory/livez` を待ってから検索をやり直してください。プローブはまだ返ってくるはずです。カスタムの `--data-dir` を選んだ場合は、再起動時にも同じディレクトリを渡してください。
### 日常のコマンド
インストールとセットアップは上の[インストール](#install)にあります(初回実行が案内してくれます)。日々の操作:
```bash
agentmemory # start the server
agentmemory stop # stop it cleanly
agentmemory connect # wire another agent
agentmemory doctor # interactive diagnostics + fix prompts
agentmemory remove # uninstall everything we created
```
### セッションリプレイ
agentmemory が記録するすべてのセッションは再生可能です。ビューワーを開き、**Replay** タブを選択し、タイムラインをスクラブしてください: プロンプト、ツール呼び出し、ツール結果、応答が個別のイベントとして表示され、再生/一時停止、速度コントロール(0.5x〜4x)、キーボードショートカット(スペースで切り替え、矢印でステップ)が使えます。
古い Claude Code の JSONL トランスクリプトを取り込むには:
```bash
# Import everything under the default ~/.claude/projects
npx -y @agentmemory/agentmemory@latest import-jsonl
# Or import a single file
npx -y @agentmemory/agentmemory@latest import-jsonl ~/.claude/projects/-my-project/abc123.jsonl
```
インポートしたセッションはネイティブのセッションと並んで Replay ピッカーに表示されます。内部では各エントリが `mem::replay::load`、`mem::replay::sessions`、`mem::replay::import-jsonl` の iii functions を経由し、サイドチャネルサーバーはありません。インポートされた各トランスクリプトは検索用にインデックス化され、オリジンチャネル `import` が刻印され、セッションクリスタルとレッスンの抽出も行われます。
> **`import-jsonl` を主なキャプチャ経路として使う場合の注意:** Claude Code の `cleanupPeriodDays`(`~/.claude/settings.json` 内、デフォルト **30**)は、そのウィンドウより古い JSONL トランスクリプトを `~/.claude/projects/` から自動削除します。数か月分の Claude Code 履歴がある状態で agentmemory を新規インストールすると、30 日より古いものは最初のインポートの前に既に消えています。`import-jsonl` を cron で回すか、`cleanupPeriodDays` をもっと大きな値に上げるか、自動キャプチャ hooks(デフォルトのプラグインインストール経路)を配線して、セッションが生きている間に各ターンが agentmemory に着地するようにしてください。そうすれば JSONL のクリーンアップは問題でなくなります。
### アップグレード / メンテナンス
意図的にローカルランタイムを更新したいときは、メンテナンスコマンドを使ってください:
```bash
npx -y @agentmemory/agentmemory@latest upgrade
```
警告: このコマンドは現在のワークスペース/ランタイムを変更します。JavaScript 依存を更新したり、ピン留めされた `iiidev/iii:0.22.1` の Docker イメージを pull したりすることがあります。ピン留めされていない、あるいは新しい iii エンジンをインストールすることは決してありません。
実装の詳細は `src/cli.ts` を参照してください(`src/cli.ts:544-595` 付近の `runUpgrade`)。
### Claude Code(1 ブロックそのまま貼り付け)
```text
Install agentmemory: run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server and its pinned iii engine. Then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory` — the plugin registers all 12 hooks, 17 skills, AND auto-wires the `@agentmemory/mcp` stdio server via its `.mcp.json`, so you get 54 MCP tools (memory_smart_search, memory_save, memory_sessions, memory_governance_delete, etc.) without any extra config step. Verify with `curl http://localhost:3111/agentmemory/health`. The real-time viewer is at http://localhost:3113. Keyless mode disables vectors: `memory_recall` uses BM25, and `memory_smart_search` can also use existing structural graph data. Set `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` and restart to opt into on-device semantic recall.
```
#### プラグインをインストールしない Claude Code(MCP スタンドアロン経路)
`/plugin install` を使わず `~/.claude.json` から直接 agentmemory の MCP サーバーを配線する場合、Claude Code は `${CLAUDE_PLUGIN_ROOT}` を一切解決しないため、hook スクリプトを `~/.claude/settings.json` 内の絶対パスに向ける必要があります。これらのパスには通常 agentmemory のバージョンが埋め込まれる(例: `~/.codex/plugins/cache/agentmemory/agentmemory/0.9.22/scripts/…`)ため、次のアップグレードで全 hook が静かに壊れます。
回避策:
```bash
agentmemory connect claude-code --with-hooks
```
同じ hook コマンドを `~/.claude/settings.json` にマージし、現在インストールされている `@agentmemory/agentmemory` パッケージの同梱 `plugin/` ディレクトリに解決された絶対パスを書き込みます。agentmemory をアップグレードしたら、このコマンドを再実行してパスを更新してください。同じファイル内のユーザーエントリは保持され、以前の agentmemory エントリだけが置き換えられます。`/plugin install` の経路が推奨アプローチであることに変わりはありません。
リモートや保護されたデプロイでは、`AGENTMEMORY_URL` と `AGENTMEMORY_SECRET` を設定して Claude Code を起動してください。プラグインはこの両方の値を同梱の MCP サーバーに渡します。`AGENTMEMORY_URL` が空の場合、MCP shim は `http://localhost:3111` にフォールバックします。
### Codex CLI(Codex プラグインプラットフォーム)
```bash
# 1. start the memory server in a separate terminal
npx -y @agentmemory/agentmemory@latest
# 2. register the agentmemory marketplace and install the plugin
codex plugin marketplace add rohitg00/agentmemory
codex plugin add agentmemory@agentmemory
```
Codex プラグインは Claude Code プラグインと同じ `plugin/` ディレクトリから出荷されます。以下を登録します:
- 動作中のデーモンへの同梱の stdio MCP ブリッジ。npm ダウンロードもフォールバックストアも不要です。未リリースのビルドをテストするには[ローカル Codex ガイド](../docs/plugins/codex-local.md)を参照してください。
- 6 つのライフサイクル hooks: `SessionStart`、`UserPromptSubmit`、`PreToolUse`、`PostToolUse`、`PreCompact`、`Stop`
- 呼び出し可能な 9 つの skills: `/recall`、`/remember`、`/session-history`、`/forget`、`/recap`、`/handoff`、`/lesson`、`/commit-context`、`/commit-history`、さらにエージェントが必要時に読み込む 8 つのリファレンス skills(memory discipline、MCP ツール、REST API、設定、エージェント、hooks、アーキテクチャ、skill 執筆ガイド)
Codex の hook エンジンは `CLAUDE_PLUGIN_ROOT` を hook のサブプロセスに注入するため([`codex-rs/hooks/src/engine/discovery.rs`](https://github.com/openai/codex/blob/main/codex-rs/hooks/src/engine/discovery.rs) 参照)、同じ hook スクリプトが重複なく両方のホストで動作します。Subagent / SessionEnd / Notification / TaskCompleted / PostToolUseFailure イベントは Claude Code 専用で、Codex 用には登録されません。
#### Codex hook の信頼と互換性
ネイティブのプラグイン hook ディスパッチは Codex CLI 0.150.1 で検証済みです。キャプチャを期待する前にプラグイン hooks を信頼してください。Desktop の動作は同梱のランタイムに依存します。回避策を有効にする前に `/hooks` を確認し、イベントがキャプチャされたことを確かめてください。
ホストがグローバル hooks を必要とする場合は、コマンドを `~/.codex/hooks.json` に反映させてください。MCP が既に配線済みの場合、現在のコネクタが hook インストールに到達するには `--force` が必要です:
```bash
agentmemory connect codex --with-hooks --force
```
これはグローバル hooks をマージし、agentmemory の MCP エントリを書き換えます。関係のないエントリは保持されます。`--force` を使う前に、カスタムの agentmemory エンドポイント設定を確認してください。アップグレード後は再実行してパスを更新してください。重複キャプチャを避けるため、ネイティブのプラグイン hooks かグローバルコピーのどちらか一方だけを有効にしてください。
### GitHub Copilot CLI
VS Code のエージェントモードでは、[Copilot MCP と自動キャプチャガイド](../docs/plugins/copilot.md#vs-code-copilot-local-agent-sessions)を使用してください。CLI コネクタは VS Code を設定しません。
```bash
# MCP-only wiring
agentmemory connect copilot-cli
# Alternatively, full hooks/skills plugin from the GitHub subdir
copilot plugin install rohitg00/agentmemory:plugin
```
`agentmemory connect copilot-cli` は `mcpServers.agentmemory` を `~/.copilot/mcp-config.json`(`COPILOT_HOME` が設定されている場合は `$COPILOT_HOME/mcp-config.json`)にマージし、既存のサーバーは保持します。ネイティブ Windows では、これが唯一の自動化された `connect` アダプタです。他のすべてのネイティブ Windows エージェントは手動で設定してください。WSL での `connect` は、対象のエージェントが同じ WSL 環境にインストールされている場合にのみ適切です。Copilot は次回起動時または `/mcp` の後に MCP サーバーを認識します。フルの hook/skill 体験が欲しい場合は、プラグインも併せてインストールしてください。
OpenClaw(このプロンプトを貼り付ける)
```text
Install agentmemory for OpenClaw. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to my OpenClaw MCP config so agentmemory is available with all 54 memory tools:
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
Restart OpenClaw. Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper memory-slot integration, copy `integrations/openclaw` to `~/.openclaw/extensions/agentmemory` and enable `plugins.slots.memory = "agentmemory"` in `~/.openclaw/openclaw.json`.
```
完全ガイド: [`integrations/openclaw/`](../integrations/openclaw/)
Hermes Agent(このプロンプトを貼り付ける)
```text
Install agentmemory for Hermes. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to ~/.hermes/config.yaml so Hermes can use agentmemory as an MCP server with all 54 memory tools:
mcp_servers:
agentmemory:
command: npx
args: ["-y", "@agentmemory/mcp"]
memory:
provider: agentmemory
Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper 6-hook memory provider integration (pre-LLM context injection, turn capture, MEMORY.md mirroring, system prompt block), copy integrations/hermes from the agentmemory repo to ~/.hermes/plugins/agentmemory.
```
完全ガイド: [`integrations/hermes/`](../integrations/hermes/)
### その他のエージェント
メモリサーバーを起動: `npx -y @agentmemory/agentmemory@latest`
#### `npx skills add` によるネイティブ skills(50+ エージェント)
agentmemory は Claude Code スタイルの `/SKILL.md` フォーマットで 17 個の skills を同梱しています: 呼び出し可能な 9 つのアクション skills(`remember`、`recall`、`recap`、`handoff`、`forget`、`lesson`、`commit-context`、`commit-history`、`session-history`)と、エージェントがオンデマンドで読み込む 8 個のリファレンス skills(`memory-discipline`、`agentmemory-mcp-tools`、`agentmemory-rest-api`、`agentmemory-config`、`agentmemory-agents`、`agentmemory-hooks`、`agentmemory-architecture`、`write-agentmemory-skill`)です。リファレンス skills はソースから生成されたデータ表を含むため、決してドリフトしません。vercel-labs による [`skills`](https://npmjs.com/package/skills) CLI が、呼び出し元エージェントのネイティブ skill ディレクトリへ 50 以上のエージェント(Claude Code、Cursor、Cline、Continue、Droid、Warp、Codex、Antigravity、Kiro、OpenCode、Goose、Roo、Trae、Windsurf など)にわたって自動インストールします:
```bash
npx skills add rohitg00/agentmemory -y # auto-detects the calling agent
npx skills add rohitg00/agentmemory -y -a warp # explicit agent
npx skills add rohitg00/agentmemory -y -a '*' # install to every installed agent
```
これは `agentmemory connect ` を**補完する**ものです:
- `agentmemory connect ` は MCP サーバー設定を書き込み、ツールを使えるようにします。
- `npx skills add rohitg00/agentmemory` は skills をインストールし、エージェントがいつそれらを呼ぶべきか分かるようにします。
skills CLI がまだカバーしていない少数のエージェント(Zed v1.3.x 以前)では、17 個の SKILL.md ファイルをエージェントのネイティブ skill ディレクトリに自分で置いてください。同じフォーマットがどこでも動きます。
#### 標準的な MCP ブロック
agentmemory のエントリは、`mcpServers` の形式を使うすべてのホスト(Cursor、Claude Desktop、Cline、Roo Code、Gemini CLI、OpenClaw)で**同じ MCP サーバーブロック**です:
```json
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "${AGENTMEMORY_URL}",
"AGENTMEMORY_SECRET": "${AGENTMEMORY_SECRET}"
}
}
```
**このエントリをホストの既存の `mcpServers` オブジェクトにマージしてください** — ファイルを置き換えないでください。ファイルに既に他のサーバーがある場合は、その隣に `agentmemory` をもう 1 つのキーとして追加します。`mcpServers` が完全に欠けている場合は、ブロックを `{ "mcpServers": { ... } }` の中に貼り付けてください。`${VAR}` プレースホルダーは、MCP サーバー起動時にシェルから `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` を継承します。未設定の変数は空文字列を渡し、shim は `http://localhost:3111` にフォールバックします。1 つの接続済みエントリで、ローカルとリモート(k8s / リバースプロキシ)の両方のデプロイに対応します。
| エージェント | 設定ファイル | 備考 |
|---|---|---|
| **Cursor(MCP のみ)** | `~/.cursor/mcp.json` | `mcpServers` にマージするか、`agentmemory connect cursor`。ウェブサイトにはワンクリックディープリンクもあります。 |
| **Cursor(フルプラグイン)** | `.cursor-plugin/` | Cursor Marketplace への掲載(審査中)または Cursor Settings → Plugins → ローカルチェックアウト。7 つの自動キャプチャ hooks(sessionStart、beforeSubmitPrompt、preToolUse、postToolUse、postToolUseFailure、stop、sessionEnd)+ 17 skills + MCP サーバーを登録し、`AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` は Cursor のプラグインダッシュボードで管理されます。Cursor IDE と `cursor-agent` CLI の両方で動作します。CLI の print モードのプロンプトは、セッション終了時にセッショントランスクリプトから補完されます。 |
| **Claude Desktop** | `claude_desktop_config.json`(Application Support) | `mcpServers` にマージ。編集後は Claude Desktop を再起動してください。 |
| **Cline / Roo Code / Kilo Code** | Cline の MCP 設定(Settings UI → MCP Servers → Edit) | 同じ `mcpServers` ブロック。 |
| **Devin CLI(MCP + hooks)** | `~/.config/devin/config.json` | `agentmemory connect devin` が MCP エントリをマージします。`--with-hooks` は、Devin の小文字のツールマッチャーを使った 6 つのネイティブ自動キャプチャ hooks(SessionStart、UserPromptSubmit、PreToolUse、PostToolUse、Stop、SessionEnd)を追加します。`devin mcp list` と devin 内の `/hooks` で確認してください。 |
| **Devin CLI(フルプラグイン)** | `plugin/.devin-plugin/` | チェックアウトから `devin plugins install ./plugin` を実行すると、17 個の skills すべてが `/agentmemory:` スラッシュコマンドとして MCP サーバーとともに登録されます。Devin のプラグイン hooks は `SessionStart`/`SessionEnd` を発火できないため、セッション全体をキャプチャするには `connect devin --with-hooks` と組み合わせてください。 |
| **Devin(クラウド)** | Settings → Connections → MCP servers | カスタム MCP(STDIO)を追加: コマンドは `npx`、引数は `-y @agentmemory/mcp@latest`、env にはネットワーク到達可能な agentmemory デプロイを指す `AGENTMEMORY_URL` と `AGENTMEMORY_SECRET`(クラウドセッションは localhost に到達できません — [`deploy/`](../deploy/) 参照)。シークレットは Devin Secrets に保存し、「Test listing tools」で 54 ツールすべてが表示されることを確認してください。 |
| **Gemini CLI** | `~/.gemini/settings.json` | `gemini mcp add agentmemory npx -y @agentmemory/mcp --scope user`(自動マージ)。 |
| **GitHub Copilot CLI(MCP のみ)** | `~/.copilot/mcp-config.json` | `agentmemory connect copilot-cli` が `mcpServers.agentmemory` をマージします。Copilot は次回起動時または `/mcp` で認識します。 |
| **GitHub Copilot CLI(フルプラグイン)** | Copilot plugin install | GitHub のサブディレクトリにあるプラグインには `copilot plugin install rohitg00/agentmemory:plugin` を使用。 |
| **OpenClaw** | OpenClaw の MCP 設定 | 同じ `mcpServers` ブロック。より深く統合するには: `openclaw plugins install ./integrations/openclaw` が OpenClaw のメモリスロットを占有します(`memory-core` から自動切り替え)。`plugins.entries.agentmemory.hooks.allowConversationAccess=true` を設定しないと、キャプチャが静かにブロックされます。[`integrations/openclaw`](../integrations/openclaw/) 参照。 |
| **Codex CLI(MCP のみ)** | `.codex/config.toml` | TOML 形式: `codex mcp add agentmemory -- npx -y @agentmemory/mcp`、または `[mcp_servers.agentmemory]` を手動で追加。 |
| **Codex CLI(フルプラグイン)** | Codex plugin marketplace | `codex plugin marketplace add rohitg00/agentmemory` のあと `codex plugin add agentmemory@agentmemory`。MCP + 6 つのライフサイクル hooks + 17 skills を登録します。ホストで hooks を信頼し、キャプチャを確認してください。[Codex のセットアップと検証](../docs/plugins/codex-local.md)を参照。 |
| **OpenCode(MCP のみ)** | `opencode.json` | 異なる形式: トップレベルの `mcp` キー、コマンドは配列: `{"mcp": {"agentmemory": {"type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true}}}`。 |
| **OpenCode(フルプラグイン)** | `plugin/opencode/` | セッションのライフサイクル、メッセージ、ツール、エラーをカバーする 22 個の自動キャプチャ hooks。プロジェクトの帰属はセッション単位なので、複数のリポジトリにまたがる 1 つの OpenCode プロセスは、各セッションをそれぞれのプロジェクトに記録します。スラッシュコマンドは 2 つ(`/recall`、`/remember`)。`plugin/opencode/` を OpenCode のワークスペースにコピーし、プラグインエントリを `opencode.json` に追加してください。完全な hook 表とギャップ分析は [`plugin/opencode/README.md`](../plugin/opencode/README.md) 参照。 |
| **pi** | `~/.pi/agent/extensions/agentmemory` | `agentmemory connect pi` は、同梱の拡張を pi の自動検出ディレクトリにインストールします(エージェント開始時のリコール、エージェント終了時のキャプチャ、`memory_search` / `memory_save` / `memory_health` ツール、`/agentmemory-status`)。実行中の pi で `/reload` すれば反映されます。[`integrations/pi`](../integrations/pi/) は pi パッケージでもあります(チェックアウトから `pi install ./integrations/pi`)。 |
| **Hermes Agent** | `~/.hermes/config.yaml` | `cp -r integrations/hermes ~/.hermes/plugins/agentmemory` + `memory.provider: agentmemory` で、6 hooks のメモリプロバイダー(プリフェッチ、ターンキャプチャ、セッション終了、圧縮前処理、MEMORY.md ミラーリング、システムプロンプトブロック)が使えます。`hermes plugins doctor` と `hermes memory status` で検証してください。[`integrations/hermes`](../integrations/hermes/) 参照。 |
| **Qwen Code** | `~/.qwen/settings.json` | `agentmemory connect qwen` が標準の `mcpServers` ブロックを書き込みます。Hook のペイロードは Claude Code とフィールド互換なので、既存の 12 hook スクリプトは変更なしで動作します。同じ `settings.json` の `hooks` セクションで配線してください。 |
| **Antigravity IDE / 2.0** | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity --with-hooks` が共有のカスタマイズディレクトリに MCP とキャプチャ hooks をインストールします。[Antigravity のセットアップと制限](../docs/plugins/antigravity.md)を参照。 |
| **Antigravity CLI**(`agy`) | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity-cli --with-hooks` は現在の IDE バージョンと同じ MCP と hook の設定を使います。既存のインストールは `--force` で更新してください。[アップグレードノート](../docs/plugins/antigravity.md)を参照。 |
| **Kiro** | `~/.kiro/settings/mcp.json` | `agentmemory connect kiro` がユーザーレベルの設定を書き込みます。ワークスペース単位の上書きは、コードの隣にある `.kiro/settings/mcp.json` に書いてください。 |
| **Warp** | `~/.warp/.mcp.json` | `agentmemory connect warp` が標準の `mcpServers` ブロックを書き込みます。Warp は `.claude/skills/` からも skills を自動検出します。Claude Code プラグインをインストールすれば、8 つの agentmemory skills(`remember`、`recall`、`recap`、`handoff`、`forget`、`commit-context`、`commit-history`、`session-history`)が Warp のスラッシュコマンドパレットにネイティブで表示されます。 |
| **Cline(CLI)** | `~/.cline/mcp.json` | `agentmemory connect cline` が標準の `mcpServers` ブロックを書き込みます。VS Code 拡張を使う場合は、Cline Settings → MCP Servers → Edit JSON に同じブロックを貼り付けてください。 |
| **Continue.dev** | `~/.continue/config.yaml`(推奨)または `config.json`(レガシー) | `agentmemory connect continue` は、どちらも存在しない場合は新規に `config.yaml` を作成し、既存の `config.json` があればそれを変更します。**既に `config.yaml` がある場合**、アダプタは `mcpServers:` の下に貼り付ける正確なブロックを表示するだけです — コメントやアンカーを安全に保持するには YAML パーサーが必要で、このパッケージは同梱していないため、yaml を黙って書き換えることはありません。Continue は `mcpServers` に配列形式(オブジェクトではなく)を使います。 |
| **Zed** | `~/.config/zed/settings.json` | `agentmemory connect zed` は `context_servers`(`mcpServers` ではなく Zed 独自のキー)の下に書き込みます。リモート MCP サーバーは、代わりに `{"url": "..."}` で配線できます。 |
| **Droid(Factory.ai)** | `~/.factory/mcp.json` | `agentmemory connect droid` が標準の `mcpServers` ブロックを書き込みます。プロジェクト単位の上書きは `/.factory/mcp.json` に書いてください。`--with-hooks` を渡すとネイティブ自動キャプチャが使えます。 |
| **DeepSeek Harness** | `$DSH_HOME/cordis.patch.yml` | `agentmemory connect dsh` が、すべての Harness プロファイルが読み込むホームレベルのパッチ層に `@deepseek-ai/dsh-mcp-client` の行を追加します。ツールは `mcp__agentmemory__*` として登録されます。`--with-hooks` を渡すと自動キャプチャも配線されます: 同梱の Claude Code hook スクリプトが、Harness の純正の `@deepseek-ai/dsh-hooks-claude-code` ブリッジ(SessionStart、UserPromptSubmit、PreToolUse、PostToolUse、Stop)経由で、`$DSH_HOME/agentmemory.hooks.json` に書き込まれたマニフェストを通じて実行されます。`DSH_HOME` が未設定の場合は `~/.dsh` がデフォルトです。 |
| **Goose** | Goose の MCP 設定 UI | 同じ `mcpServers` ブロック。`goose configure` → Add Extension → MCP を使用。`~/.config/goose/config.yaml` の直接編集もサポートされていますが、スキーマは `mcpServers:` + `command` ではなく `extensions:` + `cmd` を使います。 |
| **Aider** | n/a | REST API に直接話しかけます: `curl -X POST http://localhost:3111/agentmemory/smart-search -d '{"query": "auth"}'`。 |
| **任意のエージェント(32+)** | n/a | `npx skillkit install agentmemory` がホストを自動検出してマージします。 |
ホストの `localhost` に到達できない**サンドボックス化された MCP クライアント**(Flatpak / Snap /制限の強いコンテナ)では、`env` ブロックに `"AGENTMEMORY_FORCE_PROXY": "1"` も設定し、`AGENTMEMORY_URL` をサンドボックスが実際に到達できるルート(例: あなたの LAN IP)に向けてください。
### プログラムによるアクセス(Python / Rust / Node)
agentmemory はコア操作を iii functions(`mem::remember`、`mem::observe`、`mem::context`、`mem::smart-search`、`mem::forget`)として登録します。iii SDK を持つあらゆる言語が `ws://localhost:49134` で直接これらを呼び出せます。言語ごとに個別の REST クライアントを用意する必要はありません。
```bash
pip install iii-sdk # Python
cargo add iii-sdk # Rust
npm install iii-sdk # Node
```
```python
from iii import register_worker
iii = register_worker("ws://localhost:49134")
iii.connect()
iii.trigger({
"function_id": "mem::smart-search",
"payload": {"project": "demo", "query": "how do tokens refresh"},
})
```
実例: [`examples/python/`](../examples/python/)(クイックスタート + 観測/リコールフロー)。iii ランタイムがないホスト向けに、`:3111` の REST も引き続き利用可能です。
### ソースから
```bash
git clone https://github.com/rohitg00/agentmemory.git && cd agentmemory
npm install && npm run build && npm start
```
これは、ピン留めされたバイナリが既にインストールされていればローカルの `iii-engine` で agentmemory を起動し、選択されていれば Docker Compose を使います。REST、ストリーム、ビューワーはデフォルトで `127.0.0.1` にバインドします。自動の macOS/Linux バイナリパスには `curl`、POSIX 準拠の `sh`、`tar` が必要です。
`iii-engine` を手動でインストールしてください。**agentmemory は現在 `iii-engine` を `v0.22.1` にピン留めしています** — これは `iii-sdk` 依存関係と同じリリースです。worker はそのエンジンの wire プロトコルを話し、0.20.0 で SDK の API サーフェスが再編されたため、両者は agentmemory のリリースで一緒に移動します。自前のエンジンを運用していて一致していると分かっている場合は、`AGENTMEMORY_III_VERSION=` で上書きできます。
- **macOS arm64:** `mkdir -p ~/.local/bin && curl -fsSLo iii.tar.gz https://github.com/iii-hq/iii/releases/download/iii/v0.22.1/iii-aarch64-apple-darwin.tar.gz && echo "2b309019b909a896cae874dc947e2cdf877b4f3c51dd026b79850af858517fa4 iii.tar.gz" | shasum -a 256 -c - && tar -xzf iii.tar.gz -C ~/.local/bin && chmod +x ~/.local/bin/iii`
- **macOS x64:** `aarch64-apple-darwin` を `x86_64-apple-darwin` に差し替え
- **Linux x64:** `x86_64-unknown-linux-gnu` に差し替え
- **Linux arm64:** `aarch64-unknown-linux-gnu` に差し替え
- **Windows:** [iii-hq/iii releases v0.22.1](https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1) から `iii-x86_64-pc-windows-msvc.zip` をダウンロードし、`iii.exe` を `%USERPROFILE%\.agentmemory\bin\iii.exe` に展開
リリースページには、各アーカイブに対応する `.sha256` ファイルがあります。プラットフォームを差し替えるときは、上記の確認でそのファイルのハッシュを使ってください(Windows では `Get-FileHash`)。`npx @agentmemory/agentmemory` の自動インストーラはこれらのハッシュにピン留めされており、一致しないアーカイブは拒否します。
または Docker を使います(同梱の `docker-compose.yml` は `iiidev/iii:0.22.1` を pull します)。完全なドキュメント: [iii.dev/docs](https://iii.dev/docs)。
### Windows
agentmemory は Windows 10/11 で動作しますが、Node.js パッケージだけでは不十分です。ピン留めされた iii-engine v0.22.1 のランタイムをバックグラウンドプロセスとして用意する必要もあります。CLI は Windows 用 ZIP を自動展開しないため、ネイティブ Windows ユーザーは `iii.exe` を手動でインストールするか、WSL2 を使うか、Docker Desktop を選ぶ必要があります。
ネイティブ Windows の自動化された MCP 配線がサポートするのは `agentmemory connect copilot-cli` のみです。Claude Code、Codex、Cursor、その他すべてのネイティブ Windows エージェントについては、[その他のエージェント](#other-agents)の手動 MCP ブロックをそのエージェントの Windows 用設定にコピーしてください。WSL 内で `connect` を実行するのが適切なのは、対象のエージェントも同じ WSL 環境にインストールされている場合だけです。Windows ホスト側のエージェントの設定を編集することはありません。
**選択肢 A: ビルド済み Windows バイナリ(推奨)**
```powershell
# 1. Open https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1 in your browser
# (agentmemory pins the engine to the same release as its iii-sdk;
# v0.22.1 is the current pair)
# 2. Download iii-x86_64-pc-windows-msvc.zip
# (or iii-aarch64-pc-windows-msvc.zip if you're on an ARM machine)
# 3. Extract iii.exe to agentmemory's private engine directory:
New-Item -ItemType Directory -Force "$HOME\.agentmemory\bin"
# Copy iii.exe to $HOME\.agentmemory\bin\iii.exe
# 4. Verify:
& "$HOME\.agentmemory\bin\iii.exe" --version
# Should print: 0.22.1
# 5. Then run agentmemory as usual:
npx -y @agentmemory/agentmemory@latest
```
**選択肢 B: Docker Desktop**
```powershell
# 1. Install Docker Desktop for Windows
# 2. Start Docker Desktop and make sure the engine is running
# 3. Select Docker explicitly and run agentmemory:
$env:AGENTMEMORY_USE_DOCKER = "1"
npx -y @agentmemory/agentmemory@latest
```
**選択肢 C: MCP のみのスタンドアロン(エンジン不要)。** エージェント用の MCP ツールだけが必要で、REST API、ビューワー、cron ジョブが不要なら、エンジンそのものをスキップできます:
```powershell
npx -y @agentmemory/agentmemory@latest mcp
# or via the shim package:
npx -y @agentmemory/mcp
```
**Windows での診断:** `npx -y @agentmemory/agentmemory@latest` が失敗する場合は、`--verbose` を付けて再実行し、実際のエンジンの stderr を確認してください。よくある失敗パターン:
| 症状 | 対処 |
|---|---|
| `The engine process started but the REST API never responded.` | 4 つの派生ポートすべてが空いていることを確認し、ピン留めされた `iii.exe` が動き続けていることを確認した上で、`--verbose` を付けて再実行し、キャプチャされたエンジンの stderr を調べてください |
| `Could not start iii-engine` | `iii.exe` も Docker もインストールされていません。上の選択肢 A か B を参照してください |
| ポート競合 | `netstat -ano \| findstr :3111` で何がバインドされているか確認し、それを kill するか `--port ` を使ってください |
| Docker がインストールされているのにフォールバックがスキップされる | Docker Desktop が実際に起動していることを確認してください(システムトレイのアイコン) |
> 注: iii **エンジン**はビルド済みバイナリであり、cargo crate ではありません。`cargo install` しようとしないでください。(iii **SDK**は crates.io、npm、PyPI に公開されていますが、agentmemory にはそれらは不要です。)サポートされているエンジンのインストール方法はすべて v0.22.1 にピン留めされています: 上記のビルド済みバイナリ、agentmemory の macOS/Linux 自動インストール経路(`curl`、POSIX `sh`、`tar` が必要)、そして Docker イメージ `iiidev/iii:0.22.1` です。素の上流 `install.sh | sh` は最新のエンジンをインストールしますが、agentmemory はそれをサポートしません。`npx -y @agentmemory/agentmemory@latest` を使ってください。macOS/Linux では、これがピン留めされたエンジンを `~/.agentmemory/bin` に取得します。
---
デプロイ
マネージドホスト向けのワンクリックテンプレートです。それぞれが、npm から
`@agentmemory/agentmemory` を取得し、公式の `iiidev/iii` Docker Hub
イメージから iii engine バイナリをコピーしてくる自己完結型の
Dockerfile を同梱しているため、ビルド済みの agentmemory イメージは不要です。
永続ストレージは `/data` にマウントされ、初回起動時のエントリポイントが、
npm に同梱された(`127.0.0.1` にバインドする)iii の設定を、
`0.0.0.0` にバインドし絶対パスの `/data` を使うデプロイ用の設定に上書きし、
HMAC シークレットを生成した上で、`gosu` で `root` から `node` に
権限を落として agentmemory の CLI を実行します。
Render のワンクリックデプロイボタンはリポジトリルートに `render.yaml` を要求しますが、ルートはあえて綺麗なまま保っています。[`deploy/render/`](.././deploy/render/README.md) にドキュメント化された Render Blueprint フローを使い、リポジトリ内のブループリントを手動で指してください。
完全なセットアップ詳細(HMAC キャプチャ、ビューワーの SSH トンネル、ローテーション、バックアップ、コスト下限)は [`deploy/`](.././deploy/README.md) を参照してください:
- [`deploy/fly`](.././deploy/fly/README.md): 単一マシンで
`auto_stop_machines = "stop"`。アイドル時最安。
- [`deploy/railway`](.././deploy/railway/README.md): Hobby プラン定額、
ボリュームはダッシュボードで管理。
- [`deploy/render`](.././deploy/render/README.md): Blueprint フロー、
有料プランで自動ディスクスナップショット。
- [`deploy/coolify`](.././deploy/coolify/README.md): [Coolify](https://coolify.io/self-hosted)
経由で自前の VPS にセルフホスト。同じ Docker
Compose スタックを使い、ホストとデータは自分の手元に残ります。
公開されるのはポート `3111` のみです。`3113` のビューワーは
コンテナ内でループバックにバインドされたままになります。各テンプレートの
README に、そこへ到達するための SSH トンネルパターンが記載されています。
---

すべてのコーディングエージェントはセッションが終わるとすべてを忘れ、新しいセッションはあなたがスタックを説明し直すところから始まります。agentmemory はバックグラウンドで動作し、そのステップをなくします。
```text
Session 1: "Add auth to the API"
Agent writes code, runs tests, fixes bugs
agentmemory silently captures every tool use
Session ends -> observations compressed into structured memory
Session 2: "Now add rate limiting"
Agent already knows:
- Auth uses JWT middleware in src/middleware/auth.ts
- Tests in test/auth.test.ts cover token validation
- You chose jose over jsonwebtoken for Edge compatibility
Zero re-explaining. Starts working immediately.
```
### 組み込みエージェントメモリとの比較
すべての AI コーディングエージェントには組み込みのメモリが付属します — Claude Code には `MEMORY.md`、Cursor には notepad、Cline には memory bank。これらは付箋のようなものです。agentmemory はその付箋の背後にある検索可能なデータベースです。
| | 組み込み (CLAUDE.md) | agentmemory |
|---|---|---|
| スケール | 200 行上限 | 無制限 |
| 検索 | すべてをコンテキストにロード | BM25 + ベクトル + グラフ(top-K のみ) |
| トークンコスト | 240 観測で 22K+ | ~1,900 トークン(92% 削減) |
| クロスエージェント | エージェントごとのファイル | MCP + REST(任意のエージェント) |
| 調整 | なし | リース、シグナル、アクション、ルーチン |
| 可観測性 | 手動でファイルを読む | ポート 3113 のリアルタイムビューワー |
---

### メモリパイプライン
```text
PostToolUse hook fires
-> SHA-256 dedup (5min window)
-> Privacy filter (strip secrets, API keys)
-> Store raw observation
-> Synthetic compression by default
(LLM-written compression only with a provider + AGENTMEMORY_AUTO_COMPRESS=true)
-> Vector embedding when an embedding provider is active
-> Index in BM25, plus vectors when enabled
Stop / SessionEnd hook fires
-> Summarize session
-> Knowledge graph extraction (if GRAPH_EXTRACTION_ENABLED=true)
-> Slot reflection (if SLOT_REFLECT_ENABLED=true)
SessionStart hook fires
-> Load project profile (top concepts, files, patterns)
-> Hybrid search (BM25 + vector + graph)
-> Token budget (default: 2000 tokens)
-> Inject into conversation
```
### 4 層メモリ統合
人間の脳が記憶を処理する方法(睡眠時の記憶統合を含む)をモデルにしています。
| 層 | 内容 | 例え |
|------|------|---------|
| **Working(作業記憶)** | ツール使用からの生観測 | 短期記憶 |
| **Episodic(エピソード記憶)** | 圧縮されたセッション要約 | 「何が起きたか」 |
| **Semantic(意味記憶)** | 抽出された事実とパターン | 「何を知っているか」 |
| **Procedural(手続き記憶)** | ワークフローと意思決定パターン | 「どうやるか」 |
記憶は時間とともに減衰します(エビングハウス曲線)。頻繁にアクセスされる記憶は強化されます。古い記憶は自動退避されます。矛盾は検出され解決されます。
### 何がキャプチャされるか
| Hook | キャプチャ内容 |
|------|----------|
| `SessionStart` | プロジェクトパス、セッション ID |
| `UserPromptSubmit` | ユーザープロンプト(プライバシーフィルタ済み) |
| `PreToolUse` | ファイルアクセスパターン + 富化されたコンテキスト |
| `PostToolUse` | ツール名、入力、出力 |
| `PostToolUseFailure` | エラーコンテキスト |
| `PreCompact` | コンパクション前にメモリを再注入 |
| `SubagentStart/Stop` | サブエージェントのライフサイクル |
| `Stop` | セッション終了時の要約 |
| `SessionEnd` | セッション完了マーカー |
### 主な機能
| 機能 | 説明 |
|---|---|
| **自動キャプチャ** | hooks で毎ツール使用を記録、手動作業なし |
| **セマンティック検索** | BM25 + ベクトル + ナレッジグラフ、RRF 融合 |
| **メモリ進化** | バージョン管理、上書き、関係グラフ |
| **リコール衛生** | 上書き(supersede)されたメモリバージョンは検索インデックスから外れ、KV のバージョンチェーンが全履歴を保持します |
| **近接重複ヒント** | 新しい内容が既存メモリに酷似している場合、保存時に参考情報として `similarTo` の一致を報告します |
| **エージェント別スコープ** | `agentId` が REST、MCP、検索インデックスを貫いて保存とリコールに通り、共有モードと分離モードに対応します |
| **書き込み時の来歴** | すべての観測とメモリが、キャプチャ・保存・インポート時に刻印された不変のオリジンチャネル(user、agent、tool、import、shared)を保持します |
| **自動忘却** | TTL 期限切れ、矛盾検出、重要度退避 |
| **プライバシー優先** | API キー、シークレット、`` タグは保存前に除去 |
| **自己修復** | サーキットブレーカー、プロバイダーフォールバックチェーン、ヘルスモニタ |
| **Claude ブリッジ** | MEMORY.md との双方向同期 |
| **ナレッジグラフ** | エンティティ抽出 + BFS 探索 |
| **チームメモリ** | チームメンバー間で名前空間化された共有 + プライベート |
| **引用の出所追跡** | あらゆるメモリを元の観測まで遡れます |
| **Git スナップショット** | メモリ状態のバージョン管理、ロールバック、diff |
---

3 つの信号を組み合わせたトリプルストリーム検索:
| ストリーム | やること | いつ有効か |
|---|---|---|
| **BM25** | 同義語展開付きのステミングされたキーワードマッチ | 常時オン |
| **ベクトル** | 密な埋め込みに対するコサイン類似度 | 埋め込みプロバイダーが設定されているとき |
| **グラフ** | エンティティマッチによるナレッジグラフ探索 | クエリ内にエンティティが検出されたとき |
Reciprocal Rank Fusion(RRF、k=60)で融合し、セッションごとに多様化されます(セッションあたり最大 3 件)。
ベクトルインデックスが構築されている場合、`mem::search`(`memory_recall` の背後)はハイブリッドな BM25 + ベクトルランカーを使います。埋め込みがない場合は BM25 を使います。`smart-search` は、キーレスモードでも、グラフデータが存在する場合は構造的なグラフマッチをさらに融合できます。レッスンのリコールは、クエリごとにコーパス全体をスキャンするのではなく、専用のインメモリ BM25 インデックス上で動作します。上書きされたメモリバージョンはすべてのリコール経路から除外されます。バージョンチェーンがその履歴を保持します。
ベクトルはクラッシュや強制終了を生き延びます。ベクトルインデックスは、少なくとも `AGENTMEMORY_INDEX_SAVE_INTERVAL_MS`(10 分)ごとにバケット単位で保存されます。その間に追加・削除されたベクトルはすべて、ステートストア内の小さな保留ログにも即座に書き込まれ、次回起動時にそれが埋め込みプロバイダーを呼び出さずに再生されます。保存が成功するたびにそのログは空になります。再生後もベクトルを持たないドキュメントは、何も残らなくなるまで `AGENTMEMORY_VECTOR_BACKFILL_MAX`(500)件のバッチでバックグラウンドで再埋め込みされ、中断されたバックフィルは次回起動時に続行されます。`/agentmemory/status` とビューワーは、保留ログのサイズとバックフィルの状態を表示します。キーレスインストールは何も書き込みません。
BM25 は、ギリシャ語、キリル文字、ヘブライ語、アラビア語、アクセント付きラテン文字をそのままトークン化します。中国語 / 日本語 / 韓国語のメモリについては、オプションのセグメンタ(`npm install @node-rs/jieba tiny-segmenter`)をインストールすると、CJK の文字列を単語レベルのトークンに分割できます。インストールしない場合、agentmemory は文字列全体をそのままトークン化するようソフトにフォールバックし、stderr に 1 回だけヒントを表示します。
### 埋め込みプロバイダー
キーレスインストールではベクトル埋め込みが無効になります: `mem::search` は BM25 を使い、`smart-search` は既存の構造的なグラフデータも使えます。無料のオンデバイスなセマンティック埋め込みにオプトインするには、`~/.agentmemory/.env` に以下を追加して agentmemory を再起動してください:
```env
EMBEDDING_PROVIDER=local
```
通常の npm インストールには、オプションの `@huggingface/transformers` ランタイムが含まれています。最初の埋め込みリクエストで `Xenova/all-MiniLM-L6-v2` がダウンロードされるため、ネットワークアクセスが必要で時間がかかることがあります。それ以降の推論はオンデバイスで実行されます。リモートプロバイダーは、`EMBEDDING_PROVIDER` で上書きされない限り、それぞれのキーから自動検出されます。
| プロバイダー | モデル | コスト | 備考 |
|---|---|---|---|
| **ローカル(推奨オプトイン)** | `all-MiniLM-L6-v2` | 無料 | 最初のモデルダウンロード後はオンデバイス。BM25 のみに比べて R@5 +8pp |
| Gemini | `gemini-embedding-001` | 無料枠 | 100+ 言語、768/1536/3072 次元(MRL)、2048 トークン入力。`text-embedding-004`([非推奨、2026 年 1 月 14 日に終了](https://ai.google.dev/gemini-api/docs/deprecations))の後継 |
| OpenAI | `text-embedding-3-small` | $0.02/1M | 最高品質 |
| Voyage AI | `voyage-code-3` | 有料 | コードに最適化 |
| Cohere | `embed-english-v3.0` | 無料トライアル | 汎用 |
| OpenRouter | 任意のモデル | 様々 | マルチモデルプロキシ |
---

54 ツール、6 リソース、3 プロンプト、17 skills。
> **MCP shim とフルサーバー:** 公開されている `@agentmemory/mcp` パッケージは薄い shim です。**`AGENTMEMORY_URL` 経由で動作中の agentmemory サーバーに到達できる場合に限り**、完全な 54 ツール群を公開します(プロキシモード)。サーバーに到達できない場合、shim は 7 ツールのローカルセット(`memory_save`、`memory_recall`、`memory_smart_search`、`memory_sessions`、`memory_export`、`memory_audit`、`memory_governance_delete`)にフォールバックします。`AGENTMEMORY_TOOLS=core|all` 環境変数は*サーバー側*のフラグです — shim の `env` ブロックで設定しても効果はありません。Cursor / OpenCode / Gemini CLI で 7 ツールしか見えない場合は、`npx -y @agentmemory/agentmemory@latest`(または Docker スタック)を起動し、`AGENTMEMORY_URL=http://localhost:3111` を設定してください。
### 54 ツール
ツールの公開範囲は小さい順に 3 段階: `AGENTMEMORY_TOOLS=core` は表示を 8 個の必須ツール(`memory_save`、`memory_recall`、`memory_consolidate`、`memory_smart_search`、`memory_sessions`、`memory_diagnose`、`memory_lesson_save`、`memory_reflect`)に絞ります。下の基本セットはレジストリの基盤となる 14 ツール、デフォルト(`AGENTMEMORY_TOOLS=all`)は 54 個すべてを公開します。
基本ツール(14)
| ツール | 説明 |
|------|-------------|
| `memory_recall` | 過去の観測を検索 |
| `memory_compress_file` | 構造を保持したまま markdown ファイルを圧縮 |
| `memory_save` | 洞察、決定、パターンを保存 |
| `memory_file_history` | 特定ファイルに関する過去の観測 |
| `memory_patterns` | 繰り返し現れるパターンを検出 |
| `memory_sessions` | 最近のセッション一覧 |
| `memory_smart_search` | ハイブリッドなセマンティック + キーワード検索 |
| `memory_vision_search` | 画像観測を検索 |
| `memory_timeline` | 時系列の観測 |
| `memory_profile` | プロジェクトプロファイル(概念、ファイル、パターン) |
| `memory_export` | すべてのメモリデータをエクスポート |
| `memory_relations` | 関係グラフを照会 |
| `memory_commit_lookup` | git コミットの背後にあるセッション |
| `memory_commits` | セッションに記録されたコミット |
拡張ツール(全 54、デフォルトの公開範囲)
| ツール | 説明 |
|------|-------------|
| `memory_patterns` | 繰り返し現れるパターンを検出 |
| `memory_timeline` | 時系列の観測 |
| `memory_relations` | 関係グラフを照会 |
| `memory_graph_query` | ナレッジグラフ探索 |
| `memory_consolidate` | 4 層統合を実行 |
| `memory_claude_bridge_sync` | MEMORY.md と同期 |
| `memory_team_share` | チームメンバーと共有 |
| `memory_team_feed` | 最近の共有アイテム |
| `memory_audit` | 操作の監査証跡 |
| `memory_governance_delete` | 監査証跡付き削除 |
| `memory_snapshot_create` | Git バージョンスナップショット |
| `memory_action_create` | 依存関係付き作業項目を作成 |
| `memory_action_update` | アクションのステータス更新 |
| `memory_frontier` | 優先度順のブロック解除済みアクション |
| `memory_next` | 次に最も重要なアクション 1 つ |
| `memory_lease` | 排他的アクションリース(マルチエージェント) |
| `memory_routine_run` | ワークフロールーチンをインスタンス化 |
| `memory_signal_send` | エージェント間メッセージング |
| `memory_signal_read` | 受領確認付きでメッセージを読む |
| `memory_checkpoint` | 外部条件ゲート |
| `memory_mesh_sync` | インスタンス間 P2P 同期 |
| `memory_sentinel_create` | イベント駆動ウォッチャー |
| `memory_sentinel_trigger` | 外部からセンチネルを発火 |
| `memory_sketch_create` | 一時的なアクショングラフ |
| `memory_sketch_promote` | 永続化に昇格 |
| `memory_crystallize` | アクションチェーンをコンパクト化 |
| `memory_diagnose` | ヘルスチェック |
| `memory_heal` | 詰まった状態を自動修復 |
| `memory_facet_tag` | 次元:値タグ |
| `memory_facet_query` | facet タグで照会 |
| `memory_verify` | 出所を追跡 |
### 6 リソース · 3 プロンプト · 17 Skills
| 種類 | 名前 | 説明 |
|------|------|-------------|
| Resource | `agentmemory://status` | ヘルス、セッション数、メモリ数 |
| Resource | `agentmemory://project/{name}/profile` | プロジェクト別インテリジェンス |
| Resource | `agentmemory://project/{name}/recent` | プロジェクトの最近の観測 |
| Resource | `agentmemory://memories/latest` | 直近 10 件のアクティブメモリ |
| Resource | `agentmemory://graph/stats` | ナレッジグラフ統計 |
| Resource | `agentmemory://team/{id}/profile` | 共有チームプロファイル |
| Prompt | `recall_context` | 検索してコンテキストメッセージを返す |
| Prompt | `session_handoff` | エージェント間でのハンドオフデータ |
| Prompt | `detect_patterns` | 繰り返し現れるパターンを分析 |
| Skill | `/recall` | メモリを検索 |
| Skill | `/remember` | 長期メモリに保存 |
| Skill | `/session-history` | 最近のセッション要約 |
| Skill | `/forget` | 観測/セッションを削除 |
この表は 4 つのコア skills を示しています。フルセットは 9 個の呼び出し可能な skills と 8 個のリファレンス skills です。上の「ネイティブ skills」セクションを参照してください。
### スタンドアロン MCP
フルサーバーなしで実行 — 任意の MCP クライアント向け。以下のどちらも動きます:
```bash
npx -y @agentmemory/agentmemory@latest mcp # canonical (always available)
npx -y @agentmemory/mcp # shim package alias
```
またはエージェントの MCP 設定に追加してください:
ほとんどのエージェント(Cursor、Claude Desktop、Cline、Roo Code、Gemini CLI):
```json
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
```
`agentmemory` エントリは、ファイルを置き換えるのではなく、ホストの既存 `mcpServers` オブジェクトにマージしてください。ホストの `localhost` に到達できないサンドボックスクライアントには、env ブロックに `"AGENTMEMORY_FORCE_PROXY": "1"` を追加し、`AGENTMEMORY_URL` をサンドボックスが到達できるルートに設定してください。
OpenCode(`opencode.json`):
```json
{
"mcp": {
"agentmemory": {
"type": "local",
"command": ["npx", "-y", "@agentmemory/mcp"],
"enabled": true
}
},
"plugin": ["./plugins/agentmemory-capture.ts"]
}
```
リポジトリからプラグインファイルをコピーします:
```bash
mkdir -p ~/.config/opencode/plugins
cp plugin/opencode/agentmemory-capture.ts ~/.config/opencode/plugins/
cp plugin/opencode/commands/*.md ~/.config/opencode/commands/
```
---

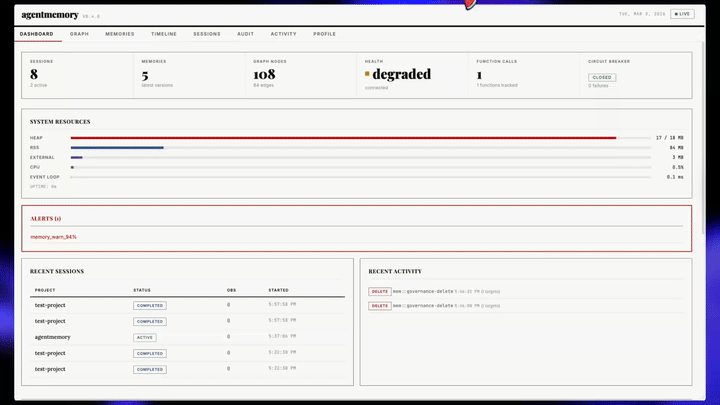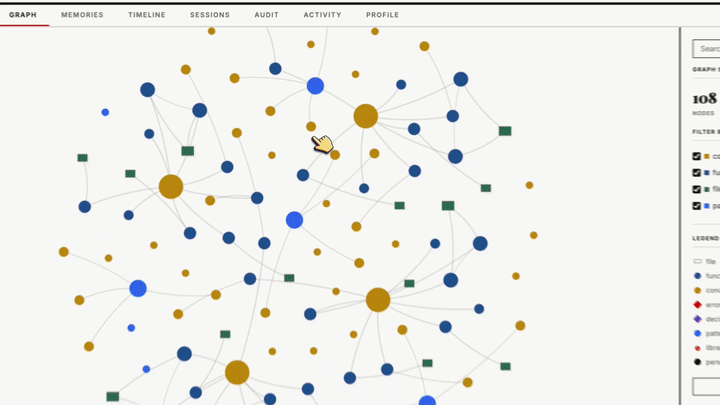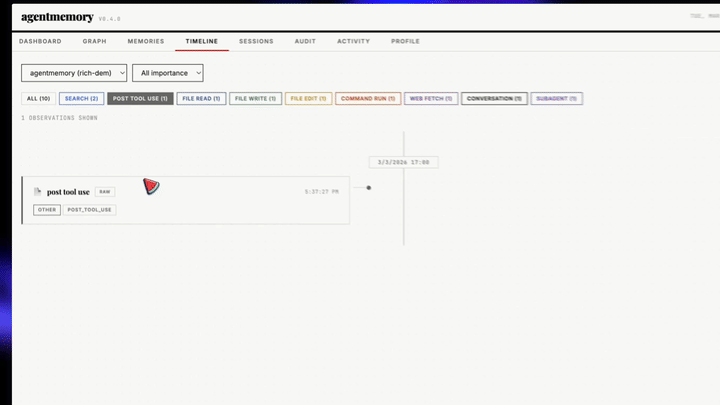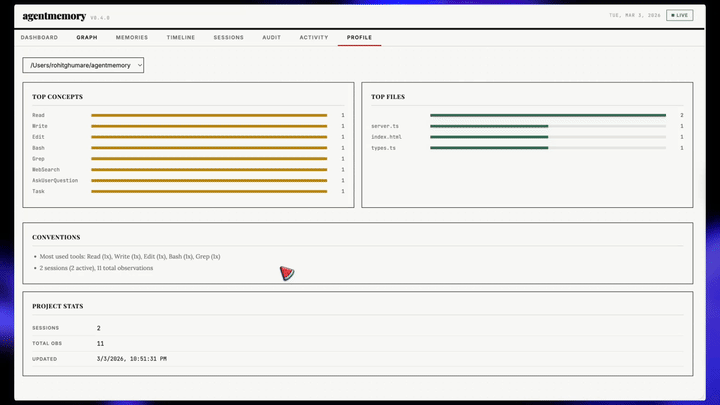
ポート `3113` で自動起動します。ビューワーは接続時に 1 回スナップショットを読み込み(`GET /agentmemory/viewer/snapshot`)、その後はライブのストリームイベントを適用します: 新しいメモリ、レッスン、観測、監査エントリ、グラフの変化、ヘルス更新が、ポーリングやページの再読み込みなしに表示されます。それ以外のリクエストは、クリックしたアクション、「もっと読み込む」のページ送り、検索だけです。ストリームが切断されると、ビューワーは数値がどれだけ古いかを示し、バックオフしながら再接続し、1 回のスナップショットから再同期します。
- **4 グループにまたがる 12 個のタブ**。ライブカウント、ディープリンク(`#memories/`、`#sessions/?obs=`、`#graph/`、`#health/consolidation`)、キーボードショートカット、モバイル用メニューを備えています。
- **Memories:** サーバー側検索、プロジェクト・エージェント・タイプによるフィルタ、バージョンチェーンと単語単位の diff を含む詳細パネル、来歴リンク、id・MCP 呼び出し・curl コマンドのコピーボタン、編集(新しいバージョンとして)、確認付きの forget、一括 forget、JSON エクスポート。
- **Sessions:** 読みやすいツール入出力付きのインラインな観測タイムライン、フィルタとページ送り、各セッションが生んだメモリとレッスン。
- **Graph:** 検索、関係とソースを含むノード詳細、色だけに依存しない凡例、ズームコントロール。
- **Health:** `GET /agentmemory/status` のライブ版。すべての問題にはその修正方法が添えられ、さらにステートバックエンド、インデックス保存の状態、グラフの来歴コンパクション進捗、実際のしきい値付きの統合の説明も表示されます。
- **Audit、Activity、Profile、Replay、Lessons、Actions、Crystals** の各ページ。それぞれ、そのセクションが何なのか、なぜ空なのか、何のコマンドで埋まるのかを示す空状態と、すべての用語・数値に付く `?` の用語集ツールチップがあります。
```bash
open http://localhost:3113
```
ビューワーサーバーはデフォルトで `127.0.0.1` にバインドし、REST API へリクエストを転送する際にサーバーシークレットを添付するため、追加の設定は不要です。REST 経由で提供される `/agentmemory/viewer` エンドポイントは通常のベアラートークン規則に従い、トークンを持たないブラウザをビューワーのポートにリダイレクトします。CSP ヘッダーはレスポンスごとのスクリプト nonce を使い、インラインハンドラ属性を無効化します(`script-src-attr 'none'`)。
---
`:3113` のビューワーはエージェントが**覚えた**ことを見せます。[iii コンソール](https://iii.dev/docs/console)はエージェントが**やった**ことを見せます: 各メモリ操作は OpenTelemetry トレース、各 KV エントリは編集可能、各 function は呼び出し可能、各ストリームは tap 可能です。同じメモリへの 2 つの窓: 一方はプロダクト形、もう一方はエンジン形です。
`memory_smart_search` の発火を眺め、BM25 スキャン → 埋め込み参照 → RRF 融合 → リランカーをウォーターフォールで見ます。KV ブラウザで詰まった統合タイマーを編集します。調整したペイロードで `PostToolUse` hook を再生します。WebSocket ストリームをピンして観測がライブで着地するのを眺めます。
agentmemory はこれを無料で提供します。すべての function 呼び出しとトリガーが iii を通って発火するからです。カスタム実装も計装も不要です。
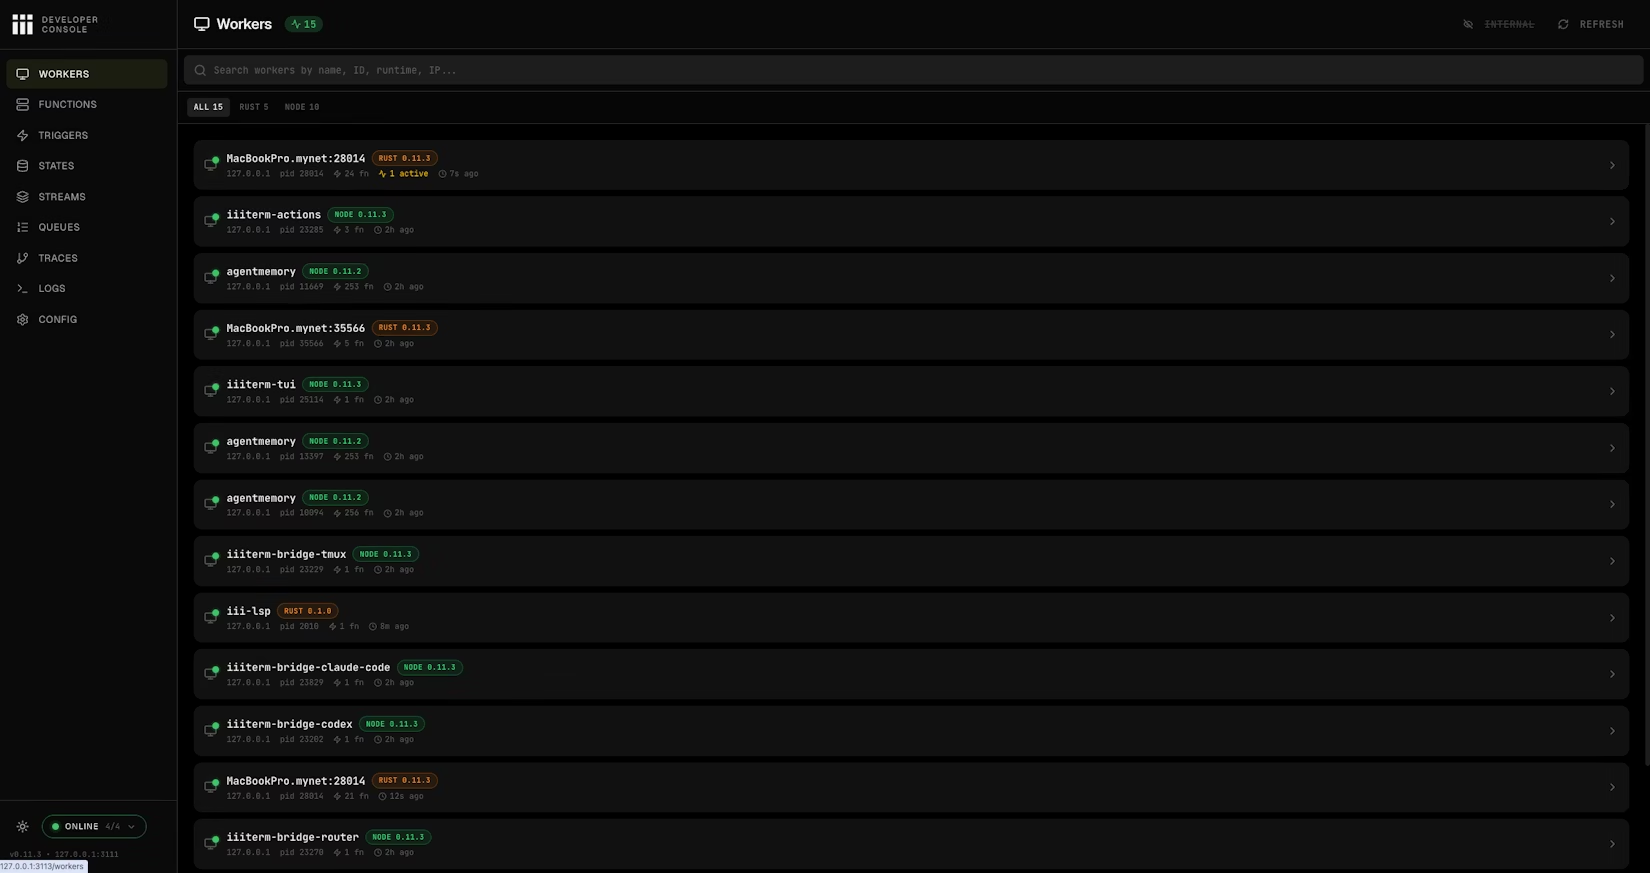
Workers ページ: agentmemory 自身を含む、接続中のすべての worker と PID、function 数、ランタイム、最終応答時刻。
**インストール済みです。** コンソールはピン留めされた `iii` エンジン(0.22+)に同梱されており、別途インストールするものはありません。初回起動時に、エンジンの隣にコンソールのバイナリがダウンロードされます。
**agentmemory と並行して起動:**
```bash
agentmemory console
```
これは、ピン留めされたエンジンの `iii console` を agentmemory が解決したポート(REST、ストリーム、bridge)に対して実行し、ビューワーより 1 つ上のポート、デフォルトでは `http://localhost:3114` で提供します。`--console-port N` で別のポートを選べます。`--port` と `--instance` は、`stop` のときと同じ方法で agentmemory のインスタンスを選択します。その他のフラグはそのまま渡されます。例えば、実験的なアーキテクチャグラフページ用の `--enable-flow` です。
PATH に `agentmemory` が通っていない場合に便利な、手動での同じ操作:
```bash
~/.agentmemory/bin/iii console --port 3114 \
--engine-port 3111 \
--ws-port 3112 \
--bridge-port 49134
```
**コンソールでできること:**
| ページ | 用途 |
|------|-----------|
| **Workers** | agentmemory worker 自身を含む、接続中の各 worker とライブメトリクスを表示。 |
| **Functions** | JSON ペイロードを与えて agentmemory の任意の function を直接呼び出せます。クライアントを配線せずに `memory.recall`、`memory.consolidate`、`graph.query` をテストできて便利です。 |
| **Triggers** | HTTP、cron、イベント、ステートのトリガーを再生します: 統合 cron を手動で発火、HTTP ルートを再試行、ステート変更を発行。 |
| **States** | セッション、メモリスロット、ライフサイクルタイマー、埋め込みインデックスに対するフル CRUD の KV ブラウザ。値をその場で編集できます。 |
| **Streams** | メモリ書き込み、hook イベント、観測更新が iii ストリームを流れる様子をライブで監視する WebSocket モニタ。 |
| **Queues** | 永続キューのトピック + デッドレター管理。失敗した埋め込み / 圧縮ジョブを再生または破棄できます。 |
| **Traces** | OpenTelemetry のウォーターフォール / フレーム / サービスブレークダウンのビュー。`trace_id` でフィルタすれば、単一の `memory.search` がどの function、DB 呼び出し、埋め込みリクエストを生んだか正確にわかります。 |
| **Logs** | trace/span ID に絞り込み・関連付けされた構造化 OTEL ログ。 |
| **Config** | ランタイム設定: エンジンがどの worker、プロバイダー、ポートで動いているかを正確に確認できます。 |
| **Flow** | (オプション、`--enable-flow`)各 worker、トリガー、ストリームの対話型アーキテクチャグラフ。 |
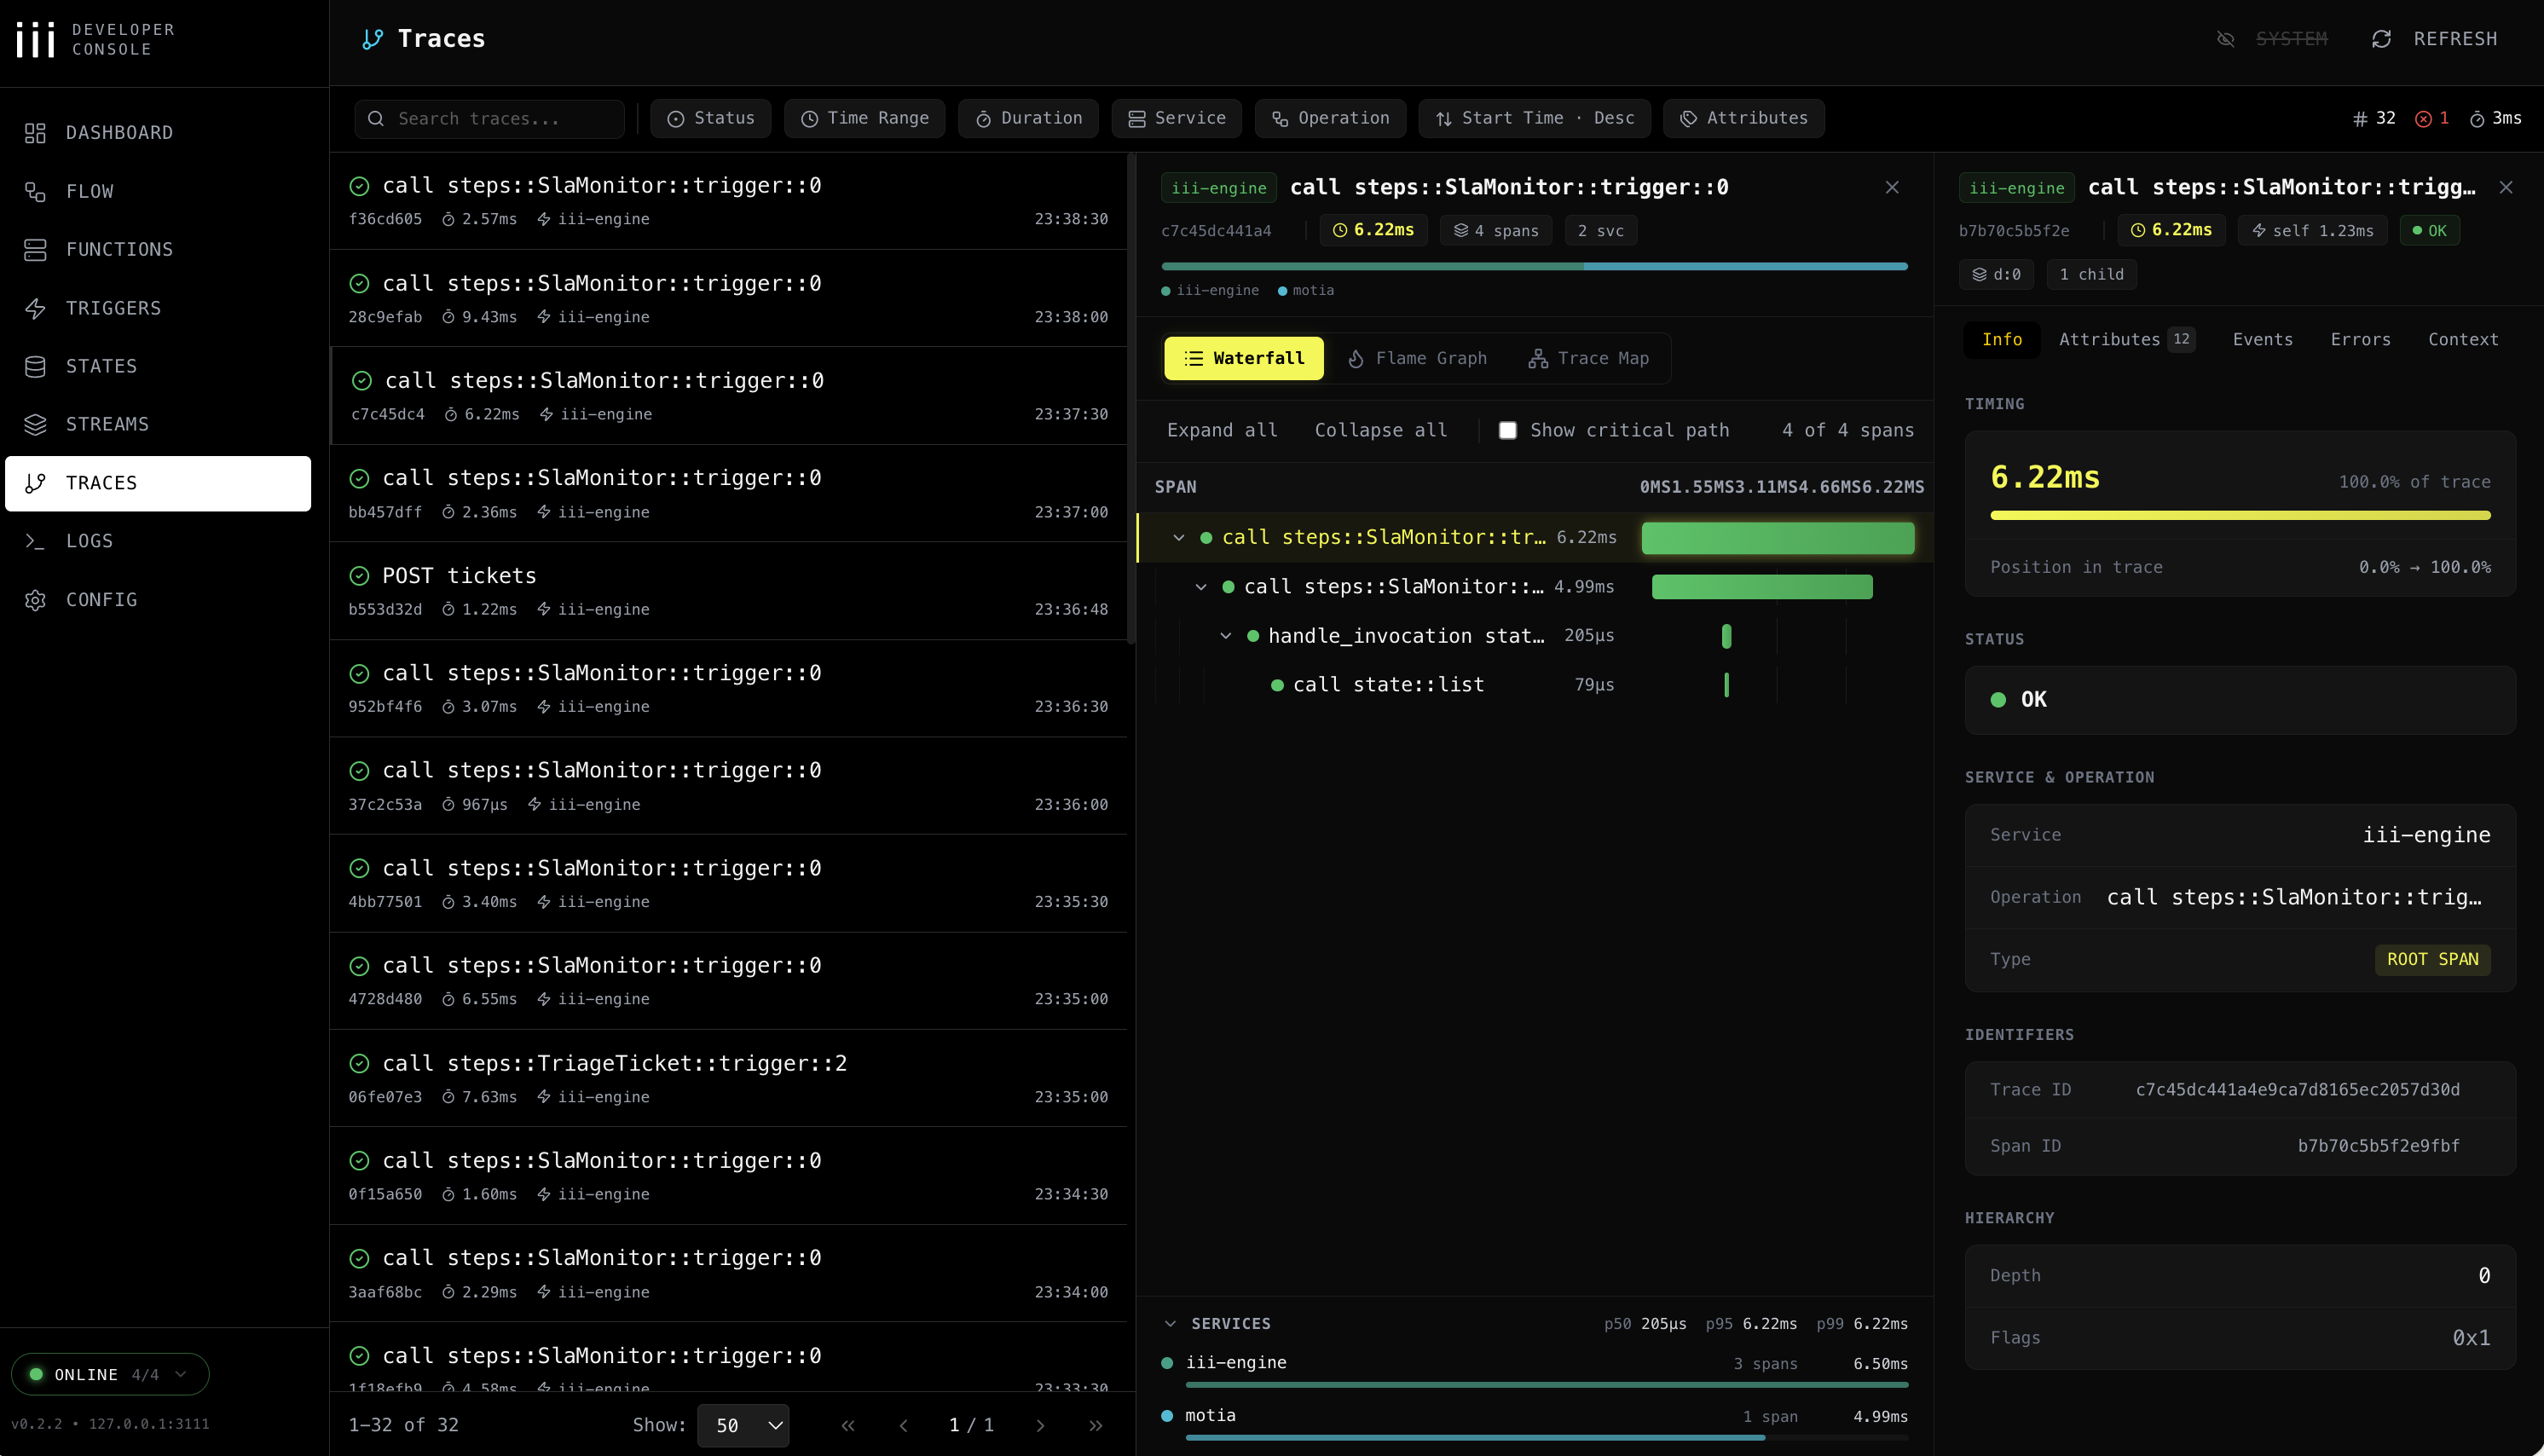
Traces: すべてのメモリ操作についてのウォーターフォール / フレーム / サービスブレークダウン。
**Traces は既にオンです:**
`iii-config.yaml` は出荷時から `iii-observability` worker を有効化しています(`exporter: memory`、`sampling_ratio: 0.1`、メトリクス + ログ)。追加の設定は不要です。agentmemory が起動した瞬間に、すべてのメモリ操作がコンソールが読み取れる構造化ログを出し、そのうち 10 分の 1(`sampling_ratio: 0.1`)はトレーススパンも出します。
代わりに Jaeger / Honeycomb / Grafana Tempo へエクスポートしたい場合は、`exporter: memory` を `exporter: otlp` に変更し、iii の可観測性ドキュメントに従ってコレクタのエンドポイントを設定してください。
> **注意:** コンソール自体には認証が強制されていません。デフォルトの `127.0.0.1` バインドのままにし、決して公開しないでください。
---

agentmemory は**それ自体が稼働中の [iii](https://iii.dev) インスタンス**です。3 つのプリミティブ(worker、function、トリガー)がランタイムを構成し、KV ステート、ストリーム、OTEL トレースは、iii に同梱される iii-state、iii-stream、iii-observability の各 worker が提供します。Postgres、Redis、Express、pm2、Prometheus をインストールしなかったのは、iii がそれらを置き換えるからです。
つまり、もう 1 つのコマンドで agentmemory にまったく新しい機能を拡張できます。
### agentmemory をさらに worker で拡張する
agentmemory が必要とする組み込み worker は、既に `iii-config.yaml` に入っていて、起動時に一緒に立ち上がります: `iii-state`(KV)、`iii-queue`(イベントサブスクライバー向けの永続リトライ)、`iii-pubsub`、`iii-cron`、`iii-stream`、そして `iii-observability`(すべての function に OTEL トレース、メトリクス、ログ)です。[iii worker レジストリ](https://workers.iii.dev)にあるその他の worker は、同じエンジンにそのまま差し込めます: `iii-config.yaml` を `~/.agentmemory/iii-config.yaml` にコピーし(CLI は同梱のファイルよりこのファイルを優先しつつ、ポートとデータパスはそのままレンダリングします)、エントリを追加し、`~/.agentmemory/bin/iii update worker` で worker ランタイムを一度インストールし、agentmemory を再起動してください。
```yaml
workers:
# ...the bundled entries...
- name: database # SQL-backed state adapter when you outgrow the KV defaults
- name: iii-sandbox # run code that came out of memory_recall inside a throwaway VM
- name: mcp # extra MCP servers next to agentmemory's, same engine
```
| Worker | agentmemory の上に得られるもの |
|---|---|
| [`database`](https://workers.iii.dev/workers/database) | インメモリの KV デフォルトでは不足するときの SQL バックエンドのステートアダプタ |
| [`iii-sandbox`](https://workers.iii.dev/workers/iii-sandbox) | `memory_recall` から出てきたコードは、あなたのシェルではなく使い捨ての VM 内で実行されます |
| [`mcp`](https://workers.iii.dev/workers/mcp) | agentmemory の MCP サーバーの隣に追加の MCP サーバーを立て、同じエンジンを共有します |
エンジン 0.22.x では、上記の組み込み worker については `iii-` 接頭辞付きの名前をそのまま使ってください。接頭辞のない `http`、`state`、`queue`、`pubsub`、`cron` は、agentmemory が 0.23 への移行で切り替える先のスタンドアロンなレジストリ worker です。
完全なレジストリ: [workers.iii.dev](https://workers.iii.dev)。そこにあるすべての worker は agentmemory が使っているのと同じプリミティブで組み立てられています。そして、あなたが既に手元にある agentmemory も、そのうちの 1 つです。
### エンジン設定とバインドアドレス
`agentmemory start` は、最初に存在するファイルからエンジン設定を読み込みます: `AGENTMEMORY_III_CONFIG`、カレントディレクトリの `./iii-config.yaml`、`~/.agentmemory/iii-config.yaml`、そして同梱の `iii-config.yaml` の順です。起動のたびに、そのファイル(データパス、ポート、ステートバックエンド)を `~/.agentmemory/data/iii-config.runtime.yaml` にレンダリングし、そのレンダリング済みのコピーでエンジンを起動します。編集すべきはレンダリング済みのファイルではなく、ソースファイルです。ソースファイルの `host:` の値は、書かれたとおりに保たれます。
同梱の `iii-config.yaml` は意図的に `127.0.0.1` にバインドし、そのデフォルトはコンテナ内でも同様に適用されます。コンテナ内で起動した CLI はコンテナのループバックをリッスンするため、公開されたポートは何にも到達しません。コンテナ化された CLI を公開ポート経由で提供するには、`AGENTMEMORY_III_CONFIG` を `0.0.0.0` にバインドする設定に設定してください。パッケージ化された `iii-config.docker.yaml` はまさにそれで、`iii-http`、`iii-stream`、エンジンのポートを `0.0.0.0` にバインドし、ステートを `/data` 配下に保存するので、そこに書き込み可能なボリュームをマウントしてください。`AGENTMEMORY_SECRET` は設定したままにし、必要なポートだけを `127.0.0.1` 上か、信頼するプロキシの背後で公開してください。
このリポジトリの `docker-compose.yml` は CLI の設定探索を経由しません: `iii-config.docker.yaml` を `/app/config.yaml` にマウントし、`iii-engine` コンテナは `--config /app/config.yaml` で起動します。ワンクリックの[デプロイテンプレート](../deploy/)は、それぞれのエントリポイントで独自の `0.0.0.0` 設定を書き込みます。
### ストレージバックエンド: file(デフォルト)vs redis
`iii-state` と `iii-stream` は、デフォルトで iii-engine 同梱のファイルベースの KV ストアを使います: スコープごとに 1 つの JSON ファイルで、エンジンプロセスのメモリ上に保持され、タイマーでディスクに書き戻されます。これは、単一ユーザーのローカルインストールには正しいデフォルトです。複数の書き込み側が同時にアクセスする共有デーモンでは、代わりに Redis から本物のキー単位の書き込みが得られますが、操作あたりネットワークのラウンドトリップが発生するコストがあります(すべての `state::*` 呼び出しは依然として 1 つの Redis 接続上で直列化されるため、これはファイルストアのロックをソケットに置き換えるだけで、並列性を得るものではありません)。
両方の worker を iii-engine 組み込みの `redis` アダプタに切り替えるには、`AGENTMEMORY_STATE_BACKEND=redis`(と `AGENTMEMORY_REDIS_URL`)を設定してください。このアダプタは、書き込みごとにスコープ全体を書き直すのではなく、各キーを Redis のハッシュフィールド(`HSET`)として保存します:
```env
# ~/.agentmemory/.env
AGENTMEMORY_STATE_BACKEND=redis
AGENTMEMORY_REDIS_URL=redis://localhost:6379
```
`AGENTMEMORY_STATE_BACKEND` のデフォルトは `file` です。未設定のままなら今日の挙動は変わりません。認識できない値(`file` でも `redis` でもない値)は、静かにフォールバックするのではなく起動エラーになります。`/agentmemory/status` とビューワーの Health ページ(State store の行)は、どちらのバックエンドが有効か、そして応答しているかどうかを報告しますが、URL は決して表示しません。
**プレーンな `redis://` のみです。** ピン留めされたエンジン(0.22.1)は TLS サポートなしで Redis クライアントをビルドするため、`rediss://` の URL(Upstash、Redis Cloud、転送時暗号化付き ElastiCache など、ほとんどのマネージド Redis サービスのデフォルトは TLS 専用です)は接続に失敗します。接続は暗号化されないため、Redis のパスワードと保存されているすべてのメモリが平文で回線上を流れます。ローカルの Redis か、信頼できるプライベートネットワーク上の Redis を指してください。それ以外の Redis の場合は、agentmemory のホスト上で暗号化されたトンネル(stunnel、SSH、または VPN)を実行し、プレーンな `redis://` のホップをそのホスト内に留め、トンネルの上流側の接続は暗号化・認証されるようにしてください。Redis のパスワードにシングルクォートが含まれる場合は、パーセントエンコードしてください(`%27`)。エンジンは URL を YAML 設定に展開してからパースします。
**`--instance` ごとに Redis サーバーを 1 つ。** エンジンの Redis キー接頭辞(`state:`、`stream::`)は固定なので、同じデータベースを指す 2 つの agentmemory インスタンス(`--instance 1`、`--instance 2`、...)は互いのデータを上書きします。別のデータベース番号(`redis://localhost:6379/1`)を使えば保存データは分離されますが、エンジンはライブのビューワーイベントを 1 つの Redis pub/sub チャネル(`stream::events`)経由で中継し、Redis の pub/sub はデータベース番号を無視するため、各インスタンスのビューワーには依然として他方のライブイベントが表示されてしまいます。複数インスタンスを運用するときは、インスタンスごとに別々の Redis サーバー(またはポート)を用意してください。
**変わらないこと、変わること。** agentmemory のすべての機能が Redis 上でも動作します: セッション、観測、メモリ(remember、supersede、evolve、forget)、検索とそのインデックスバケット、レッスン、グラフ、監査ログとその月次スコープ、エクスポートとインポート、ガバナンス削除、統合ステータス、ビューワーのスナップショットとそのライブストリーム、ヘルスモニタです。エンジンは各スコープを 1 つの Redis ハッシュ(`HSET`/`HGET`/`HGETALL`)として保存し、ファイルストアと同じステートトリガーを発火します。3 つのエンジンの差異は agentmemory の内部で処理されています:
- Redis はスコープのレコードを一定の順序では返しません。agentmemory はそれらを作成の古い順(レコード id 内の作成時刻、次にそのタイムスタンプ)に並べ替えるため、一覧・ページ送り・エクスポートのチャンクはファイルストアと同じ順序で返ってきます。
- エンジンは Redis 上の部分更新を、空の配列を空のオブジェクトに変えてしまう Lua スクリプトで適用します。agentmemory は Redis 上ではこれらの更新を自分自身で適用します(読み取り、変更、キー単位のロック下での書き込み)。そのため `tags: []` のようなフィールドは配列のままになります。
- レガシーな監査ログのチェックは、ディスク上のファイルストアのファイルを探す代わりに、Redis から古いスコープを読み取ります。
1 つだけ、あなたの対応が必要な差異があります: **Redis が再起動すると、agentmemory が再起動するまでエンジンはビューワーへのライブイベントの中継を停止します。** データ自体は通常どおり保存・読み取りされます。ヘルスモニタは 30 秒ごとに Redis 経由でテストイベントを送信し、それが返ってこないときは、`/agentmemory/status` とビューワーの Health ページが「Live updates are not reaching the viewer」と、その修正方法(agentmemory を再起動する)を表示します。Redis がダウンしている場合、ステータスレポートは「The state store is not answering」と、その確認方法(`redis-cli -u "$AGENTMEMORY_REDIS_URL" ping`)を表示します。非常に大きなスコープを一覧表示すると、ハッシュ全体を 1 回の `HGETALL` で読み込みます。これは、ファイルストアがそれをメモリ上に保持するのと同じコストです。
**推奨の Redis 設定。** デフォルトの `save 3600 1 300 100 60 10000` というスナップショット方針は、クラッシュ時にファイルストアの 5 秒のフラッシュ間隔より多くの、数分間分の書き込みを失う可能性があります。失っても構わないもの以外は `appendonly yes` を設定してください。`maxmemory-policy noeviction` を設定してください。`allkeys-lru` などを使うと、Redis がメモリ上限に達した時点で静かにメモリを失うことになります。
ネイティブ(非 Docker)起動、そしてワンクリックの[デプロイテンプレート](../deploy/)(それぞれが同梱の `iii-config.yaml` を上書きしてネイティブに起動します)はいずれも、`AGENTMEMORY_STATE_BACKEND`/`AGENTMEMORY_REDIS_URL` を読み取り、起動する `iii-config` にそれらをレンダリングします。URL 自体はそのレンダリング済みファイルには書き込まれず、エンジンプロセスが起動時に自身の環境から展開する `${AGENTMEMORY_REDIS_URL}` という参照だけが書き込まれます。このリポジトリ自身の Docker Compose の経路(`AGENTMEMORY_USE_DOCKER=1`、またはその方法で起動済みのエンジンを再利用する場合)だけが `iii-config.docker.yaml` を読み取り専用でマウントし、レンダリングを行いません。`agentmemory start` は、その組み合わせを検出すると警告します。そのファイルは、[iii-state](https://workers.iii.dev/workers/iii-state) と [iii-stream](https://workers.iii.dev/workers/iii-stream) の worker ドキュメントに示されている同じ `name: redis` / `config: redis_url: ...` の形に従って手動で切り替え、`redis_url` をコンテナから到達可能な Redis に向けてください。`docker-compose.yml` は `AGENTMEMORY_REDIS_URL` をエンジンコンテナに渡すため、そこでは `redis_url: '${AGENTMEMORY_REDIS_URL}'` が動作し、URL をマウントされたファイルの外に保てます。
レンダリングされた設定は URL を `~/.agentmemory/data/iii-config.runtime.yaml` の外に保ちますが、エンジン自身の configuration worker は、起動すると*展開済みの*値を `~/.agentmemory/config/iii-state.yaml` と `iii-stream.yaml` に永続化します(iii-engine の `${VAR}` 展開はその worker がシードを保存する前に行われ、worker は参照ではなく解決済みの値を保存します)。そのディレクトリは認証情報を保持しているものとして扱ってください: 共有ホストでは `chmod 700 ~/.agentmemory` を実行し、データベースの管理者権限よりも、agentmemory が必要とする範囲に絞った Redis の ACL ユーザーを使うことを推奨します。
**移行は自動ではありません。** `AGENTMEMORY_STATE_BACKEND` を切り替えると、どちら側も空のストアから始まります。既存のデータが file から Redis へ、あるいはその逆へ自動でコピーされることはありません。移行元のバックエンドからエクスポートし、移行先のバックエンドへインポートしてください。これは bash と zsh のどちらでも同じように動作します(`bash -u` を含む)。`AUTH=(${AGENTMEMORY_SECRET:+-H "Authorization: Bearer $AGENTMEMORY_SECRET"})` のような配列はそうではありません: `AGENTMEMORY_SECRET` が設定されているとき、zsh はヘッダーを 1 つの不正な語として保持しますが bash はそれを 2 つに分割するため、どちらのリクエストも常に 401 になります:
```bash
# 0. Use the generated secret when none is exported:
AGENTMEMORY_SECRET="${AGENTMEMORY_SECRET:-$(cat ~/.agentmemory/secret 2>/dev/null)}"
# 1. On the old backend, while agentmemory is still running on it:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" http://localhost:3111/agentmemory/export > backup.json
else
curl -fsS http://localhost:3111/agentmemory/export > backup.json
fi
# 2. Confirm backup.json is a usable export before switching backends:
jq -e '.version and .exportedAt' backup.json > /dev/null || {
echo "backup.json is not a valid export; do not switch backends" >&2
exit 1
}
# 3. Switch AGENTMEMORY_STATE_BACKEND (and AGENTMEMORY_REDIS_URL if needed),
# restart agentmemory against the new backend, then:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
else
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
fi
```
`/agentmemory/export` は、大きなコーパスを複数の呼び出しに分割するための `?maxSessions=` と `?offset=` も受け付けます。import の `strategy` は `merge`(デフォルトで安全)、`replace`、または `skip` です。
### iii が置き換えるもの
| 従来のスタック | agentmemory が使うもの |
|---|---|
| Express.js / Fastify | iii HTTP Triggers |
| SQLite / Postgres + pgvector | iii KV State + インメモリベクトルインデックス |
| SSE / Socket.io | iii Streams(WebSocket) |
| pm2 / systemd | iii engine worker 監視 |
| Prometheus / Grafana | iii OTEL + ヘルスモニタ |
| カスタムプラグインシステム | `iii worker add ` |
**219 ソースファイル · ~52,000 LOC · 2,500+ テスト · 311 functions · 60 KV スコープ** — すべて 3 つのプリミティブの上に。`agentmemory plugin install` はありません。プラグインシステムは iii そのものです。
---

### LLM プロバイダー
agentmemory は環境からプロバイダーを自動検出します。プロバイダーを設定すると LLM ベースの操作が使えるようになりますが、プロバイダーの設定だけでは LLM による観測の圧縮は有効になりません。その経路には、プロバイダーと `AGENTMEMORY_AUTO_COMPRESS=true` の両方が必要です。
| プロバイダー | 設定 | 備考 |
|----------|--------|-------|
| **No-op(デフォルト)** | 設定不要 | LLM ベースの compress/summarize は無効。合成圧縮と BM25 リコールは引き続き動作します。以前 Claude 購読フォールバックに依存していた場合は、下記の `AGENTMEMORY_ALLOW_AGENT_SDK` を参照してください。 |
| Anthropic API | `ANTHROPIC_API_KEY` | トークン単位課金 |
| MiniMax | `MINIMAX_API_KEY` | Anthropic 互換 |
| Gemini | `GEMINI_API_KEY` | 埋め込みも有効化 |
| OpenRouter | `OPENROUTER_API_KEY` | 任意のモデル |
| OpenAI API | `OPENAI_API_KEY` | デフォルト `gpt-5.6-luna`、`OPENAI_MODEL` で上書き |
| **ローカル(Ollama / LM Studio / vLLM / llama.cpp)** | `OPENAI_API_KEY=local` + `OPENAI_BASE_URL=http://localhost:11434/v1`(Ollama)または `http://localhost:1234/v1`(LM Studio)+ `OPENAI_MODEL=` | OpenAI API 互換なら何でも。コストゼロ、あなたのハードウェアで動作します。下記の[ローカルモデル](#local-models-ollama--lm-studio--vllm)を参照してください。 |
| Claude 購読フォールバック | `AGENTMEMORY_ALLOW_AGENT_SDK=true` | オプトインのみ。`@anthropic-ai/claude-agent-sdk` のセッションを生成します。過去に無限の Stop-hook 再帰を引き起こしたため、もはやデフォルトではありません。 |
### ローカルモデル(Ollama / LM Studio / vLLM)
agentmemory は OpenAI API 互換のあらゆるサーバーと通信できるため、`/v1/chat/completions` を公開するものならコード変更なしで動きます。有料キーもクラウドもレート制限もなし。すべてあなたのハードウェア上で動作します。
**Ollama**(デフォルトポート `11434`):
```bash
ollama pull qwen3:8b # or qwen3:4b, gpt-oss:20b, qwen3-coder:30b, etc.
ollama serve
```
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=ollama # any non-empty string; Ollama ignores it
OPENAI_BASE_URL=http://localhost:11434/v1
OPENAI_MODEL=qwen3:8b
```
**LM Studio**(デフォルトポート `1234`):
LM Studio を開く → Local Server タブ → Start Server。ピッカーから任意のチャットモデル(Qwen 3、gpt-oss、DeepSeek R1 など)を選択します。
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=lmstudio # any non-empty string; LM Studio ignores it
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_MODEL=qwen3-8b # match the model name from LM Studio
```
**vLLM / llama.cpp / Text Generation Inference**: 同じ形です。`OPENAI_BASE_URL` をサーバーが公開する URL に向け、`OPENAI_MODEL` をサーバーが受け付ける名前に設定してください。
**メモリ作業向けのモデル選び**: 圧縮と要約は短いタスク(入力 <2K トークン、出力 <500 トークン)なので、7B クラスの instruct モデルで十分です。推奨:
| モデル | サイズ | 理由 |
|-------|------|-----|
| `qwen3:8b` | ~5.2 GB | 16 GB マシンでのバランス型デフォルト。抽出とツール形式のテキストに強い |
| `qwen3:4b` | ~2.6 GB | 最小の現実的な選択肢。圧縮には十分、グラフ抽出はやや弱い |
| `qwen3-coder:30b` | ~19 GB | コード中心のセッションに最良のローカル候補(30B MoE、アクティブ 3.3B)。24〜32 GB ハードウェア向け |
| `gpt-oss:20b` | ~14 GB | 16 GB RAM に収まる強力な汎用モデル |
| `deepseek-r1:8b` | ~5.2 GB | 推論蒸留モデル。遅いが抽出はよりクリーン |
Qwen 3 モデルはデフォルトで思考(thinking)を行い、出力を出す前に推論だけでトークン予算を使い切ることがあります。`AGENTMEMORY_LLM_NOTHINK=1` を設定すると、グラフ抽出プロンプトに `/no_think` が付加されます。抽出結果が空で返る場合は `MAX_TOKENS` を上げてください(16384 で動作します)。
推論クラスのモデル(`` ブロックを持つ `o1` 系)は、ローカルサーバーが表面化しない可能性のある `reasoning` フィールドとともに、空の `content` を返すことがあります。抽出が空で返る場合は、まず非推論モデルに切り替えてください。`OPENAI_REASONING_EFFORT=none` の環境変数でも、OpenAI の推論スキーマを踏襲する Ollama Cloud の thinking モデルの思考を無効化できます。
ローカル埋め込みはオプションの依存としては同梱されていますが、デフォルトでは有効になっていません。`Xenova/all-MiniLM-L6-v2`(384 次元)にオプトインするには `EMBEDDING_PROVIDER=local` を設定してください。最初の埋め込みリクエストでモデルがダウンロードされ、その後の推論はオンデバイスで行われます。この設定もリモートの埋め込みキーもない場合、ベクトルは無効のままで、`mem::search` は BM25 を使い、`smart-search` はそれでも既存のグラフマッチを追加できます。
### コストを意識したモデル選択
バックグラウンド圧縮が、プロバイダーと `AGENTMEMORY_AUTO_COMPRESS=true` の両方で有効になっている場合、それは観測のたびに走るため、モデル選択は月額支出に大きく影響します。記録されたワークロード: 635 リクエスト / 888K トークン / 35 時間のアクティブ使用を、2026-05-23 時点の OpenRouter 価格で 3 モデルに対して実行しました。
| 階層 | モデル | 入力 / 1M | 出力 / 1M | 記録された 35 時間分のコスト | 備考 |
|------|-------|------------|-------------|---------------------------|-------|
| 推奨 | `deepseek/deepseek-v4-flash-0731` | $0.07 | $0.14 | ~$0.07(推定) | 最新の DeepSeek。圧縮ワークロード向けの最安の推奨候補。 |
| 推奨 | `deepseek/deepseek-v4-pro` | $0.435 | $0.87 | ~$0.46 | 圧縮 + 要約品質が手堅く、Sonnet の約 10 分の 1 のコスト。 |
| 推奨 | `qwen/qwen3-coder` | $0.45 | $1.80 | ~$0.55 | セッションがコード中心ならコード推論が強い。 |
| プレミアム | `anthropic/claude-sonnet-5` | $3.00 | $15.00 | ~$5.02(推定) | 実測した Sonnet 4.6 ランと同じ定価。2026-08-31 までは $2/$10 の導入価格。 |
| プレミアム | `openai/gpt-5.6-sol` | $5.00 | $30.00 | ~$9(推定) | フラッグシップ階層。常時稼働のバックグラウンド作業には高価。 |
| 回避 | `anthropic/claude-opus-5` | $5.00 | $25.00 | ~$8.40(推定) | フラッグシップクラスのモデル。圧縮には過剰支出。 |
実測の行は記録された実行から得たもので、(推定)の行は同じトークン構成を各モデルの定価でスケールしたものです。
agentmemory は、`OPENROUTER_MODEL` がプレミアム階層のパターンに一致するときランタイム警告を表示します。納得して選んだあとは `AGENTMEMORY_SUPPRESS_COST_WARNING=1` で消音できます。
メモリ作業における品質対コストのトレードオフ: 圧縮は品質のハードルが比較的緩い要約タスクです(要約を読み返すのはエージェントであってユーザーではありません)。DeepSeek V4 Flash / V4 Pro / Qwen3-Coder はこのタスクで Sonnet と誤差範囲に収まる一方、コストは 10〜70 分の 1 です。プレミアム階層のモデルは、あなたが直接読むクエリのために取っておきましょう。
出典: [OpenRouter の Claude Sonnet 5 価格](https://openrouter.ai/anthropic/claude-sonnet-5)、[DeepSeek V4 Flash](https://openrouter.ai/deepseek/deepseek-v4-flash-0731)、[DeepSeek の価格に関する注記](https://api-docs.deepseek.com/quick_start/pricing/)。
### マルチエージェントメモリ(`AGENT_ID` + `AGENTMEMORY_AGENT_SCOPE`)
複数のロール(architect / developer / reviewer / researcher / support-agent)が 1 つの agentmemory サーバーを共有するマルチエージェント構成では、`AGENT_ID` がすべての書き込みに、それを行ったロールのタグを付けます。`AGENTMEMORY_AGENT_SCOPE` は、リコールがそのタグでフィルタするかどうかを制御します。
```env
TEAM_ID=company
USER_ID=engineering-team
AGENT_ID=architect
AGENTMEMORY_AGENT_SCOPE=isolated # optional; default "shared"
```
2 つのモード:
| モード | 書き込みにタグ | リコールでフィルタ | 使いどころ |
|------|------------|---------------|-------------|
| `shared`(デフォルト) | はい | いいえ | 監査証跡付きのクロスエージェントコンテキスト。Architect は developer のメモを見られますが、各行に発言者が記録されます。 |
| `isolated` | はい | はい | 厳格分離。Architect は developer の観測 / メモリ / セッションを決して見られません。 |
`AGENT_ID` が設定されたときにタグ付けされるもの: `Session.agentId`、`RawObservation.agentId`、`CompressedObservation.agentId`、`Memory.agentId`。ロールは `api::session::start` → `mem::observe` → `mem::compress` → KV を流れます。
isolated モードでフィルタされるもの: `mem::smart-search`、`/agentmemory/memories`、`/agentmemory/observations`、`/agentmemory/sessions`。各エンドポイントはリクエスト単位でオーバーライドする `?agentId=` を受け付け、`?agentId=*` で環境スコープから完全にオプトアウトできます。`/memories` はさらに `?includeOrphans=true` を受け付け、`agentId` が undefined の AGENT_ID 導入前のメモリを浮上させます。
SDK / REST 層での呼び出し単位オーバーライド: すべての変更系エンドポイント(`/session/start`、`/remember`)はリクエストボディに `agentId` フィールドを受け付け、それが環境変数より優先されます。1 つのサーバープロセス経由で多数のロールをルーティングするランタイムに便利です。MCP の `memory_save` ツールも同じ `agentId` フィールドを公開し、スタンドアロンの stdio サーバーは `agentId` と `project` の両方を転送します。保存されたメモリは `agentId` を検索インデックスまで持ち込むため、エージェントスコープの検索は観測だけでなくメモリもカバーします。
`AGENT_ID` が未設定の場合、メモリはスコープなしのままです(従来の挙動、タグなし・フィルタなし)。
### ポート
agentmemory + iii-engine はデフォルトで 4 つのポートをバインドします。再起動が `port in use` で失敗する場合、この表でどのプロセスを探せばよいか分かります。
| ポート | プロセス | 用途 | 環境変数での上書き |
|------|---------|---------|--------------|
| `3111` | agentmemory | REST API + MCP HTTP + `/agentmemory/health` + `/agentmemory/livez` | `III_REST_PORT` |
| `3112` | iii-engine | 内部ストリーム worker(agentmemory + ビューワーが消費) | `III_STREAM_PORT`(推奨)または legacy の `III_STREAMS_PORT` |
| `3113` | agentmemory | リアルタイムビューワー(`http://localhost:3113`) | `III_VIEWER_PORT`、または報告される URL 用の `AGENTMEMORY_VIEWER_URL` |
| `49134` | iii-engine | WebSocket。worker はここに登録し、OTel テレメトリもここを流れます | `III_ENGINE_PORT` または `III_ENGINE_URL` |
`--port ` は REST の基点を変更し、上の対応する明示的なポートや URL が未設定の場合に限り、ストリームを `N+1`、ビューワーを `N+2`、エンジンの WebSocket を `N+46023` として導出します。これは独立したライフサイクル名前空間を作るものではありません。2 つめのデーモンには `--instance 1` を使ってください。基点 3211 を使い、デフォルトは `3211/3212/3213/49234` になり、別の `instance-1` のデータとライフサイクルディレクトリを受け取ります。インスタンス 1 から 50 まで同じパターンに従います。
ピン留めされたエンジンは `--no-update-check`(起動時に GitHub へのアップデートやセキュリティ勧告の確認を行わない)で起動し、iii の匿名使用状況テレメトリもオフの状態で起動します: agentmemory は、自分で変数を export していない限り、自身が起動するエンジンに対して `III_TELEMETRY_ENABLED=false` を設定します。同梱の compose ファイルも同様です。
クラッシュ後にポートが解放されないときの古いプロセス整理:
```bash
# macOS / Linux — find whatever is on each port and kill it
lsof -i :3111,3112,3113,49134
pkill -f agentmemory || true
pkill -f 'iii ' || true
# Windows
netstat -ano | findstr ":3111 :3112 :3113 :49134"
taskkill /F /PID
```
`agentmemory stop` は、正常なネイティブ終了時に worker と engine の pidfile をきれいに回収します。Docker モードでは、ネイティブ worker をフラッシュしてから、検証済みのそのエンジンコンテナだけを停止し、無損失の再起動のためにコンテナとその `/data` マウントの両方を保持します。次回起動時には、同じコンテナを検証して再利用します。Docker バックエンドでのアンインストールには `agentmemory remove --keep-data` が必要です: これは、検証済みのコンテナ、そのデータマウント、それらを復旧するために必要なライフサイクルレコードを保持したまま、共有の agentmemory 管理ファイルだけを削除します。破壊的な Docker データ削除は、バックアップ後に操作者の判断で行うよう意図的に残されています。また CLI は、`--force` を渡さない限り、Docker や VM のポート保持プロセス(Docker バックエンド、vpnkit、colima)をネイティブエンジンとして採用・シグナルすることを拒否します。上の手動クリーンアップは、どちらの pidfile も残っていないクラッシュ後の状態だけを対象としています。
### 設定ファイル
agentmemory のランタイム設定は、各シェルで変数を export するのではなく `~/.agentmemory/.env` に置いてください。ビューワーが `export ANTHROPIC_API_KEY=...` のようなセットアップヒントを表示したら、これをこのファイルに `ANTHROPIC_API_KEY=...` として(`export` プレフィックスなしで)コピーしてから agentmemory を再起動してください。
プロセスの環境変数も引き続き有効で、ファイル内の値より優先されます。
Windows では、同じファイルが `%USERPROFILE%\.agentmemory\.env` にあります:
```powershell
New-Item -ItemType Directory -Force $HOME\.agentmemory
notepad $HOME\.agentmemory\.env
```
API キーの代わりに Claude Code Pro/Max の購読でテストするには、明示的にオプトインしてください:
```env
AGENTMEMORY_ALLOW_AGENT_SDK=true
AGENTMEMORY_AUTO_COMPRESS=true
```
LLM による観測の圧縮には両方の行が必要です: LLM プロバイダーへのアクセス(この明示的な購読フォールバックを含む)と `AGENTMEMORY_AUTO_COMPRESS=true` です。プロバイダーだけでは、デフォルトの合成圧縮の経路がそのまま残ります。
統合(グラフノード、レッスン、クリスタル)は、LLM プロバイダーが設定されていれば常にデフォルトでオンです。LLM なしで運用したい場合は、`CONSOLIDATION_ENABLED=false` で明示的にオプトアウトしてください。グラフ抽出は別のフラグです:
```env
GRAPH_EXTRACTION_ENABLED=true
# CONSOLIDATION_ENABLED=false # opt out of auto-consolidation
```
### 環境変数
`~/.agentmemory/.env` を作成してください:
```env
# LLM provider (pick one — default is the no-op provider: no LLM calls)
# ANTHROPIC_API_KEY=sk-ant-...
# ANTHROPIC_BASE_URL=... # Optional: Anthropic-compatible proxy / Azure
# GEMINI_API_KEY=...
# OPENROUTER_API_KEY=...
# MINIMAX_API_KEY=...
# OPENAI_API_KEY=*** # NOTE: this same key auto-activates BOTH the
# # OpenAI LLM provider (here) AND the OpenAI
# # embedding provider (further below). Set
# # OPENAI_API_KEY_FOR_LLM=false to scope it
# # to embeddings only.
# OPENAI_BASE_URL=https://api.openai.com # Optional: override for Azure / vLLM / LM Studio / proxies
# # Azure: https://.openai.azure.com/openai/deployments/
# # Auto-detected from `.openai.azure.com` hostname; uses
# # api-key header + api-version query param.
# OPENAI_API_VERSION=2024-08-01-preview # Optional: Azure api-version query param
# OPENAI_MODEL=gpt-5.6-luna # Optional: default model
# OPENAI_TIMEOUT_MS=60000 # Optional: OpenAI-scoped alias for the outbound fetch
# # timeout. Takes precedence over AGENTMEMORY_LLM_TIMEOUT_MS
# # for back-compat with v0.9.17. New configs should
# # prefer the global AGENTMEMORY_LLM_TIMEOUT_MS below.
# OPENAI_REASONING_EFFORT=none # Optional: "low" | "medium" | "high" | "none"
# # Honored only by OpenAI's reasoning models (o1, o3,
# # gpt-*-reasoning) and providers that mirror that
# # schema (Ollama Cloud thinking models). Standard
# # chat models reject this field with 400. Set to
# # "none" for thinking models that return reasoning
# # but no content.
# OPENAI_API_KEY_FOR_LLM=false # Optional: set to false to skip OpenAI auto-detection
# # for LLM (useful if you only want OpenAI for embeddings)
# Opt-in Claude-subscription fallback (spawns @anthropic-ai/claude-agent-sdk);
# leave OFF unless you understand the Stop-hook recursion risk:
# AGENTMEMORY_ALLOW_AGENT_SDK=true
# Embedding provider (BM25-only when unset; local is an explicit opt-in)
# EMBEDDING_PROVIDER=local
# VOYAGE_API_KEY=...
# OPENAI_API_KEY=sk-...
# OPENAI_BASE_URL=https://api.openai.com # Override for Azure / vLLM / LM Studio / proxies
# OPENAI_EMBEDDING_MODEL=text-embedding-3-small
# OPENAI_EMBEDDING_DIMENSIONS=1536 # Required when the model is not in the known-models table
# OPENAI_EMBEDDING_BASE_URL=https://... # Embeddings only; falls back to OPENAI_BASE_URL
# OPENAI_EMBEDDING_API_KEY=sk-... # Embeddings only; wins over OPENAI_API_KEY when set
# Outbound LLM / embedding timeout
# AGENTMEMORY_LLM_TIMEOUT_MS=60000 # Default: 60 000 ms (60 s). Applies to every
# raw-fetch provider (Gemini, OpenRouter, MiniMax,
# OpenAI LLM, OpenAI/Cohere/Voyage/OpenRouter
# embedding). For the OpenAI LLM path, the
# OpenAI-scoped OPENAI_TIMEOUT_MS alias (above)
# takes precedence when set, for back-compat
# with v0.9.17.
# Increase for slow networks or large batch calls;
# decrease to fail-fast on rate-limit holds.
# Search tuning
# BM25_WEIGHT=0.4
# VECTOR_WEIGHT=0.6
# TOKEN_BUDGET=2000
# Auth (generated into ~/.agentmemory/secret on first start when unset)
# AGENTMEMORY_SECRET=your-secret
# VIEWER_ALLOWED_ORIGINS=https://memory.example.com
# AGENTMEMORY_IMPORT_ROOT=~/projects
# Ports (defaults: 3111 API, 3113 viewer)
# III_REST_PORT=3111
# Engine usage telemetry (iii). Off unless you set it; true opts in.
# III_TELEMETRY_ENABLED=false
# Features
# AGENTMEMORY_AUTO_COMPRESS=false # OFF by default. Requires an LLM
# provider as well. When both are on,
# every PostToolUse hook calls your
# LLM provider to compress the
# observation — expect significant
# token spend on active sessions.
# AGENTMEMORY_SLOTS=false # OFF by default. Editable pinned
# memory slots — persona,
# user_preferences, tool_guidelines,
# project_context, guidance,
# pending_items, session_patterns,
# self_notes. Size-limited; agent
# edits via memory_slot_* tools.
# Pinned slots addressable for
# SessionStart injection.
# AGENTMEMORY_REFLECT=false # OFF by default. Requires SLOTS=on.
# Stop hook fires mem::slot-reflect:
# scans recent observations, auto-
# appends TODOs to pending_items,
# counts patterns in
# session_patterns, records touched
# files in project_context. Fire-
# and-forget; does not block.
# AGENTMEMORY_INJECT_CONTEXT=false # OFF by default. When on:
# - SessionStart may inject ~1-2K
# chars of project context into
# the first turn of each session
# (this is what actually reaches
# the model — Claude Code treats
# SessionStart stdout as context)
# - PreToolUse fires /agentmemory/enrich
# on every file-touching tool call
# (resource cleanup, not a token
# fix — PreToolUse stdout is debug
# log only per Claude Code docs)
# Observations are still captured via
# PostToolUse regardless of this flag.
# GRAPH_EXTRACTION_ENABLED=false
# AGENTMEMORY_LLM_NOTHINK=1 # Local reasoning models only: ask the
# model to skip its hidden thinking pass
# during graph extraction. Faster runs;
# relation quality can drop slightly.
# CONSOLIDATION_ENABLED=false # on by default when an LLM provider is configured
# LESSON_DECAY_ENABLED=true
# OBSIDIAN_AUTO_EXPORT=false
# AGENTMEMORY_EXPORT_ROOT=~/.agentmemory
# CLAUDE_MEMORY_BRIDGE=false
# SNAPSHOT_ENABLED=false
# Storage and durability
# AGENTMEMORY_STATE_BACKEND=file # file (default) or redis; see "Storage backend" below
# AGENTMEMORY_REDIS_URL=redis://localhost:6379 # Required with redis, plain redis:// only
# AGENTMEMORY_STATE_SAVE_INTERVAL_MS=2000 # How often the engine writes file state to disk.
# A hard kill loses at most this window.
# AGENTMEMORY_INDEX_SAVE_INTERVAL_MS=600000 # Minimum time between search index saves;
# shutdown and deletes still save at once.
# AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=true # One-time background trim of oversized graph
# provenance; false skips it
# Sessions
# AGENTMEMORY_SESSION_SWEEP_ENABLED=true # Hourly sweep marks sessions left active past
# the threshold as abandoned. Deletes nothing;
# new activity makes the session active again.
# AGENTMEMORY_SESSION_SWEEP_STALE_HOURS=24
# Capture filters (hooks)
# AGENTMEMORY_CAPTURE_ALLOW= # Comma or space list of tool names or globs;
# when set, only these tools are captured
# AGENTMEMORY_CAPTURE_DENY= # Extra names or globs to skip, added to the
# defaults: memory_*, toolsearch,
# listmcpresources, fetchmcpresource
# AGENTMEMORY_CAPTURE_OUTPUT_MAX=8000 # Max characters of tool output per observation
# AGENTMEMORY_PRE_COMPACT_BUDGET=1500 # Token budget for PreCompact context; 0 disables
# Audit log
# AGENTMEMORY_AUDIT_RETENTION_MONTHS=0 # Drop month scopes older than N months; 0 keeps all
# AGENTMEMORY_AUDIT_INDEX_PERSIST=false # 1 or true records index migration and cleanup
# rows (debugging only)
# Team
# TEAM_ID=
# USER_ID=
# TEAM_MODE=private
# Tool visibility: "all" (54 tools, default) or "core" (8 tools, lean)
# AGENTMEMORY_TOOLS=core
```
---

ポート `3111` 上の 138 エンドポイント。REST API はデフォルトで `127.0.0.1` にバインドします。保護されたエンドポイントは `Authorization: Bearer ` を要求し、mesh sync エンドポイントは両ピアで明示的に設定された `AGENTMEMORY_SECRET` を要求します。
**認証はデフォルトでオンです。** `AGENTMEMORY_SECRET` が(シェルにも `~/.agentmemory/.env` にも)設定されていない場合、サーバーは初回起動時にランダムなシークレットを生成し、モード `0600` で `~/.agentmemory/secret` に保存します。同梱のすべてのクライアント — CLI、ビューワー、`plugin/scripts` 配下の hooks、MCP サーバーと `@agentmemory/mcp` の shim、`agentmemory connect` が書き込む設定、同梱の OpenCode、Pi、OpenClaw、Hermes、ファイルシステムウォッチャーの各統合 — は、ローカルサーバーと話すときにそこから読み取ります。保存されたシークレットは、ループバックの URL(`localhost`、`127.0.0.0/8`、`::1`)にのみ送信されます。明示的な `AGENTMEMORY_SECRET` は常に優先され、リモートクライアントではそれでも設定が必要です。Docker と `deploy/` のエントリポイントは、既に独自のシークレットを生成・export しています。手動で API を呼ぶには:
```bash
curl -H "Authorization: Bearer $(cat ~/.agentmemory/secret)" http://localhost:3111/agentmemory/health
```
**書き込みリクエストの規則。** REST API とビューワーへの `POST`、`PUT`、`PATCH`、`DELETE` のリクエストは、ボディを伴う場合は常に `Content-Type: application/json`(`charset` パラメータがあっても構いません)を送る必要があり、`Origin` ヘッダーが存在する場合は、設定された REST またはビューワーのポートのループバックオリジンであるか、`VIEWER_ALLOWED_ORIGINS`(カンマ区切り、例: `https://memory.example.com`)に列挙されている必要があります。`Origin` ヘッダーを送らないクライアント(CLI、hooks、MCP、curl、サーバー間通信)は影響を受けません。ビューワーは自分自身のオリジンも受け付けます。
**ファイルパス。** ファイルを読み書きするエンドポイント(`/compress-file`、`/replay/import-jsonl`、`/graph/import-graphify`)は、`~/.agentmemory` 配下、インスタンスのデータディレクトリ配下、または `AGENTMEMORY_IMPORT_ROOT` に列挙されたディレクトリ配下(複数指定は `:` 区切り、Windows では `;`)のパスのみを受け付けます。`/replay/import-jsonl` は、デフォルトの `~/.claude/projects` も受け付けます。`/obsidian/export` は `AGENTMEMORY_EXPORT_ROOT` の中、`/migrate` は `~/.agentmemory` の中に留まります。シンボリックリンクは、各チェックの前に解決されます。
**シークレットのスクラビング。** API キー、ベアラートークン、PEM 秘密鍵ブロック、URL に埋め込まれた認証情報(`scheme://user:password@host`)は、すべての書き込み経路(観測、remember、evolve、slots、レッスン、アクション、スケッチ、シグナル、チェックポイント、インポート、jsonl リプレイ、mesh sync、チーム共有、圧縮・要約の出力、クリスタル、グラフノード)で、テキストが保存される前にマスクされます。
主要エンドポイント
| メソッド | パス | 説明 |
|--------|------|-------------|
| `GET` | `/agentmemory/health` | ヘルスチェック(常に公開) |
| `GET` | `/agentmemory/status` | 何が問題で、どう直すか(ブラウザには HTML、それ以外には JSON) |
| `GET` | `/agentmemory/viewer/snapshot` | ビューワーが表示するすべてを 1 レスポンスで |
| `POST` | `/agentmemory/session/start` | セッション開始 + コンテキスト取得 |
| `POST` | `/agentmemory/session/end` | セッション終了 |
| `POST` | `/agentmemory/observe` | 観測のキャプチャ(配送の詳細は下記のキャプチャ配送を参照) |
| `GET` | `/agentmemory/capture` | キャプチャの受信箱、デッドレター、オフラインスプール |
| `POST` | `/agentmemory/capture/retry` | デッドレターになったキャプチャを再試行 |
| `POST` | `/agentmemory/capture/drain` | ローカルのオフラインスプールを今すぐ送信 |
| `POST` | `/agentmemory/smart-search` | ハイブリッド検索 |
| `POST` | `/agentmemory/context` | コンテキストを生成 |
| `POST` | `/agentmemory/remember` | 長期メモリに保存 |
| `POST` | `/agentmemory/forget` | 観測を削除 |
| `POST` | `/agentmemory/enrich` | ファイルコンテキスト + メモリ + バグ |
| `GET` | `/agentmemory/profile` | プロジェクトプロファイル |
| `GET` | `/agentmemory/export` | 全データをエクスポート |
| `POST` | `/agentmemory/import` | JSON からインポート |
| `POST` | `/agentmemory/graph/query` | ナレッジグラフ照会 |
| `POST` | `/agentmemory/graph/compact` | 肥大化したグラフの来歴を整理 |
| `POST` | `/agentmemory/team/share` | チームと共有 |
| `GET` | `/agentmemory/audit` | 監査証跡 |
完全なエンドポイント一覧: [`src/triggers/api.ts`](../src/triggers/api.ts)
**キャプチャの配送。** hooks は各観測を `eventId` 付きで 1 回だけ `POST /agentmemory/observe` に送信します。これは、ペイロードに id がある場合(例えば Claude Code の `tool_use_id`)はその呼び出しに対するホスト自身の id であり、そうでない場合はセッション、hook のタイプ、ツール名、入力、出力、ホストのタイムスタンプのハッシュです。サーバーはそのイベントをステートストア内のキャプチャ受信箱に書き込み、観測を保存し、その後受信箱のエントリを削除します。ステータスコードは何が起きたかを表します:
| ステータス | `status` フィールド | 意味 |
|---|---|---|
| `201` | `accepted` | 保存されました。`observationId` は新しい観測です。 |
| `202` | `accepted`(`state: "retrying"`) | 受け付けましたが、保存に失敗しました。サーバーは、再起動後も含めて再試行します。 |
| `200` | `duplicate` | この `eventId` は既に受け付け済みです。`observationId` は既存の観測であり、新たに保存されるものはありません。 |
| `400` / `422` | `rejected` | ペイロードが無効、または保存に完全に失敗しました(そのイベントはデッドレターとして保持されます)。 |
| `503` | `rejected`(`retryable: true`) | 受信箱が満杯です(`AGENTMEMORY_CAPTURE_INBOX_MAX`)。hooks はそのイベントをスプールし、後で送信します。 |
失敗したイベントは、倍々に増えるバックオフで `AGENTMEMORY_CAPTURE_RETRY_INTERVAL_MS`(10 秒)ごとに、`AGENTMEMORY_CAPTURE_MAX_ATTEMPTS`(5)回まで再試行されます。それでも失敗し続けるイベントは受信箱にデッドレターとして残り、`/agentmemory/status` とビューワーの Health ページに表示され、`POST /agentmemory/capture/retry`(`{"eventId": "..."}` または `{"all": true}`)で再試行できます。受け付けられたイベント id は `AGENTMEMORY_CAPTURE_DEDUP_HOURS`(168 時間、最大 `AGENTMEMORY_CAPTURE_EVENTS_MAX` 件)の間記憶されるため、タイムアウトや再起動の後に再生された hook は 1 回だけ保存されますが、それぞれが独自のホスト id を持つ 2 つの別のツール呼び出しは、内容が同一であっても 2 回保存されます。観測が削除される(forget、セッション削除、退避、自動忘却、ストアを置き換えるインポート)とき、そのイベントは観測が削除される前に削除済みとマークされるため、同じウィンドウ内でそのイベントが再生されると重複として応答され、何も保存されません。ステートストアは 2 秒ごとにディスクへ書き込むため、応答済みのイベントが一瞬だけメモリ上にしか存在しないことがあります。これに対応するため、すべての `2xx` の応答には、サーバーの `bootId`(起動ごとに新しくなります)、`acceptedAt`、`durableAfterMs`(ファイルストアでは保存間隔 + 1.5 秒、redis では 1.5 秒。永続化自体は運用者の設定によります)も添えられます。hooks は、そのウィンドウが過ぎるまでイベントをローカルのスプールに残し、別のリクエストなしで後続の呼び出し時に削除します。その時点までに `bootId` が変わっていれば、サーバーは再起動しているので、hook は同じ `eventId` でそのイベントを再送します。ディスクに到達済みのイベントが二重に保存されることはありません。サーバー自身も、起動時と各リトライ間隔ごとにそうしたイベントを送信するため、その後に hook が一切動かなくても再起動で何かが失われることはありません。古い hooks はこの追加フィールドを無視し、古いサーバーに対する新しい hooks は、以前と同様 `2xx` でイベントを破棄します。
サーバーがダウンしている、時間内に応答しない、または 5xx を返す場合、hook はその観測をローカルのスプールファイル `/capture-spool/-.jsonl` に追記します(フォルダは `AGENTMEMORY_CAPTURE_SPOOL_DIR` で上書きできます)。このファイルはあなたのユーザーに非公開(モード 600)で、シークレットはサーバーが行うのと同じ方法でマスクされ、最大 `AGENTMEMORY_CAPTURE_SPOOL_MAX_BYTES`(5 MiB)まで保持し、`AGENTMEMORY_CAPTURE_SPOOL_MAX_AGE_HOURS`(168)より古いエントリを捨てます。満杯になると、新しいエントリは破棄されカウントされ、`/agentmemory/status` がそれを報告します。サーバーが健全なときは、hook はその時間制限内でそのまま exit 0 し、リクエストは追加されません。スプールは次回起動時、およびサーバーに再び到達できた最初の hook によって、エージェントを待たせないバックグラウンドプロセスで送信されます。イベント id がこれを安全にします: タイムアウト前に到達済みの観測が二重に保存されることはありません。`npx @agentmemory/agentmemory capture` はスプールとサーバーの受信箱を表示し、`--drain` はスプールを今すぐ送信し、`GET /agentmemory/capture` は同じ内容を JSON で返します。スプールをオフにするには `AGENTMEMORY_CAPTURE_SPOOL=false` を設定してください。
**グラフの来歴のコンパクション。** 各ナレッジグラフのノードとエッジは、その由来となった最新 32 件の観測の id を保持します。この上限ができる前に書き込まれたストアでは、アクセスの多いノード 1 つあたり数千件の id を持つことがあり、グラフ検索とビューワーが遅くなったり、worker が落ちたりします。agentmemory はこれを自力で修正します: アップグレード後の最初の起動時に、すべてのノード、エッジ、上書きされたエッジ(時系列のグラフ履歴)、キャッシュされたスナップショットをバックグラウンドでこの上限まで、間に一時停止を挟んだ小さなスライスで切り詰めるため、検索、キャプチャ、ビューワーは動作を続けられます。進捗は保存され、再起動後も再開され、完了すると二度と実行されません。`/agentmemory/status` とビューワーの Health ページには、保留中、実行中(現在のスコープと位置とともに)、完了、失敗のいずれかとして表示されます。オフにするには `AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=false` を設定してください。
手動で実行するには `POST /agentmemory/graph/compact` を呼び出してください。すべてのノードとエッジを列挙するのではなく、名前とエッジキーのインデックスを走査するため、再実行しても安全です。id を切り詰めたときは `graph_compact` の監査エントリを書き込みます。
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{}'
```
大規模なストアで、あるいは呼び出しが 504 を返す場合は、分割して実行してください。`scope`(`nodes`、`edges`、または `history`)、`offset`、`limit` を送り、返ってきた `nextOffset` が `null` になるまで呼び出しを繰り返します。これを `nodes`、`edges`、`history` それぞれについて行い、最後に `{"scope":"snapshot"}` を 1 回呼んで終えてください。分割実行はキャッシュされたスナップショットには触れないためです。
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"nodes","offset":0,"limit":200}'
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"snapshot"}'
```
---

```bash
npm run dev # Hot reload
npm run build # Production build
npm test # 2,500+ tests
npm run test:integration # API tests (requires running services)
```
**前提条件:** npm/npx 付きの Node.js >= 20。[iii-engine](https://iii.dev/docs) v0.22.1 または Docker。自動の macOS/Linux エンジンインストールにも `curl`、POSIX 準拠の `sh`、`tar` が必要です。ネイティブ Windows では、手動でピン留めした `iii.exe`、WSL2、または Docker Desktop を使います。

[Apache-2.0](../LICENSE)


